

Théorie cognitive de l'apprentissage multimédia : les principes de Mayer
La théorie cognitive de l'apprentissage multimédia de Mayer en clair : ses trois hypothèses, ses 15 principes et leurs tailles d'effet, les situations où ils aident, et deux modèles gratuits.

La théorie cognitive de l'apprentissage multimédia est l'explication que donne Richard Mayer de la façon dont on apprend à partir de mots et d'images. Elle repose sur trois hypothèses : nous traitons le verbal et le visuel par deux canaux distincts, chaque canal ne retient que peu d'éléments à la fois, et apprendre exige un traitement actif.
- La liste des principes de conception de Mayer est passée de 7 en 2001 à 12 en 2009, puis à 15 dans l'édition 2021 de son ouvrage.
- Trois des 15 principes de Mayer concluent qu'un ajout pourtant populaire, comme le visage de l'orateur à l'écran ou la réalité virtuelle, n'apporte pas de bénéfice systématique.
- Le principe de redondance déconseille d'afficher à l'écran le texte de la narration à côté d'un visuel déjà commenté, surtout dans les modules au rythme rapide.
- Les principes de Mayer sont les plus utiles pour les débutants, les contenus complexes et les modules qui défilent sans pause. Ils peuvent en revanche gêner les apprenants expérimentés.
- Sur un échantillon de 112 demandes de formation saisies dans Coursebox, jusqu'à 57 réclamaient des séquences courtes et 7 au plus une narration.
Cinq questions de préparation pour une formation. Cette liste de contrôle n'a pas été validée. Examinez chaque réponse séparément : le total ne suffit pas à établir que la formation est cohérente, prête à être déployée ou efficace.

Passez du storyboard à un cours interactif en quelques minutes
Première semaine au laboratoire. Un technicien fraîchement recruté suit un diaporama commenté sur la centrifugeuse de paillasse. La voix off lit mot pour mot un paragraphe affiché à l'écran, une photo d'illustration de scientifique souriant occupe la moitié de la diapositive, une musique de fond couvre le commentaire, et le seul schéma qui montre où placer les tubes se trouve sur une autre diapositive que les explications qui s'y rapportent. Une fois le diaporama terminé, le technicien charge toujours le rotor sans l'équilibrer.
Je conçois des formations chez Coursebox, éditeur d'un logiciel d'ingénierie pédagogique qui transforme le cahier des charges d'un concepteur en plan de formation, avec pages, images, vidéos et mises en situation. La place des mots et des images à l'écran fait donc partie de mon quotidien. La théorie cognitive de l'apprentissage multimédia de Richard Mayer explique pourquoi ce diaporama a manqué sa cible, et ses principes disent comment la corriger. Au programme : la théorie, les 15 principes et les données qui étayent chacun d'eux, les situations où ils pèsent le plus, puis la même formation sur la centrifugeuse, repensée à leur lumière.
Qu'est-ce que la théorie cognitive de l'apprentissage multimédia ?
La théorie cognitive de l'apprentissage multimédia est l'explication que donne Richard Mayer de la façon dont on apprend à partir de mots et d'images. Elle repose sur trois hypothèses : nous traitons le verbal et le visuel par deux canaux distincts, chaque canal ne retient que peu d'éléments à la fois, et apprendre exige un traitement actif.
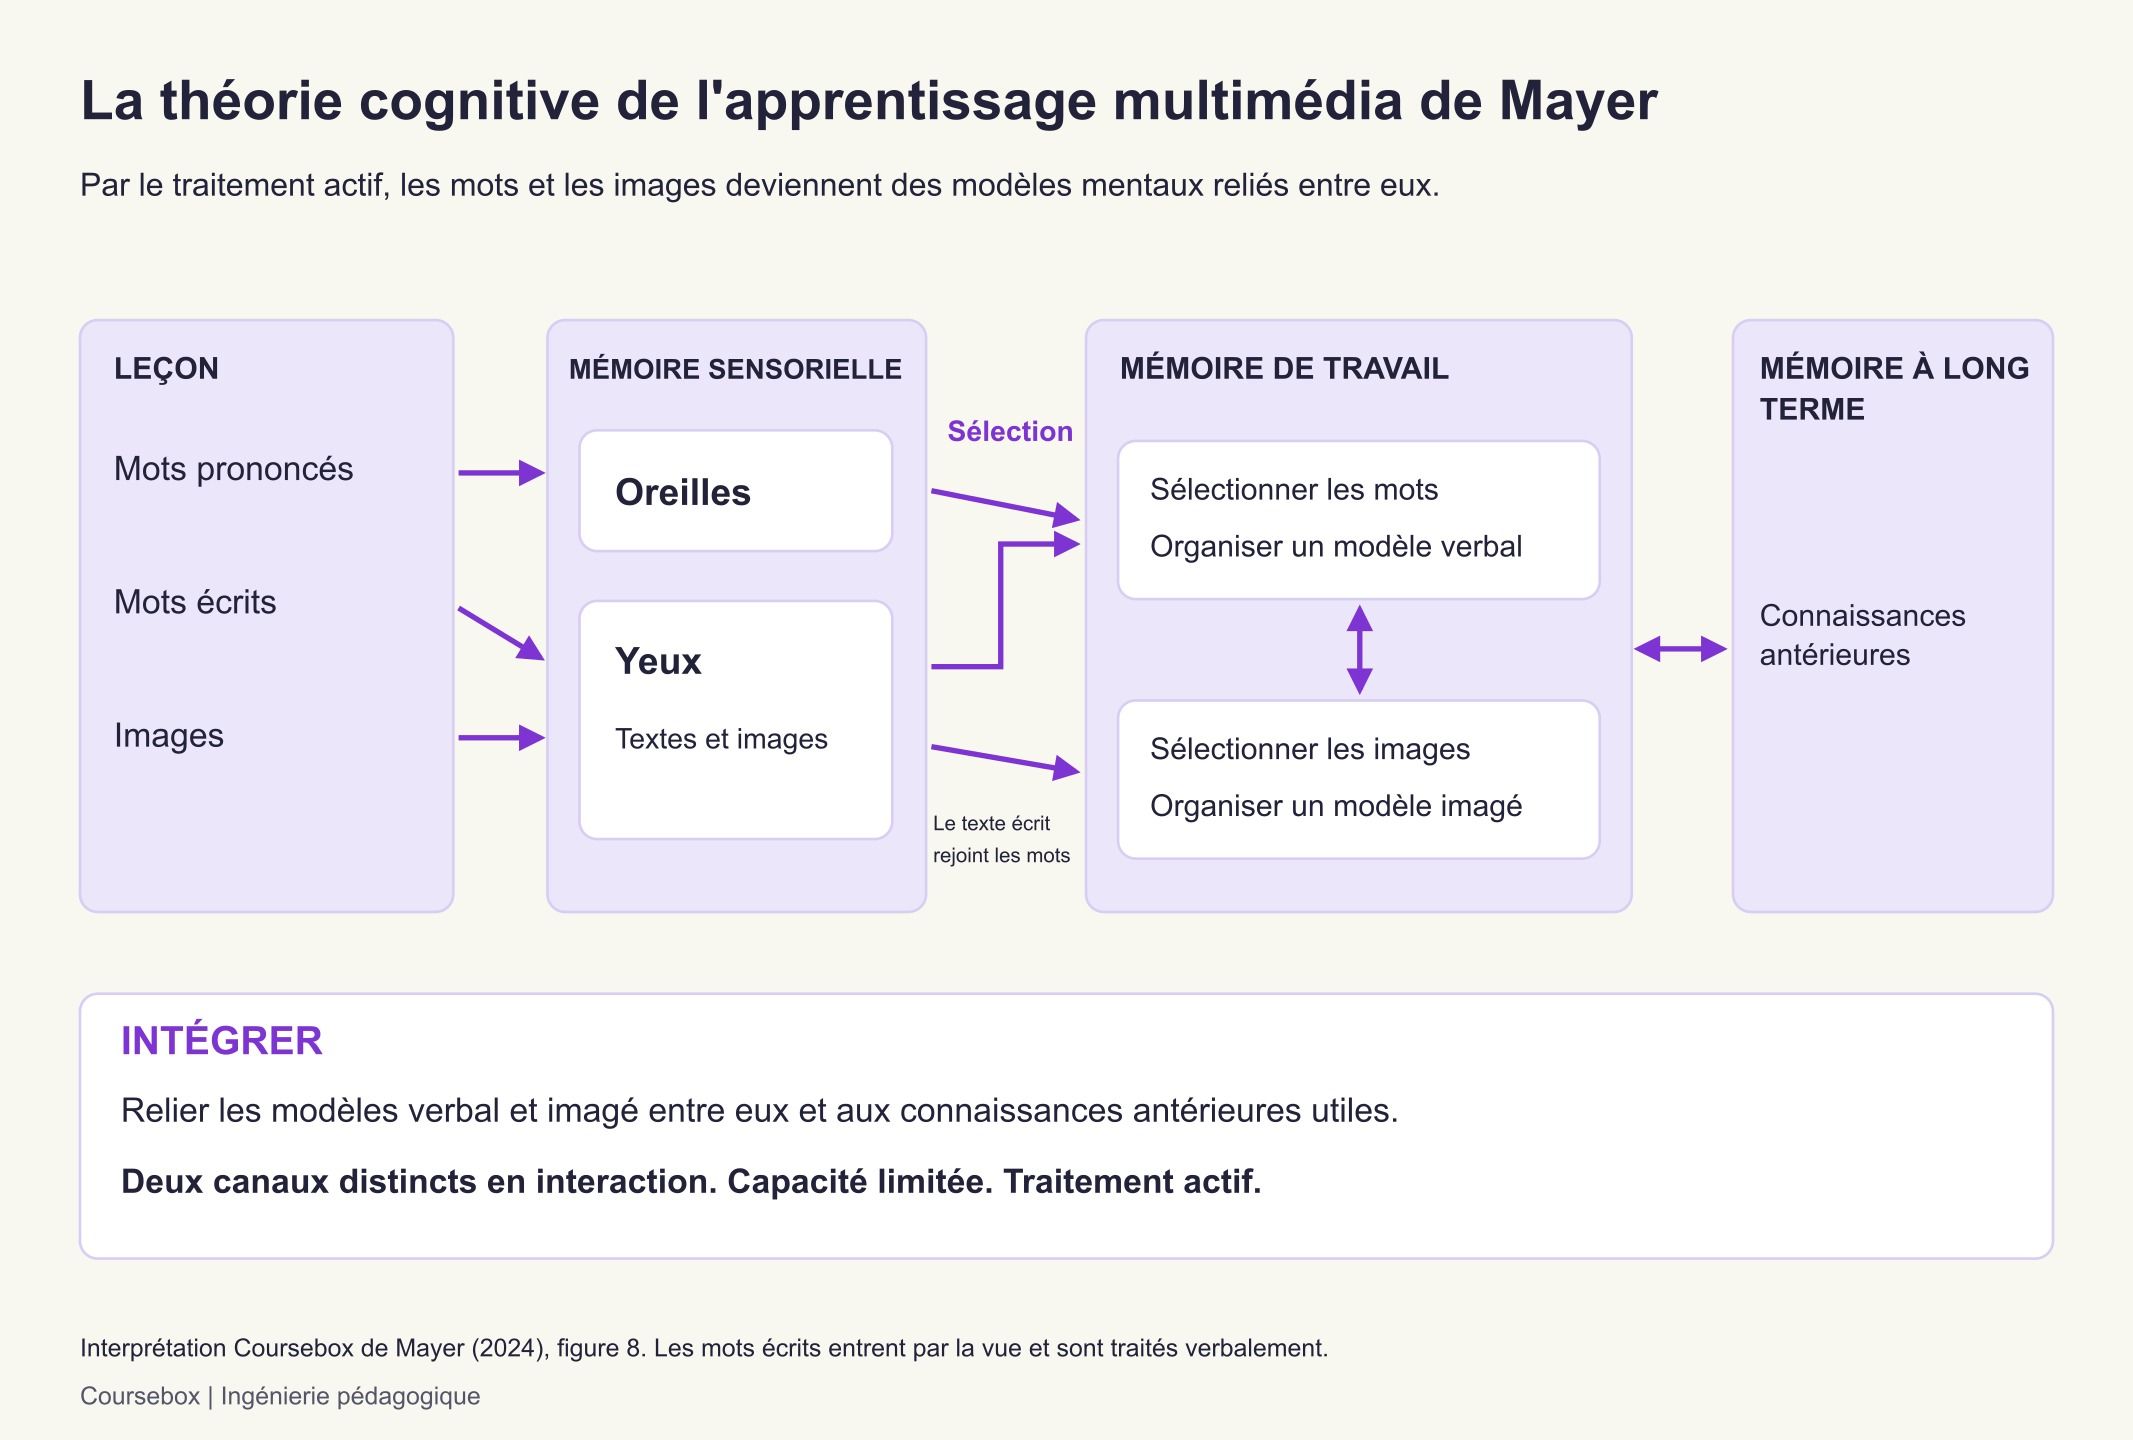
Voir le schéma en grand format
La théorie s'applique à ce que Mayer appelle un message pédagogique multimédia : « un contenu pédagogique composé de mots (texte écrit ou parlé, par exemple) et de visuels (illustrations, photos, animations, vidéo ou réalité virtuelle immersive, par exemple) destiné à favoriser l'acquisition de nouvelles connaissances ou compétences chez un apprenant » (traduction libre). Cette définition est tirée de la synthèse en accès libre que Mayer a publiée en 2024 sur le passé, le présent et l'avenir de sa théorie : c'est la présentation qu'en donne aujourd'hui son auteur. Un diaporama avec voix off, une vidéo explicative, une page de module e-learning avec un schéma ou un manuel imprimé illustré entrent tous dans ce cadre. Mayer cherche à expliquer comment on apprend des « contenus académiques » à partir de ces supports, ce qu'il mesure par des tests de transfert, qui demandent de réutiliser ce qu'on a appris dans des situations nouvelles.
Les trois hypothèses, formulées par Mayer (2024, p. 17) :
- Deux canaux : « l'être humain dispose de canaux distincts mais interconnectés pour traiter l'information auditive/verbale et l'information imagée/visuelle ».
- Capacité limitée : « l'être humain ne peut traiter que quelques éléments d'information à la fois dans chaque canal ».
- Traitement actif : « l'apprentissage significatif se produit lorsque l'apprenant effectue un traitement cognitif approprié pendant l'apprentissage », c'est-à-dire qu'il sélectionne ce à quoi il prête attention, l'organise et le relie à ses connaissances antérieures.
Le modèle de Mayer traduit ces hypothèses en un système comprenant trois registres de mémoire et cinq processus. Les mots et les images entrent par les oreilles et les yeux dans la mémoire sensorielle. L'apprenant sélectionne une partie des mots et des images pour les traiter en mémoire de travail, organise les mots en un modèle verbal et les images en un modèle imagé, puis relie ces deux modèles entre eux et aux connaissances antérieures issues de la mémoire à long terme. Un détail explique bien des diapositives ratées : les mots écrits entrent par les yeux, si bien que le texte à l'écran dispute le canal visuel à l'image, alors même qu'il est verbal.
Comme la mémoire de travail est limitée, Mayer distingue trois sollicitations qui pèsent sur elle pendant un module (2024, p. 18) :
- Le traitement extrinsèque ne sert aucun objectif pédagogique et découle d'une conception maladroite, par exemple des images ou des mots hors sujet.
- Le traitement essentiel est le travail nécessaire pour se représenter le contenu lui-même. Il augmente avec la complexité du contenu pour l'apprenant concerné.
- Le traitement génératif est l'effort fourni pour donner du sens au contenu. Il dépend de la motivation de l'apprenant.
À chaque sollicitation correspond un objectif de conception : réduire le traitement extrinsèque, gérer le traitement essentiel et favoriser le traitement génératif. Chaque principe sert l'un de ces trois objectifs. Les principes sont des points de contrôle à appliquer ensemble, et non des étapes à suivre dans l'ordre.
Les 15 principes en un coup d'œil
Ce tableau adapte la synthèse que Mayer donne lui-même des 15 principes dans la troisième édition de son ouvrage Multimedia Learning (2021), reprise dans le tableau 6 de sa synthèse de 2024 sous licence CC BY 4.0. Les tailles d'effet sont des médianes calculées sur les expériences menées dans le laboratoire de Mayer, exprimées en d de Cohen. Selon la règle empirique de Cohen, 0,2 correspond à un petit effet, 0,5 à un effet moyen et 0,8 à un grand effet. La colonne « Nombre de tests » indique combien de comparaisons expérimentales fondent chaque médiane. Les noms des principes sont donnés en français ; Mayer les formule en anglais (coherence, signaling, redundancy, etc.).
| Objectif | Principe | Ce qu'il dit, en termes simples | Taille d'effet (2021) | Nombre de tests |
|---|---|---|---|---|
| Réduire le traitement extrinsèque | Cohérence | Supprimer tout ce qui ne sert pas l'objectif | 0,86 | 19 |
| Réduire le traitement extrinsèque | Signalisation | Ajouter des repères qui font ressortir l'organisation du contenu essentiel | 0,69 | 16 |
| Réduire le traitement extrinsèque | Redondance | Ne pas ajouter de texte écrit qui reprend la narration d'un visuel commenté, quand le module avance vite | 0,10 | 12 |
| Réduire le traitement extrinsèque | Contiguïté spatiale | Placer les mots près des parties de l'image qu'ils décrivent | 0,82 | 9 |
| Réduire le traitement extrinsèque | Contiguïté temporelle | Présenter les mots et les images correspondantes en même temps | 1,31 | 8 |
| Gérer le traitement essentiel | Segmentation | Découper le module en séquences dont l'apprenant maîtrise le rythme | 0,67 | 7 |
| Gérer le traitement essentiel | Pré-entraînement | Présenter d'abord les noms et les caractéristiques des concepts clés | 0,78 | 10 |
| Gérer le traitement essentiel | Modalité | Expliquer un visuel par la narration plutôt que par du texte à l'écran | 1,00 | 19 |
| Favoriser le traitement génératif | Multimédia | Associer mots et images plutôt que d'utiliser les mots seuls | 1,35 | 13 |
| Favoriser le traitement génératif | Personnalisation | Rédiger sur un ton conversationnel | 1,00 | 15 |
| Favoriser le traitement génératif | Voix | Faire la narration avec une voix humaine chaleureuse plutôt qu'une voix de synthèse | 0,74 | 7 |
| Favoriser le traitement génératif | Image | Montrer l'image de l'orateur n'apporte pas de bénéfice systématique | 0,20 | 7 |
| Favoriser le traitement génératif | Incarnation | Si un formateur apparaît à l'écran, qu'il utilise les gestes, le mouvement et le regard | 0,58 | 17 |
| Favoriser le traitement génératif | Immersion | La réalité virtuelle en 3D ne fait pas systématiquement mieux que le même module sur ordinateur | -0,10 | 9 |
| Favoriser le traitement génératif | Activité générative | Amener les apprenants à résumer, expliquer ou s'auto-tester pendant l'apprentissage | 0,71 | 44 |

Étude de cas : formation réglementaire de pharmaciens à Houston
Aux États-Unis, la formation aux bonnes pratiques de fabrication en vigueur (cGMP) est imposée par la réglementation fédérale à toute personne travaillant dans la fabrication pharmaceutique, et sa version standard est un contenu réglementaire très chargé en texte. Des chercheurs de la faculté de pharmacie de l'Université de Houston ont repensé une vidéo de formation cGMP et l'ont testée auprès de pharmaciens de la région de Houston.
- Ce qu'ils ont fait : Ils ont appliqué les principes de Mayer, la théorie de la charge cognitive et d'autres changements de présentation. Le texte à l'écran a été réduit aux points clés, soit environ 90 % de moins que dans la vidéo standard, l'explication est passée dans la narration, les points réglementaires essentiels ont été mis en évidence par une couleur contrastée et un soulignement, et les diapositives intégraient des photos pleine page.
- Données et résultat : Dans une étude croisée randomisée publiée en 2026, 49 pharmaciens ont chacun regardé une vidéo standard et une vidéo repensée dans un ordre aléatoire, avec un test juste après chacune. La version repensée a obtenu 78 % contre 72 % à l'évaluation des connaissances (p = 0,04), et l'effort mental auto-évalué est passé de 3,5 à 2,4.
- Limite : Les deux vidéos portaient sur des sous-parties réglementaires différentes, si bien qu'on ne peut pas totalement séparer l'effet du sujet de celui de la conception. La nouvelle version ajoutait aussi une musique de fond en ouverture et en clôture, ce que le principe de cohérence déconseille. Toutes les mesures ont été prises immédiatement, et personne n'a vérifié la conformité en situation de travail.
- À retenir : Une refonte qui réduit le texte écrit aux points clés, fait passer l'explication dans la narration et met en évidence l'essentiel, parmi d'autres changements, s'est accompagnée d'un gain immédiat modeste et d'une forte baisse de l'effort ressenti. C'est une première étape peu coûteuse pour les vidéos réglementaires chargées en diapositives, à compléter par une vérification de ce que les gens retiennent plus tard.
Qui a élaboré la théorie, et combien compte-t-elle de principes ?
Richard Mayer a élaboré la théorie avec ses collègues à partir d'expériences commencées en 1989. Il est parti de ce qui allait devenir le principe multimédia, selon lequel on apprend mieux avec des mots et des images qu'avec des mots seuls, et a construit la théorie autour de ces résultats. Mayer cite les travaux sur lesquels il s'appuie. Les deux canaux viennent de la théorie du double codage d'Allan Paivio et du modèle de la mémoire de travail d'Alan Baddeley. La capacité limitée s'inspire de George Miller, de Baddeley et de John Sweller, dont Mayer présente la théorie de la charge cognitive comme une théorie concurrente dont il a repris certains éléments. Le traitement actif reflète les travaux de Merlin Wittrock sur l'apprentissage génératif. Mayer détaille ces filiations dans sa synthèse de 2024.
Le nom a mis du temps à se fixer. L'historique dressé par Mayer mentionne un « modèle de l'apprentissage significatif », un « modèle du double codage » et le modèle sélectionner-organiser-intégrer, avant l'apparition du nom « théorie cognitive de l'apprentissage multimédia » dans des articles parus entre 1996 et 2000. Le schéma de référence date de la première édition de Multimedia Learning en 2001, et la théorie a son propre chapitre dans chaque édition de The Cambridge Handbook of Multimedia Learning (2005, 2014 et 2022). Mayer compte aussi parmi les auteurs de la révision de 2001 de la taxonomie de Bloom.
Le nombre de principes dépend de l'édition consultée. Voici les décomptes de Mayer lui-même, tirés des tableaux 3 et 4 de la synthèse de 2024 :
| Édition de Multimedia Learning | Principes | Comparaisons expérimentales | Ce qui a changé |
|---|---|---|---|
| 1re édition, 2001 | 7 | 45 | Multimédia, contiguïté spatiale, contiguïté temporelle, cohérence, modalité, redondance et différences individuelles |
| 2e édition, 2009 | 12 | 93 | Ajout de la signalisation, de la segmentation, du pré-entraînement, de la personnalisation, de la voix et de l'image ; les différences individuelles ne forment plus un principe distinct |
| 3e édition, 2021 | 15 | 201 | Ajout de l'incarnation, de l'immersion et de l'activité générative |
Les « 12 principes de Mayer », la liste la plus souvent citée, viennent de la deuxième édition de 2009 : multimédia, cohérence, signalisation, redondance, contiguïté spatiale, contiguïté temporelle, segmentation, pré-entraînement, modalité, personnalisation, voix et image. Cette liste existe bel et bien, mais elle n'est plus à jour. L'incarnation appartient à l'édition 2021, pas aux douze de 2009. D'autres décomptes circulent aussi : l'article de Mayer paru en 2008 dans American Psychologist résumait 10 principes, une synthèse qu'il a publiée en 2017 dans une revue en retient une autre série de 12, dont l'incarnation mais pas l'image, et le manuel de 2022 couvre 31 principes issus de nombreuses équipes de recherche. Face à une liste, vérifiez toujours de quelle source elle provient.
Quels ouvrages de Mayer lire
- Commencez par la synthèse de 2024 de Mayer, en libre accès, pour la théorie, les quinze principes et la portée des données qui les soutiennent.
- Pour l'e-learning en entreprise, lisez e-Learning and the Science of Instruction de Ruth Colvin Clark et Richard Mayer, cinquième édition (2024). L'ouvrage applique les principes à la conception de formations.
- Pour l'ensemble des données et les conditions limites de chaque principe, lisez Multimedia Learning, troisième édition (2021), publié par Cambridge University Press.
Exemple concret : une formation à la sécurité sur centrifugeuse
Pour montrer les principes en action, je reprends tout au long de ce guide une même formation fictive, celle de la scène d'ouverture. Un laboratoire intègre de nouveaux techniciens, qui doivent apprendre à utiliser sa centrifugeuse de paillasse en toute sécurité. Certains ont un diplôme scientifique, d'autres travaillent dans une langue qui n'est pas leur langue maternelle, mais aucun n'a utilisé ce modèle ni n'a été formé à son alarme. La procédure compte six parties : charger les tubes, les équilibrer, lancer un cycle, l'arrêter, décharger et réagir à une alarme de déséquilibre. Les apprenants disposent de la procédure écrite du laboratoire et du manuel du fabricant, et la formation doit les préparer à un premier cycle supervisé à la paillasse. Le résultat attendu : chaque technicien sait charger un rotor équilibré, lancer et arrêter un cycle en toute sécurité et réagir correctement à l'alarme, sous l'œil d'un responsable à la paillasse.
La formation existante est un diaporama commenté tiré du manuel : des paragraphes entiers à l'écran lus à voix haute, une photo décorative sur la plupart des diapositives, et le schéma du rotor sur une autre diapositive que les étapes qui s'en servent. Une formation sur une centrifugeuse rend visibles la plupart des principes, car elle comporte des éléments à nommer, des étapes dans un ordre fixe, des schémas à légender et une réaction chronométrée à une alarme. Elle pousse aussi la théorie dans ses retranchements, puisque Mayer l'a surtout testée sur des explications du fonctionnement de systèmes, comme la foudre, les freins ou les pompes. Les procédures et les gestes techniques relèvent de l'extrapolation, et c'est à la paillasse qu'on les met à l'épreuve.
Réduire le traitement extrinsèque : cinq principes
Ces cinq principes éliminent le travail qui n'aide pas à apprendre, afin que l'apprenant garde davantage de ressources pour le contenu lui-même.
Principe de cohérence
On apprend mieux quand les éléments superflus sont exclus plutôt qu'inclus. Par éléments superflus, on entend des mots, des images, des sons et des musiques intéressants mais hors sujet. La cohérence ne signifie pas « présenter le contenu clairement », ce qui relève plutôt de la signalisation.
- Ce qu'il dit : Supprimez tout ce qui ne sert pas l'objectif pédagogique.
- Données et limites : Un effet médian de 0,86 sur 19 tests. D'après la synthèse de Mayer de 2009, la cohérence aide sans doute surtout les apprenants dont la mémoire de travail est faible ou qui connaissent peu le sujet.
- Dans la formation sur la centrifugeuse : Supprimez l'historique du fabricant, la musique de fond et les photos d'illustration. Gardez seulement ce dont un technicien a besoin pour charger, lancer, arrêter et réagir.
Principe de signalisation
On apprend mieux quand des repères font ressortir l'organisation du contenu essentiel.
- Ce qu'il dit : Montrez aux apprenants où regarder et comment les éléments s'articulent, avec des titres, un plan, des flèches ou des surlignages.
- Données et limites : Une médiane de 0,69 sur 16 tests, contre 0,52 sur 6 tests en 2008.
- Dans la formation sur la centrifugeuse : Ouvrez sur un écran de synthèse des six parties, gardez le même titre sur tous les écrans d'une même partie, et mettez en évidence le verrou du couvercle et les positions opposées des tubes au moment où la narration les nomme.
Principe de redondance
On n'apprend pas mieux quand du texte écrit s'ajoute à des visuels et à une narration, du moins quand le module avance vite. On le lit souvent comme une interdiction d'associer mots et images, ce qu'il n'est pas.
- Ce qu'il dit : Quand un visuel est déjà expliqué par la narration, n'affichez pas en plus le texte de cette narration à l'écran.
- Données et limites : Une médiane de seulement 0,10 sur 12 tests, et la formulation de 2021 le limite aux modules au rythme rapide. Dans leur article de 2003, Mayer et Moreno ont observé l'inverse en l'absence d'animation : la narration accompagnée du même texte à l'écran aidait. Une méta-analyse de 57 études publiée en 2012 par Adesope et Nesbit a montré que mots parlés et écrits combinés aidaient les apprenants ayant peu de connaissances préalables, dans les contenus au rythme imposé et dans les supports sans images.
- Dans la formation sur la centrifugeuse : Dans l'animation commentée d'un cycle, limitez l'écran à l'animation et à de courtes légendes comme « rotor » et « verrou du couvercle ». Placez le texte complet dans une transcription ou une page de synthèse, pas par-dessus l'animation.
Le principe ne dit ni « utilisez des visuels ou du texte, jamais les deux » ni « ne répétez jamais une information ». Les mots placés près d'une image relèvent du principe de contiguïté spatiale, et l'association de mots et d'images du principe multimédia. Dans l'article de Mayer et Moreno de 2003, l'effet de redondance est défini « dans un sens plus restreint que chez Sweller », comme la suppression d'« une duplication inutile du contenu essentiel » : la narration reprise à l'écrit par-dessus une animation commentée. Un court texte à l'écran, placé à côté de l'élément qu'il nomme, peut encore aider.
Principe de contiguïté spatiale
On apprend mieux quand les mots et les images qui se correspondent sont présentés à proximité les uns des autres plutôt qu'à distance sur la page ou l'écran.
- Ce qu'il dit : Placez chaque légende sur l'élément qu'elle désigne, et chaque explication à côté de l'étape qu'elle décrit.
- Données et limites : Une médiane de 0,82 sur 9 tests dans le laboratoire de Mayer. Une méta-analyse indépendante de 58 comparaisons menée par Schroeder et Cenkci, portant sur 2 426 participants, a trouvé g = 0,63 en faveur des présentations intégrées : un effet plus faible, mais toujours net.
- Dans la formation sur la centrifugeuse : Légendez le rotor, les godets, le verrou du couvercle et le voyant d'alarme directement sur le schéma, pas dans une légende placée en dessous. Affichez le feedback d'une question de quiz à côté de la question, pas sur un écran suivant.
Principe de contiguïté temporelle
On apprend mieux quand les mots et les images qui se correspondent sont présentés simultanément plutôt que successivement.
- Ce qu'il dit : Énoncez chaque étape au moment où l'image la montre, ni avant ni après.
- Données et limites : La plus forte médiane du groupe « traitement extrinsèque », 1,31 sur 8 tests. D'après la synthèse de Mayer de 2009, il pourrait moins s'appliquer quand le module alterne de courtes séquences ou quand l'apprenant contrôle le rythme.
- Dans la formation sur la centrifugeuse : La narration dit « fermez le couvercle jusqu'au déclic du verrou » pendant que l'animation montre le couvercle qui se ferme, et non dans un récapitulatif en fin de séquence.
Gérer le traitement essentiel : trois principes
Certains contenus restent complexes pour un débutant, aussi bien conçus soient-ils. Ces trois principes répartissent cette charge pour qu'elle ne sature pas la mémoire de travail.
Principe de segmentation
On apprend mieux quand un module multimédia est présenté en séquences dont l'apprenant maîtrise le rythme plutôt que d'un seul tenant.
- Ce qu'il dit : Découpez le module en séquences cohérentes et laissez l'apprenant décider quand passer à la suite.
- Données et limites : Une médiane de 0,67 sur 7 tests. Le levier décisif, c'est le contrôle du rythme par l'apprenant. Mayer ne fixe aucune durée de séquence : la règle des « vidéos de moins de dix minutes » ne vient pas de lui. Selon sa synthèse de 2009, la segmentation a le plus de chances d'aider quand le contenu est complexe, que la présentation va vite et que l'apprenant est novice.
- Dans la formation sur la centrifugeuse : Une courte séquence par écran, chacune terminée par un bouton « Continuer ». C'est la même idée qui sous-tend la plupart des vidéos de microlearning.

Étude de cas : éducateurs en nutrition dans 18 États et territoires américains
Aux États-Unis, l'Expanded Food and Nutrition Education Program (EFNEP) emploie des éducateurs paraprofessionnels qui forment les familles à faibles revenus à la nutrition. Répartis dans de nombreux États, avec des niveaux d'études très variés, ils ne suivaient pas de formation commune : elle changeait d'un État à l'autre.
- Ce qu'ils ont fait : Une chercheuse de l'Université d'État du Colorado a conçu une formation en ligne sur la nutrition prénatale composée de quarante courtes vidéos, en appliquant les principes multimédia, de modalité, de cohérence, de segmentation et de personnalisation, avec un modèle d'ingénierie pédagogique plus large et des vidéos de jeux de rôle. Le narrateur s'exprimait sur un ton conversationnel, et la conception écartait toute musique de fond décorative.
- Données et résultat : Dans une étude doctorale de 2016, 139 éducateurs de 18 États et territoires ont été affectés par État soit à la formation, soit à une liste d'attente, et 131 ont été analysés (67 et 64). Après la formation, 92 % du groupe formé atteignaient la maîtrise au test de connaissances contre 65 % du groupe en attente, et 95 % contre 75 % à un test de mises en situation qui demandait de repérer de mauvaises pratiques pédagogiques dans des vidéos.
- Limite : Le groupe de comparaison n'avait reçu aucune formation : l'étude montre donc que la formation a fonctionné, pas que les principes de Mayer expliquent le gain. Les pratiques pédagogiques n'ont pas été observées, le sentiment d'efficacité personnelle était auto-déclaré, et la cohérence interne des tests était faible.
- À retenir : Pour des équipes dispersées et à temps partiel, une formation en ligne en courtes vidéos a amené la plupart des participants à la maîtrise, contrairement à leurs pairs non formés. Évaluez le jugement avec des mises en situation, pas seulement la mémorisation.
Principe de pré-entraînement
On apprend mieux d'un module multimédia quand on connaît déjà les noms et les caractéristiques des concepts clés. Le pré-entraînement est un choix de conception, pas l'affirmation que les apprenants doivent déjà maîtriser les bases.
- Ce qu'il dit : Présentez les éléments et les termes avant le module qui montre comment ils fonctionnent ensemble.
- Données et limites : Une médiane de 0,78 sur 10 tests.
- Dans la formation sur la centrifugeuse : Une page « Découvrir la centrifugeuse » vient en premier, avec un schéma légendé qui nomme le rotor, les godets ou porte-tubes, le verrou du couvercle, le panneau de commande et l'alarme de déséquilibre. La procédure peut ensuite y faire référence sans s'interrompre pour les expliquer.
Principe de modalité
On apprend mieux avec des visuels et une narration qu'avec des visuels et du texte à l'écran. Modalité et redondance sont deux règles différentes. La modalité compare la narration au texte écrit placé à côté d'un visuel. La redondance pose la question d'ajouter ou non du texte écrit en plus de la narration.
- Ce qu'il dit : Quand un visuel demande une explication, dites-la au lieu de l'écrire.
- Données et limites : Une médiane de 1,00 sur 19 tests, et en 2008 Mayer écrivait que c'est le principe « le mieux étayé par les données parmi tous ceux que nous avons étudiés ». Hors de son laboratoire, l'effet est plus faible, et dans une étude en classe menée par Harskamp et ses collègues, rapportée par de Jong, il disparaissait chez les apprenants qui prenaient leur temps. La synthèse de Mayer de 2009 ajoute que l'écrit peut convenir aux modules riches en termes techniques et en symboles, ainsi qu'aux apprenants dont la langue de formation n'est pas la langue maternelle.
- Dans la formation sur la centrifugeuse : Commentez l'animation d'un cycle, et laissez les termes techniques, comme le réglage de vitesse, écrits à côté du panneau de commande, où le personnel qui travaille dans une autre langue que la sienne peut les lire.
Le principe de modalité s'applique à tous les apprenants. Il ne dit rien des « apprenants auditifs » ou des « apprenants visuels ». Dans son article de 2008 paru dans American Psychologist, Mayer rejette l'argument selon lequel le texte écrit permettrait aux « personnes qui préfèrent lire » de lire pendant que d'autres écoutent. Son propre laboratoire a testé l'idée d'apprenants verbaux et visuels : la synthèse de Pashler et ses collègues publiée en 2008 rapporte que Massa et Mayer n'ont trouvé aucun résultat étayant l'intérêt d'adapter la formation aux préférences, sur près de 20 mesures de différences individuelles. L'ensemble des données sur les styles d'apprentissage va dans le même sens.
Favoriser le traitement génératif : sept principes
Ces sept principes incitent l'apprenant à fournir l'effort nécessaire pour donner du sens au contenu.
Principe multimédia
On apprend mieux avec des mots et des images qu'avec des mots seuls.
- Ce qu'il dit : Ajoutez une image pertinente aux mots. Une image décorative, elle, enfreint le principe de cohérence.
- Données et limites : La plus forte médiane des 15, 1,35 sur 13 tests. D'après la synthèse de Mayer de 2009, il s'applique sans doute plus fortement aux apprenants qui ont peu de connaissances préalables et ont besoin d'aide pour relier mots et images.
- Dans la formation sur la centrifugeuse : Un schéma du rotor montrant quatre tubes en positions opposées, à côté des mots qui expliquent l'équilibrage.
Principe de personnalisation
On apprend mieux d'un module multimédia quand les mots adoptent un ton conversationnel plutôt que soutenu.
- Ce qu'il dit : Adressez-vous directement à l'apprenant et écrivez comme un collègue l'expliquerait.
- Données et limites : Une médiane de 1,00 sur 15 tests. Selon les synthèses de Mayer, il fonctionne sans doute mieux avec les débutants et sans excès, et peut ne pas s'appliquer aux modules longs. Un essai randomisé de 2024 mené auprès de pharmaciens, de médecins et de professionnels de santé en pratique avancée a ajouté personnalisation et incarnation à un module de 30 minutes, sans différence de connaissances (d de Cohen de 0,02), même si les apprenants avaient remarqué ces éléments.
- Dans la formation sur la centrifugeuse : « Placez votre deuxième tube juste en face du premier » plutôt que « Les tubes doivent être disposés en positions opposées ».
Principe de la voix
On apprend mieux quand la narration est faite par une voix humaine chaleureuse plutôt que par une voix de synthèse.
- Ce qu'il dit : Confiez la narration à une voix humaine chaleureuse plutôt qu'à une voix de synthèse.
- Données et limites : Une médiane de 0,74 sur 7 tests, et le principe figurait parmi les recherches préliminaires en 2009. Les sources que j'ai consultées ne testent pas les voix générées par IA actuelles : le principe ne permet donc pas de dire si une voix de synthèse donnée est suffisamment bonne.
- Dans la formation sur la centrifugeuse : Faites écouter la narration à un ou deux techniciens avant le lancement et remplacez toute voix qu'ils ont du mal à suivre.
Principe de l'image
On n'apprend pas forcément mieux d'un module multimédia quand l'image de l'orateur est ajoutée à l'écran.
- Ce qu'il dit : Un orateur filmé en plan serré n'améliore pas systématiquement l'apprentissage. Ce n'est pas pour autant une interdiction.
- Données et limites : Une médiane de 0,20 sur 7 tests. Le chapitre de Mayer dans le manuel de 2014 faisait état de 14 tests, dont la moitié avec des effets négatifs ou négligeables.
- Dans la formation sur la centrifugeuse : Pendant la procédure, gardez l'écran sur la centrifugeuse plutôt que sur le visage du formateur.
Principe d'incarnation
On apprend plus en profondeur quand un formateur à l'écran fait preuve d'une forte incarnation (gestes, déplacements, contact visuel) plutôt que d'une faible incarnation. Ce principe est apparu dans l'édition 2021.
- Ce qu'il dit : Si un formateur apparaît à l'écran, il doit montrer du doigt et regarder ce que l'apprenant doit voir.
- Données et limites : Une médiane de 0,58 sur 17 tests. Le principe décrit la façon dont un formateur apparaît à l'écran, pas s'il doit apparaître, et l'essai de 2024 auprès de professionnels de santé n'a trouvé aucune différence significative de connaissances lorsqu'il était ajouté en même temps que la personnalisation.
- Dans la formation sur la centrifugeuse : Si le responsable du laboratoire présente la réaction à l'alarme face caméra, il montre le voyant d'alarme et le bouton d'arrêt au moment où il les nomme.
Principe d'immersion
On n'apprend pas forcément mieux en réalité virtuelle immersive en 3D qu'avec la présentation équivalente en 2D sur ordinateur. Ce principe est apparu dans l'édition 2021.
- Ce qu'il dit : La réalité virtuelle n'améliore pas à elle seule l'apprentissage par rapport au même module sur écran.
- Données et limites : Une médiane de -0,10 sur 9 tests, légèrement en faveur de la version sur ordinateur.
- Dans la formation sur la centrifugeuse : Une animation sur ordinateur et un cycle supervisé sur la vraie centrifugeuse, sans casque de réalité virtuelle.
Principe d'activité générative
On apprend mieux quand on est guidé pour mener des activités d'apprentissage génératives pendant l'apprentissage. Ce principe, apparu dans l'édition 2021, est celui qui repose sur le plus grand nombre de tests.
- Ce qu'il dit : Faites travailler activement les apprenants sur le contenu : le résumer, se l'expliquer ou s'auto-tester.
- Données et limites : Une médiane de 0,71 sur 44 tests. Fiorella et Mayer (2016) décrivent huit activités : résumer, cartographier, dessiner, imaginer, s'auto-tester, s'auto-expliquer, enseigner à d'autres et exécuter les gestes correspondant au contenu.
- Dans la formation sur la centrifugeuse : Après la séquence sur l'équilibrage, les apprenants choisissent où placer le quatrième tube et expliquent pourquoi. La partie sur l'alarme se termine par une courte mise en situation où ils décident quoi faire et dans quel ordre. Les idées de modules e-learning interactifs trouvent leur place ici.
Concrètement, je regarde un écran et je me pose quatre questions d'un coup : qu'est-ce qui pourrait disparaître (cohérence), où le regard doit-il se poser (signalisation), les mots sont-ils à côté de l'image (contiguïté spatiale) et la narration est-elle aussi écrite (redondance). Un seul passage repère des problèmes qu'une lecture principe par principe laisse échapper.
Les principes reposent-ils sur des données solides ?
Les principes reposent sur plus de 200 expériences, mais beaucoup portaient sur des modules courts testés dans le laboratoire de Mayer, et plusieurs effets diminuent à mesure que les données s'accumulent. Gardez trois points en tête avant de présenter ces chiffres à vos parties prenantes.
Premièrement, trois des 15 principes concluent qu'un ajout populaire n'apporte pas de bénéfice systématique : le texte écrit ajouté à des visuels commentés (0,10, et seulement pour les modules au rythme rapide), l'image de l'orateur (0,20) et la réalité virtuelle (-0,10).
Deuxièmement, certains effets ont diminué à mesure que les données augmentaient.
Les sources que j'ai consultées n'expliquent pas pourquoi l'effet de redondance a baissé, et je ne m'aventurerai donc pas à le deviner. L'effet de modalité suit la même tendance hors du laboratoire de Mayer. Une réanalyse publiée en 2012 par Reinwein a doublé le corpus de données d'une méta-analyse antérieure de Ginns, qui avait trouvé d = 0,72 sur 43 effets.
Troisièmement, des synthèses indépendantes confirment toujours le cœur de la théorie. Dans une revue de revues publiée en 2022 par Noetel et ses collègues, le résumé des auteurs fait état de 29 revues couvrant 1 189 études et 78 177 participants, avec les bénéfices les plus importants pour la contiguïté temporelle et spatiale et la signalisation. Le même résumé indique qu'une bonne conception comptait davantage pour les contenus complexes et dans les situations au rythme imposé, comme les cours magistraux, que dans celles où les apprenants progressent à leur propre rythme.
Servez-vous des données pour repérer les changements de conception à tester, en particulier des liens plus clairs entre légendes, images et narration. Les tailles d'effet résument des comparaisons expérimentales différentes : ce n'est ni un classement de solutions interchangeables, ni une prédiction pour votre formation. Vérifiez les conditions limites qui vous concernent et testez la nouvelle version avec vos apprenants.
Dans quels cas les principes de Mayer aident-ils le plus ?
Dans sa synthèse de 2024, Mayer écrit que chaque principe a des conditions limites : « pour qui le principe s'applique, pour quel type de leçon il s'applique, et dans quelles circonstances ». Trois conditions reviennent sans cesse.
- L'apprenant découvre le sujet. Le principe des différences individuelles de la première édition affirmait que les effets de la conception sont plus forts chez les apprenants qui connaissent peu le sujet, qui ne peuvent pas combler les lacunes à partir de ce qu'ils savent déjà.
- Le contenu est complexe pour cet apprenant. La segmentation et la modalité aident surtout quand il y a beaucoup d'éléments à garder en tête en même temps.
- Le module impose son propre rythme. Une vidéo qui défile sans pause ou un webinaire en direct ne laisse pas le temps de relire ni de revenir en arrière. Quand les apprenants contrôlent le rythme, les effets de la conception observés dans les études sont plus faibles.
L'inverse est vrai aussi. Dans un article de 2003, Kalyuga et ses collègues ont baptisé l'effet de renversement lié à l'expertise : « des techniques pédagogiques très efficaces avec des apprenants novices peuvent perdre leur efficacité, voire avoir des conséquences négatives, lorsqu'elles sont utilisées avec des apprenants plus expérimentés ». Dans l'un de leurs exemples, des apprentis électriciens novices avaient besoin d'un texte intégré aux schémas de circuits, alors que les plus expérimentés réussissaient mieux avec le schéma seul. La narration peut elle aussi devenir redondante pour les apprenants expérimentés.
Voici comment j'interprète ces conditions pour la formation sur la centrifugeuse. Le tableau est ma synthèse des sources, pas un conseil de Mayer lui-même.
| Situation | Principes à privilégier | Ce qu'on peut alléger |
|---|---|---|
| Nouveaux techniciens, vidéo commentée qui défile sans pause | Pré-entraînement, segmentation, modalité, contiguïté spatiale et temporelle, signalisation | Peu de chose : c'est là que la conception a le plus d'effet |
| Techniciens expérimentés, remise à niveau à leur propre rythme | Cohérence et activité générative | La narration intégrale et les légendes étape par étape dont ils n'ont plus besoin |
| Modules truffés de termes techniques, ou personnel travaillant dans une autre langue que la sienne | Contiguïté spatiale, avec les termes clés écrits à côté de l'image | Les explications de termes nouveaux uniquement à l'oral |
| Apprenants sourds ou malentendants | Sous-titres et transcriptions, plus la contiguïté spatiale | Le principe de redondance, qui ne prime pas sur l'accessibilité |
Proposez toujours des sous-titres synchronisés exacts pour les vidéos commentées préenregistrées. Une transcription est un complément utile, mais elle ne remplace pas des sous-titres synchronisés. Le principe de redondance porte sur des comparaisons pédagogiques précises et ne prime pas sur les besoins d'accessibilité. Utilisez de courtes légendes sur le visuel, des sous-titres que les apprenants peuvent activer et une alternative textuelle adaptée pour l'information visuelle.
Comment utiliser les principes de Mayer pour concevoir ou auditer un module
Partez des apprenants et du mode de diffusion, décidez ensuite de la structure, puis vérifiez chaque écran. Voici l'ordre dans lequel je travaille :
- Identifiez ce que les apprenants savent déjà. Interrogez-les, testez-les ou examinez leur travail, et ne déduisez pas leurs connaissances d'un intitulé de poste. Les connaissances préalables déterminent l'aide qu'apporteront les principes.
- Décidez du déroulement du module. Notez s'il défile sans pause, comme un webinaire ou une vidéo, ou si les apprenants en contrôlent le rythme.
- Présentez les éléments et les termes inconnus avant le module qui s'appuie sur eux, et découpez le contenu en séquences cohérentes, au rythme de l'apprenant, quand le mode de diffusion le permet. Les apprenants qui connaissent déjà les termes n'ont pas forcément besoin d'une page de pré-entraînement séparée.
- Pour chaque écran, concevez ensemble ce que montre l'image et ce que dit la narration. Limitez l'écrit aux légendes et aux termes clés, placés à côté de ce qu'ils désignent.
- Supprimez ce qui ne sert pas l'objectif et signalez ce qui le sert. Retirez images décoratives, musique et digressions, et ajoutez des surlignages ou des titres pour ce que les apprenants doivent remarquer.
- Ajoutez une activité générative entre les séquences. Par exemple une prédiction, une explication ou une courte mise en situation.
- Menez un test pilote, puis mesurez avec du recul. Vérifiez ce que les apprenants savent faire quelques semaines après, pas seulement à la fin du module.
La formation sur la centrifugeuse, écran par écran
| Écran | Avant | Principe | Après |
|---|---|---|---|
| Découvrir la centrifugeuse | Pas de page de présentation ; les termes du manuel apparaissent pour la première fois dans la procédure | Pré-entraînement | Une première page avec un schéma légendé du rotor, des godets, du verrou du couvercle, du panneau de commande et de l'alarme |
| Charger et équilibrer | Un paragraphe sur l'équilibrage et une photo du rotor à part | Contiguïté spatiale et multimédia | Un seul schéma avec les tubes en positions opposées, les légendes sur les éléments et l'explication à côté |
| Lancer un cycle | Le narrateur lit tout le paragraphe écrit par-dessus l'animation | Redondance et modalité | Animation commentée avec de courtes légendes seulement ; le texte complet passe sur une page de synthèse |
| Lancer un cycle | Le couvercle se ferme dans l'animation avant que la narration ne le mentionne | Contiguïté temporelle | La narration nomme chaque étape au moment où l'animation la montre |
| Tous les écrans | Photos d'illustration et musique de fond | Cohérence | Supprimées |
| Arrêter et décharger | Une longue séquence commentée qui défile sans pause | Segmentation | Deux séquences, chacune terminée par un bouton « Continuer » |
| Alarme de déséquilibre | Une diapositive qui liste les actions à mener | Activité générative et signalisation | Une mise en situation où l'apprenant décide de l'ordre des actions, avec le voyant d'alarme mis en évidence |
Passez un module ou une vidéo commentée au crible des 15 principes de Mayer : la question à poser pour chaque écran, les conditions dans lesquelles chaque principe aide le plus, l'audit de la formation sur la centrifugeuse en exemple et des pages d'audit vierges à remplir. Fichier Word modifiable, sans adresse e-mail à fournir.
Ce que contiennent les demandes de formation
Pour voir comment les gens formulent leurs demandes de formations multimédias, nous avons classé un échantillon de demandes saisies dans Coursebox au cours des 90 jours précédant le 7 octobre 2026 : une par personne, depuis des navigateurs en anglais, sans fichier importé, en excluant les réponses aux questions préalables au plan et les doublons de modèles. Un modèle de langage a classé les 266 requêtes restantes, dont 112 étaient des demandes de formation, et nous avons vérifié ses exemples à la main par sondage. Son décompte était généreux : il s'agit donc d'estimations codées par le modèle, et non de plafonds audités ni d'estimations valables pour l'ensemble des utilisateurs de Coursebox.
Jusqu'à la moitié des demandes de formation réclamaient un contenu découpé en modules ou en blocs courts, soit le volet structurel de la segmentation : le découpage.
Environ 28 demandaient des visuels, une vingtaine moins de texte et une douzaine de la vidéo. Les demandes évoquaient le découpage en blocs bien plus souvent que la narration. Si vous rédigez la demande pour un créateur de cours avec IA, précisez quelles explications doivent être commentées sur un visuel, à quoi sert le texte à l'écran et ce qu'il faut laisser de côté. Sinon, ces décisions seront prises à votre place.
Théorie de Mayer et théorie de la charge cognitive
La théorie de Mayer et la théorie de la charge cognitive de John Sweller partagent l'idée d'une mémoire de travail limitée, et Mayer en a repris certains éléments, mais ce sont deux théories distinctes, chacune avec son vocabulaire. La théorie de la charge cognitive décrit la charge que le contenu et la conception imposent à l'apprenant. La théorie de Mayer décrit le traitement que l'apprenant effectue sur les mots et les images, et dans le manuel de 2005 il écrivait que la théorie de la charge cognitive « ne se concentre pas sur les types de processus de traitement de l'information impliqués dans l'apprentissage multimédia ». Les deux ne définissent pas la redondance de la même façon. La version de Mayer est plus étroite, alors qu'en théorie de la charge cognitive toute répétition inutile peut être redondante. Le vocabulaire de Mayer a lui-même évolué : dans son article de 2003, le « traitement essentiel » désignait plutôt le fait de donner du sens au contenu. Tenez-vous au vocabulaire d'une seule théorie par document.
| Critère | Théorie cognitive de l'apprentissage multimédia de Mayer | Théorie de la charge cognitive de Sweller |
|---|---|---|
| Question centrale | Comment apprend-on à partir de mots et d'images associés ? | Comment la charge liée au contenu et à la conception influe-t-elle sur l'apprentissage ? |
| Unité d'analyse | Le traitement effectué par l'apprenant : sélectionner, organiser et intégrer | La charge qui pèse sur la mémoire de travail |
| Notions clés | Traitement extrinsèque, essentiel et génératif | Charge intrinsèque, extrinsèque et pertinente |
| La redondance, c'est | Du texte écrit qui reprend la narration d'un visuel commenté | Toute information inutile pour cet apprenant |
| Idéale pour | Concevoir diapositives, vidéos, narrations et écrans e-learning | Décider du degré de guidage, du nombre d'exemples résolus et de la quantité d'exercices dont les apprenants ont besoin |
Les limites de la théorie
La théorie tient bien en laboratoire. Les questions ouvertes portent sur les formations longues, les situations de travail réelles et l'ampleur des effets.
- La plupart des tests portaient sur des modules très courts. Dans une critique de la recherche sur la charge cognitive publiée en 2010, Ton de Jong relevait que deux études du groupe de Mayer utilisaient des modules d'environ 2,5 et 6 minutes, et que beaucoup de participants à ces recherches n'avaient pas d'intérêt particulier pour le sujet. Dans sa synthèse de 2024, Mayer appelle lui-même à mener des études dans les « cours en ligne et la formation professionnelle ».
- La théorie porte sur les explications académiques. Mayer la décrit comme portant sur des « contenus académiques », et la plupart des tests utilisaient des explications du fonctionnement de systèmes. L'appliquer à des procédures, des gestes techniques ou des attitudes, comme dans la formation sur la centrifugeuse, relève de l'extrapolation.
- Les effets diminuent hors du laboratoire d'origine. La réanalyse de Reinwein a montré que l'équipe de recherche faisait partie des facteurs liés à l'ampleur de l'effet de modalité.
- Les gains immédiats peuvent s'estomper. La plupart des tests ont lieu juste après le module, et la seule étude en milieu professionnel que j'ai trouvée avec un test différé montre que l'écart se resserre.
- Les données en entreprise sont rares. Je n'ai trouvé aucun cas vérifié d'entreprise privée hors du secteur de la santé ayant repensé ses modules e-learning avec les principes de Mayer et mesuré le résultat. Les données publiées en milieu professionnel concernent surtout la santé et les programmes publics.
- D'autres modèles existent. Mayer cite notamment le modèle intégré de compréhension du texte et de l'image de Wolfgang Schnotz.

Étude de cas : infirmiers de bloc opératoire à Singapour
Au centre de chirurgie ambulatoire de l'hôpital Khoo Teck Puat, à Singapour, les infirmiers périopératoires doivent apprendre un protocole de réaction aux complications lors d'une chirurgie de la cataracte. Les diapositives de formation existantes étaient très chargées en texte, et une part croissante de la formation était passée en ligne.
- Ce qu'ils ont fait : Des chercheurs ont conçu des diapositives de cours en ligne fondées sur les principes de redondance, de contiguïté spatiale, de modalité, de segmentation, multimédia, de personnalisation et d'incarnation, avec un agent animé à l'écran, et les ont comparées à des diapositives sous forme de listes à puces avec un minimum de visuels. Les deux cours duraient environ 30 minutes.
- Données et résultat : Dans une prépublication de 2025, 44 infirmiers ont été répartis au hasard en deux groupes de 22. Juste après le cours, le groupe ayant suivi la version repensée a obtenu une médiane de 6,00 contre 4,75 à un test de six questions (p = 0,02). Quatre semaines plus tard, les groupes ne différaient plus significativement (4,50 contre 3,75, p = 0,21).
- Limite : Il s'agit d'une prépublication qui n'a pas été évaluée par les pairs. L'étude est petite et monocentrique, le test ne comptait que six questions, tous les principes ont changé en même temps, et les chiffres de référence publiés sont incohérents. Personne n'a observé les infirmiers au bloc.
- À retenir : Le groupe ayant suivi la version repensée a obtenu de meilleurs résultats immédiatement, mais la comparaison différée n'a pas été concluante. Une différence non significative ne prouve ni une rétention égale ni un oubli égal. Prévoyez une pratique espacée et une remise à niveau pour tout protocole que les équipes doivent retenir.
Appliquer les principes de Mayer dans un créateur de cours avec IA
Le 7 octobre 2026, j'ai soumis à Coursebox la demande de formation sur la centrifugeuse : nouveaux techniciens de laboratoire, les six parties de la procédure, et une conception fondée sur le pré-entraînement, la segmentation, l'association mots et images, la cohérence et la signalisation. C'est notre produit : tenez-en compte en lisant mon avis.
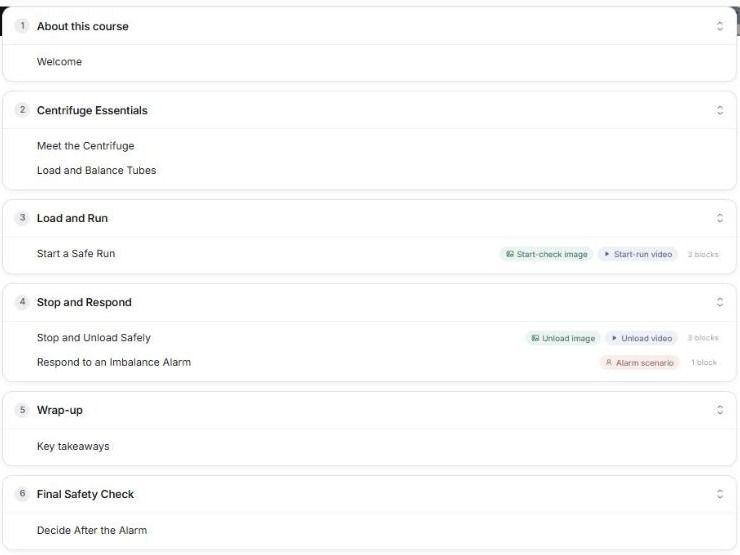
L'essentiel de la structure correspondait à ma demande. La procédure était découpée en pages courtes : Load and Balance Tubes (charger et équilibrer les tubes), Start a Safe Run (lancer un cycle en toute sécurité) et Stop and Unload Safely (arrêter et décharger en toute sécurité). Chacune des deux pages d'étapes comptait trois blocs dans le plan, dont une image et une vidéo. Start a Safe Run comprenait une image Start-check et une vidéo Start-run, et Stop and Unload Safely une image Unload et une vidéo Unload. La réaction à l'alarme est devenue une mise en situation, Respond to an Imbalance Alarm, et le plan se termine par une section Final Safety Check contenant Decide After the Alarm.
Un élément a disparu. Après l'une de mes demandes de révision, le plan ne contenait plus la page de pré-entraînement, celle qui nomme les éléments avant la procédure.
Je l'ai redemandée sous le nom Meet the Centrifuge, au début de la section Centrifuge Essentials et avant Load and Balance Tubes. Après rechargement, Meet the Centrifuge figurait bien en tête de Centrifuge Essentials. Le plan final prévoyait environ 20 minutes de formation, réparties en 6 sections et 8 pages, dont une section d'accueil About this course et une section de conclusion Wrap-up. Cela ne confirme que la structure. Le plan ne montre pas encore de bloc image sur Meet the Centrifuge : vérifiez qu'un schéma légendé des éléments y est ajouté avant que les apprenants ne l'utilisent. Reste à vérifier, dans la formation générée et à la paillasse, que la narration ne répète pas le texte à l'écran et que les techniciens savent utiliser la centrifugeuse en toute sécurité.
Préparez chaque écran d'un module commenté en associant le visuel et la narration : ce que montre l'image, ce que dit la voix off, les légendes à l'écran, le repère visuel et l'action de l'apprenant. Le modèle comprend un exemple rempli pour la formation sur la centrifugeuse et des pages vierges à compléter. Fichier Word modifiable, sans adresse e-mail à fournir.
Mettre les principes de Mayer en pratique
Pourquoi un module qui entasse à l'écran le texte de la narration, des éléments décoratifs et des légendes éparpillées forme-t-il moins bien ? La théorie cognitive de l'apprentissage multimédia de Mayer répond : les mots et les images se disputent une mémoire de travail très limitée. Ses principes indiquent quelles corrections tester, et trois d'entre eux mettent en garde contre des ajouts qui n'apportent pas de bénéfice systématique. Ils pèsent surtout quand les apprenants débutent, que le contenu est complexe et que le module défile sans pause, ce qui décrit bon nombre de formations d'intégration et de formations réglementaires. Pour des collaborateurs expérimentés qui suivent une remise à niveau à leur rythme, attendez-vous à des gains plus modestes et allégez l'accompagnement.
Prenez un module commenté que vous utilisez déjà et auditez un seul écran. Le texte de la narration s'affiche-t-il aussi sur le visuel ? Chaque légende est-elle posée sur l'élément qu'elle désigne ? Qu'est-ce qui pourrait disparaître de l'écran ? Corrigez ces trois points, ajoutez une page qui présente les éléments avant la procédure, puis réévaluez vos apprenants quelques semaines plus tard : un meilleur premier module ne remplace pas la pratique.
Questions fréquentes
La théorie cognitive de l'apprentissage multimédia est l'explication que donne Richard Mayer de la façon dont on apprend à partir de mots et d'images. Elle repose sur trois hypothèses : nous traitons le verbal et le visuel par deux canaux distincts, chaque canal ne retient que peu d'éléments à la fois, et apprendre exige un traitement actif. Elle a donné naissance à 15 principes de conception fondés sur des données probantes, présentés dans l'édition 2021 de son ouvrage Multimedia Learning.
Les 12 principes viennent de la deuxième édition de Multimedia Learning, parue en 2009 : multimédia, cohérence, signalisation, redondance, contiguïté spatiale, contiguïté temporelle, segmentation, pré-entraînement, modalité, personnalisation, voix et image. La troisième édition, en 2021, ajoute l'incarnation, l'immersion et l'activité générative, ce qui porte le total à 15.
Richard Mayer l'a élaborée avec ses collègues à partir d'expériences commencées en 1989, et le nom apparaît dans ses articles entre 1996 et 2000. Il s'est appuyé sur la théorie du double codage d'Allan Paivio, les travaux d'Alan Baddeley sur la mémoire de travail, la théorie de la charge cognitive de John Sweller et l'apprentissage génératif de Merlin Wittrock.
Le principe de modalité dit qu'un visuel s'explique mieux par la narration que par du texte à l'écran. Le principe de redondance dit qu'une fois un visuel commenté, afficher en plus le texte de cette narration à l'écran n'aide pas, du moins dans les modules au rythme rapide. De courtes légendes à côté du visuel restent acceptables selon les deux principes.
Richard Mayer est connu pour la théorie cognitive de l'apprentissage multimédia et ses principes de conception, pour Multimedia Learning et The Cambridge Handbook of Multimedia Learning, ainsi que pour e-Learning and the Science of Instruction, coécrit avec Ruth Colvin Clark. Il est aussi l'un des coauteurs de la révision de 2001 de la taxonomie de Bloom.
Carolina Martin
Carolina est une conceptrice pédagogique très expérimentée avec une expérience dans les startups technologiques. Elle est basée à Sydney et a précédemment conçu des cours aux côtés du fondateur de Coursebox, Travis, dans un emploi antérieur. Elle est passionnée par la création d’expériences d’apprentissage engageantes et apporte la même perspective à l’expérience client. Elle gère notre documentation de support client et les processus de test des produits.

