

Adaptives Lernen: Funktionsweise und Kursdesign Schritt für Schritt
Adaptives Lernen erklärt: was dahintersteckt, was die Forschung zeigt (auch zu Blooms 2-Sigma-Problem) und wie Sie Schritt für Schritt einen adaptiven Kurs gestalten.

Beim adaptiven Lernen ändert sich, was jeder Lernende als Nächstes bekommt, ob Inhalte, Reihenfolge, Tempo, Feedback oder Tests. Grundlage sind Daten zu genau dieser Person, meist ihre Antworten, die entweder nach Regeln eines Instructional Designers oder von einem Softwaremodell ausgewertet werden.
- Die meisten adaptiven Kurse im Unternehmen kommen mit Regeln aus, die ein Instructional Designer selbst schreibt, etwa: Nach zwei richtigen Antworten im Eingangstest entfällt ein Modul. KI ist dafür gar nicht nötig.
- Blooms 2-Sigma-Ergebnis stammt aus 11 Unterrichtseinheiten zu zwei Schulthemen. Spätere Übersichtsarbeiten sehen den Effekt menschlicher Tutoren eher bei 0,4 bis 0,8 Standardabweichungen.
- Intelligente Tutorsysteme verbesserten die Ergebnisse in eigens für den Kurs geschriebenen Tests im Schnitt um 0,73 Standardabweichungen, in standardisierten Tests dagegen nur um 0,13.
- Ein adaptiver Kurs braucht für jedes Lernziel einen Eingangstest und eine schriftliche Regel, die festlegt, wer ein Modul überspringt, wer mehr Unterstützung erhält und wer persönlich betreut wird.
- Von 104 Kursanfragen, die in 90 Tagen in Coursebox eingegeben wurden, verlangte keine einzige, dass Lernende überspringen dürfen, was sie schon können.
Fünf Fragen, etwa eine Minute. Denken Sie beim Antworten an einen konkreten Kurs, den Sie an jeden Lernenden anpassen möchten, zum Beispiel eine Auffrischungsschulung, die erfahrene und neue Mitarbeitende gleichermaßen absolvieren müssen. Das Ganze ist eine Planungshilfe, kein validiertes Messinstrument und keine Zertifizierung.

Vom Storyboard zum interaktiven Kurs in wenigen Minuten
In einem Werk für Tabletten und Kapseln steht die jährliche Auffrischungsschulung zur Guten Dokumentationspraxis an. Der Analyst aus der Qualitätskontrolle mit 20 Jahren Laborerfahrung klickt sich in 15 Minuten durch den 60-minütigen Kurs und besteht das Abschlussquiz mit seinen 10 Fragen. Der Produktionsmitarbeiter, der vor drei Monaten angefangen hat, besteht es ebenfalls. Ein Jahr später stehen im Abweichungsprotokoll des Standorts dieselben vier Dokumentationsfehler wie im Jahr davor. Der Kurs sieht für alle dieselbe Stunde vor und erkennt nicht, wer die Arbeit längst richtig macht und wer nicht.
Genau dieses Problem soll adaptives Lernen lösen. Vorab ein Hinweis in eigener Sache: Ich arbeite als Instructional Designer bei Coursebox. Wir entwickeln KI-Tools für die Mitarbeiterschulung, die aus einem Briefing einen Kurs erstellen. Wo ich unser Produkt getestet habe, sage ich das. Dieser Leitfaden klärt, was adaptives Lernen ist und wie es gesteuert wird, grenzt es von personalisiertem Lernen und Lernstilen ab und rückt Blooms 2-Sigma-Studie mit den Ergebnissen der Metaanalysen zurecht. Nach vier realen Fällen gestalte ich die Auffrischungsschulung Schritt für Schritt als adaptiven Kurs, teste sie in unserem Produkt und stelle zwei kostenlose Vorlagen bereit.
Was ist adaptives Lernen?
Beim adaptiven Lernen ändert sich, was jeder Lernende als Nächstes bekommt: Inhalte, Reihenfolge, Tempo, Feedback oder Tests. Grundlage sind Daten zu genau dieser Person, meist ihre Antworten, die nach Regeln eines Instructional Designers oder von einem Softwaremodell ausgewertet werden.
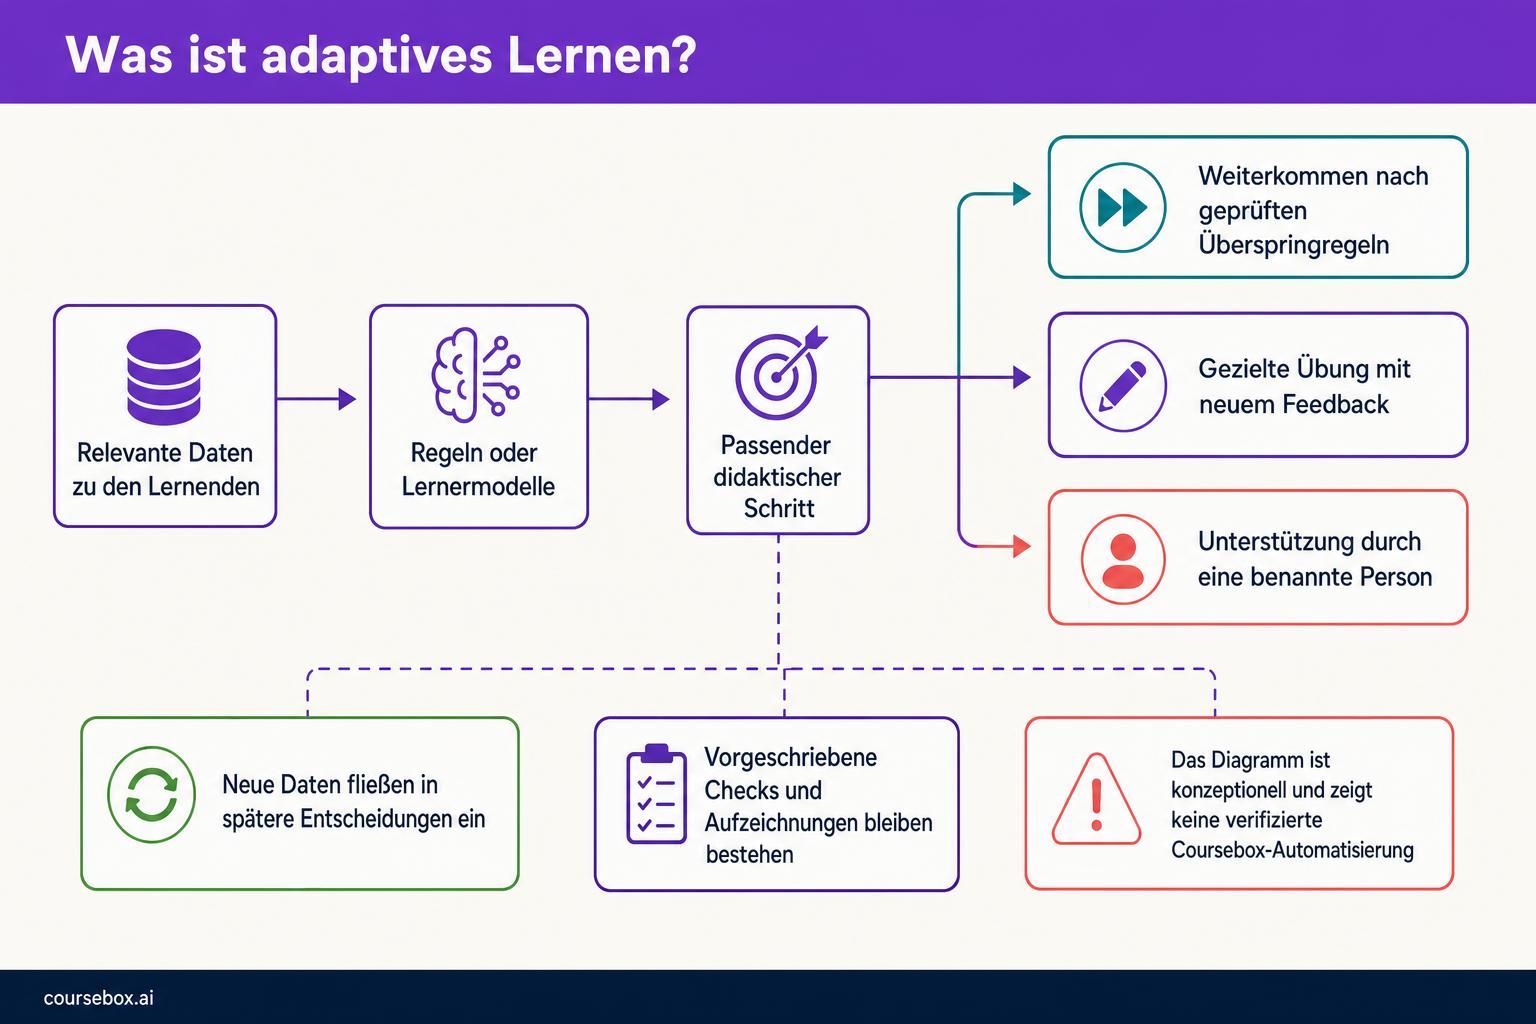
Diagramm in voller Größe ansehen
Einen einzelnen Urheber hat der Begriff nicht, und auf klare Grenzen hat sich das Fachgebiet bis heute nicht geeinigt. Plass und Pawar, die 2020 eine Taxonomie der Adaptivität beim Lernen vorschlugen, setzen genau dort an: „Uns fehlen klare Definitionen der Begriffe Adaptivität und Personalisierung“ (Zitate aus englischen Quellen hier und im Folgenden in eigener Übersetzung). Deshalb lohnt es sich, drei Teile der Definition genauer festzulegen.
- Was sich anpasst. Alles, was Lernenden als Nächstes begegnet: welches Modul kommt, in welcher Reihenfolge und in welchem Tempo, welches Feedback auf eine Antwort folgt und welche Fragen gestellt werden. Die einfachste Form ändert nur das Feedback auf jede Antwort, die aufwendigste baut den gesamten Lernpfad für jede Person neu auf.
- Woran sich der Kurs anpasst. An das, was der Lernende zeigt. In der Praxis ist das vor allem die Leistung, also Antworten auf Fragen, manchmal ergänzt um eine Selbsteinschätzung der eigenen Sicherheit oder die benötigte Zeit. Die Zuweisung nach Jobrolle ist damit verwandt, reagiert aber auf ein Merkmal der Person und nicht auf das, was sie nachweislich kann.
- Wer entscheidet. Bei regelbasierter Adaptivität schreiben Menschen die Regeln im Voraus. Bei algorithmischer Adaptivität schätzt die Software fortlaufend, was jeder Lernende weiß, und wählt daraus den nächsten Schritt. Eine systematische Übersichtsarbeit von 2019 in BMJ Open von Guillaume Fontaine und Kollegen beschreibt die regelbasierte Variante als „gestützt auf die Expertise der Lehrperson, die nach dem Ansatz ‚wenn DIES, dann DAS‘ festlegt, wie die Technologie in einer bestimmten Situation reagiert“.
Es geht ebenso um Effizienz wie um Wirksamkeit: Wer ein Lernziel nachweislich schon erreicht hat, soll den Stoff nicht noch einmal absitzen, und wer es nicht erreicht hat, soll mehr als einen Anlauf bekommen. Die folgende Tabelle zeigt, was sich anpassen lässt und welche Frage sich dabei jeweils für Ihren Kurs stellt.
| Was sich anpasst | Auslöser | Die Frage an Ihren Kurs | So sieht es im Arbeitsalltag aus |
|---|---|---|---|
| Feedback | Die Antwort des Lernenden | Was sollen Lernende nach dieser falschen Antwort sehen? | Ein Lösungsbeispiel genau zu diesem Fehler statt „Falsch, versuchen Sie es noch einmal“ |
| Reihenfolge | Ergebnisse im Eingangstest oder Modulcheck | Wer kann das überspringen, und wer braucht mehr? | Eine erfahrene Analystin überspringt ein Modul nach zwei richtigen Antworten im Eingangstest |
| Tempo und Wiederholung | Richtige und falsche Antworten im Zeitverlauf | Was kommt wieder, und wann? | Eine falsch beantwortete Frage kommt früher wieder als eine richtig beantwortete |
| Tests | Frühere Antworten im selben Test | Welche Frage verrät als Nächstes am meisten über diese Person? | Ein Einstufungstest, der im Verlauf schwierigere oder leichtere Fragen wählt |
| Inhalte nach Rolle | Ein Merkmal des Lernenden, etwa die Tätigkeit | Welche Inhalte braucht diese Rolle? | Die Produktion bekommt Chargenprotokolle, das Labor Laboraufzeichnungen |
An britischen Schulen meint „Adaptive Teaching“ eine Unterrichtspraxis: Die Lehrkraft passt die Stunde an die Schülerinnen und Schüler vor sich an. Adaptives Lernen meint in diesem Leitfaden dagegen, dass sich der Kurs selbst oder das System dahinter für jeden Lernenden anhand von Daten zu dieser Person ändert. Beide Ansätze verfolgen eine ähnliche Idee, unterscheiden sich aber darin, wer die Anpassung vornimmt.
Adaptives Lernen bedeutet auch nicht automatisch KI. Die ältesten adaptiven Werkzeuge waren Regeln, und ein Kurs im Unternehmen kann sich allein mit Regeln anpassen. Ein allgemeiner Chatbot reagiert zwar auf das, was Sie eintippen. Solange aber niemand ein System darum herum baut, führt er weder einen geprüften Nachweis darüber, was Sie beherrschen, noch hat er eine Regel dafür, was Sie als Nächstes bekommen sollten.
Die einfachste Form des adaptiven Lernens ist Feedback, das für jede einzelne Antwort geschrieben wurde. Was das bringt und was nicht, zeigt eine Studie mit Assistenzärzten in Sydney.

Fallstudie: Assistenzärzte in Krankenhäusern in Sydney
Es handelte sich um eine randomisierte Crossover-Studie mit Interns und Residents, die bei NSW Health angestellt waren und freiwillig teilnahmen. Assistenzärzte ordnen Bildgebung an und werten sie aus, haben aber wenig radiologische Ausbildung und kaum Zeit, sich mehr anzueignen.
- Was sie taten: Ein Team der University of New South Wales schrieb fallbasierte Tutorials zu Schädel-CT und Thorax-CT, die „unmittelbares personalisiertes Feedback ... nach jeder Antwort“ gaben. Das ist regelbasierte Adaptivität auf der Ebene der einzelnen Antwort. Die Vergleichsgruppe nutzte Links zu zwei seriösen Radiologie-Websites innerhalb derselben Plattform, sodass auch ihre Zeit erfasst werden konnte. Nach einer Woche tauschten die Gruppen die Themen.
- Belege und Ergebnis: Die randomisierte Crossover-Studie von Wade und Kollegen fand keinen statistisch nachweisbaren Unterschied in den Quizergebnissen zwischen adaptiven Tutorials und Webressourcen (Schädel-CT: 86,4 % vs. 83,5 %, p = 0,33; Vergleich beim Thorax-CT: p = 0,44). Die erfasste Lernzeit mit den Tutorials war kürzer: etwa 31,5 vs. 70,9 Minuten beim Schädel-CT und 21,0 vs. 59,8 Minuten beim Thorax-CT. Einen Äquivalenztest gab es nicht, die nicht signifikanten Unterschiede belegen also keine gleiche Wirksamkeit.
- Einschränkung: Die Ärzte nahmen freiwillig teil, die Teilnehmerzahl sank von 91 auf 50, gemessen wurde ein kurzes Quiz statt der Befundung auf Station, und die Studie führte dasselbe Team durch, das die Tutorials entwickelt hatte.
- Erkenntnis: Die Tutorials brauchten in dieser Studie weniger erfasste Zeit, ohne dass sich ein statistisch nachweisbarer Unterschied im Quizergebnis zeigte. Das spricht dafür, die Effizienz bei einer vergleichbaren Aufgabe näher zu untersuchen. Es rechtfertigt aber nicht das Versprechen, jeder adaptive Kurs bringe den gleichen Lernerfolg in der halben Zeit.
So funktioniert ein adaptives Lernsystem
Für die Analyse eines adaptiven Systems eignen sich drei Funktionen: eine Darstellung des Fachgebiets, Daten zum Lernenden sowie Regeln oder Modelle, die über den nächsten didaktischen Schritt entscheiden. Systeme setzen diese Funktionen unterschiedlich um, und nicht bei allen sind es drei getrennte Softwarekomponenten.
- Das Domänenmodell: der Lernstoff, aufgeteilt in Lernziele oder Fähigkeiten, mit Fragen, die jeweils eines davon prüfen.
- Das Lernermodell: die aktuelle Einschätzung des Systems, was dieser Lernende kann. In einem regelbasierten Kurs kann das so schlicht sein wie „beide Fragen des Eingangstests zu Lernziel 2 richtig beantwortet“.
- Das Instruktionsmodell: die Regeln oder der Algorithmus, die aus dem Lernermodell den nächsten Schritt ableiten.
Systeme unterscheiden sich vor allem darin, wie das Lernermodell aktualisiert wird und wer das Instruktionsmodell geschrieben hat. Die Tabelle reicht von den einfachsten bis zu den komplexesten Mechanismen.
| Mechanismus | Wie entschieden wird | Was Sie dafür brauchen | Beispiel |
|---|---|---|---|
| Feste Regel | Wenn der Lernende X tut, zeige Y | Fragen zu jedem Lernziel und eine schriftliche Regel | Bei zwei richtigen Antworten im Eingangstest entfällt ein Modul |
| Mastery-Schwelle | Der Lernende bekommt mehr Unterstützung und neue Fragen, bis er eine festgelegte Punktzahl erreicht | Eine Bestehensgrenze, Ersatzfragen und Nachschulungsinhalte | Zwei neue Fragen nach einem nicht bestandenen Modulcheck |
| Wiederholungsregel (Spacing) | Falsche Antworten kommen früher wieder als richtige | Eine Fragenbank und ein Zeitplan | Falsch beantwortete Fragen kommen nach 12 Tagen wieder, richtig beantwortete nach 24; nach zwei richtigen Antworten in Folge fallen sie heraus |
| Adaptives Testen | Jede Frage wird anhand der bisherigen Antworten ausgewählt | Ein großer, kalibrierter Fragenpool | Ein Einstufungstest, der endet, sobald die Einstufung feststeht |
| Knowledge Tracing | Eine Beherrschungswahrscheinlichkeit pro Fähigkeit, nach jeder Antwort aktualisiert | Viele Übungsaufgaben pro Fähigkeit und Daten zum Einstellen des Modells | Ein Tutorsystem, das Übungen zuweist, bis eine Fähigkeit 0,95 erreicht |
| Lernermodell der Plattform | Software kombiniert Antworten, Antwortsicherheit und Zeit | Eine Anbieterplattform und nach Lernzielen getaggte Inhalte | Auffrischungen, die aus den Fehlern jeder Person erzeugt werden |
Am Anfang standen Regeln. Als Sidney Pressey im Dezember 1924 bei der American Psychological Association seine Testmaschine vorführte, musste der Lernende „die richtige Antwort auf jede Frage geben, bevor er zur nächsten übergehen kann“, wie es in seinem Aufsatz von 1926 heißt. Adaptives Testen ist noch älter: In einer Übersichtsarbeit von 1982 in Applied Psychological Measurement, nennt David Weiss den in Einzelsitzungen durchgeführten Intelligenztest von Alfred Binet „den ersten adaptiven Test“, weil der Prüfer jede Aufgabe anhand der vorherigen Antworten wählte. Weiss berichtete außerdem über Daten aus realen Testläufen, in denen adaptive Tests „nur halb so viele Aufgaben wie herkömmliche Tests benötigten, um die gleiche Reliabilität zu erreichen“.
Knowledge Tracing (etwa: Wissensverfolgung) ist der klassische Algorithmus und wird oft falsch beschrieben. Im Aufsatz von Albert Corbett und John Anderson von 1995 befindet sich jede Fähigkeit in einem von zwei Zuständen, gelernt oder nicht gelernt. Das Tutorsystem berechnet laufend die Wahrscheinlichkeit, dass sie gelernt ist, und aktualisiert sie nach jeder Antwort aus vier Werten: der Wahrscheinlichkeit, dass sie von Anfang an bekannt war, dass sie bei einem Schritt gelernt wird, dass richtig geraten wird und dass trotz Können ein Fehler passiert. „Das Mastery-Kriterium im Tutor ist eine Wissenswahrscheinlichkeit von 0,95.“ Das Modell geht zudem davon aus: „Es gibt kein Vergessen.“ Geschätzt wird dabei die Wahrscheinlichkeit, dass eine Fähigkeit gelernt ist. Die Lernwahrscheinlichkeit pro Schritt ist nur einer von vier Eingabewerten, nicht das, was das Modell ausgibt.
Ausgerechnet für den einfachsten dieser Mechanismen, die Wiederholungsregel, liegt das deutlichste Ergebnis aus der betrieblichen Praxis vor.

Fallstudie: Behandelnde an acht Veteranenkrankenhäusern in den USA
Diese randomisierte kontrollierte Studie lief 2010 und 2011 mit Behandelnden der Primärversorgung an acht medizinischen Zentren von Veterans Affairs in Neuengland. Das Problem hieß klinische Trägheit: Bei Patienten mit Bluthochdruck wurde die Medikation bei Terminen oft nicht gesteigert.
- Was sie taten: Die Behandelnden erhielten per E-Mail 32 Fragen mit Erklärungen, etwa alle drei Tage eine. Eine feste Regel bestimmte den Zeitpunkt: „Das adaptive System wiederholte Fragen nach 12 Tagen, wenn sie falsch beantwortet wurden, und nach 24 Tagen, wenn sie richtig beantwortet wurden.“ Eine zweimal in Folge richtig beantwortete Frage wurde aussortiert. Eine Rangliste sorgte zusätzlich für Wettbewerb. Die Kontrollgruppe erhielt dieselben Inhalte als Online-Beitrag mit E-Mail-Erinnerungen. Das ist regelbasierte Adaptivität.
- Belege und Ergebnis: In der Studie von Kerfoot und Kollegen von 2014 in Circulation: Cardiovascular Quality and Outcomes nahmen 111 Behandelnde teil, 104 absolvierten den Abschlusstest. Die Gamification-Gruppe erreichte 90 % gegenüber 78 % (Cohen's d 0,8). Von insgesamt 14.336 Patienten erreichten die von der Gamification-Gruppe betreuten ihren Blutdruckzielwert etwas früher: nach Adjustierung im Median nach 142 gegenüber 148 Tagen (Hazard Ratio 1,043; 95-%-Konfidenzintervall 1,007 bis 1,081). Vor der Adjustierung war der Unterschied nicht signifikant.
- Einschränkung: Nur 37 % der infrage kommenden Behandelnden nahmen teil, die Gamification-Gruppe bekam auch mehr E-Mails, und die Regel kam im Paket mit Spielelementen, sodass sich der Erfolg nicht allein der Adaptivität zuschreiben lässt. Der Erstautor entwickelte Spaced Education und legte eine Beteiligung an einem darauf aufbauenden Unternehmen offen, dessen Plattform allerdings nicht verwendet wurde.
- Erkenntnis: Eine schlichte Regel (Falsches früher wiederholen, zweimal richtig Beantwortetes aussortieren) ist bereits adaptives Lernen und braucht keine KI. Rechnen Sie damit, dass der Wissenszuwachs deutlich größer ausfällt als die Veränderung in der Praxis, und messen Sie nach Möglichkeit auch die Veränderung in der Praxis.
Regelbasiert oder algorithmisch: die erste Entscheidung
Bevor Sie ein Tool auswählen, klären Sie, wer die Logik schreibt. Bei regelbasierter Adaptivität schreiben Sie jede Regel selbst und können jeden Lernpfad erklären. Bei algorithmischer Adaptivität trifft das Modell eines Anbieters die Entscheidungen auf Basis von Daten, und Sie liefern die nach Lernzielen getaggten Inhalte.
| Frage | Regelbasiert (von Menschen festgelegt) | Algorithmisch (Lernermodell) |
|---|---|---|
| Am besten für | Abläufe, Compliance- und Sicherheitsschulungen, bei denen jeder Lernpfad erklärbar sein muss | Viele Lernende, die eine große, stabile Fragenbank durcharbeiten |
| Schwachstelle | Leitet Lernende nur anhand dessen, was Ihre Fragen messen; jede Verzweigung erfordert eigene Inhalte, die jemand schreiben und aktuell halten muss | Gegenüber einem Auditor schwerer zu erklären; braucht viele Fragen und reichlich Lernendendaten |
| Was Sie brauchen | Mindestens zwei Fragen pro Lernziel, schriftliche Regeln, Bestehensgrenzen und Sperren oder einen Administrator | Eine Plattform, nach Lernzielen und Fähigkeiten getaggte Inhalte und Zeit für die Feinabstimmung |
| Einsetzen, wenn | die Lernziele klar sind und die Gruppe klein bis mittelgroß ist | dieselben Inhalte über Jahre von vielen Lernenden genutzt werden |
Von Instructional Designern festgelegte Regeln kommen ohne historischen Datensatz zu Lernenden aus, stützen sich aber trotzdem auf aktuelle Antworten oder andere relevante Lerndaten. Validieren Sie die Fragen, die Entscheidungsregeln und jeden Lernpfad. Statistische Lernermodelle und feste Regeln können in einem System auch nebeneinander bestehen.

Fallstudie: Fachkräfte der Neugeborenenversorgung in Mwanza, Tansania
Diese einarmige Implementierungsstudie lief 2022 und 2023 an einem regionalen Referenzkrankenhaus und drei Gesundheitszentren. Mehrtägige berufsbegleitende Kurse zur Neugeborenenversorgung lassen sich schwer dauerhaft anbieten, gehen nicht darauf ein, was die einzelne Fachkraft schon weiß, und das Gelernte verblasst.
- Was sie taten: Ärzte, Pflegekräfte, Clinical Officers und weiteres Personal lernten neun Module auf Basis nationaler Leitlinien auf dem eigenen Smartphone und erhielten dafür Fortbildungspunkte. Die Plattform bewertete jede Antwort nach Richtigkeit und Antwortsicherheit, erstellte ein Modell jedes Lernenden, legte Tempo und Reihenfolge fest und erzeugte Auffrischungen, und ein Modul endete erst bei „100 % bewusster Kompetenz“. Flankiert wurde das Ganze durch eine Programmverantwortliche, Erinnerungen per E-Mail nach 2 Tagen und per WhatsApp nach 5, ein Gespräch nach 30 Tagen sowie ein Datenguthaben von rund 4 US-Dollar im Monat. Das ist algorithmische Adaptivität.
- Belege und Ergebnis: Im Aufsatz von Meaney und Kollegen von 2024 in BMJ Open schrieben sich 195 Fachkräfte ein, 110 schlossen die Anfangsmodule ab. Bei diesen 110 stieg der Anteil der zugleich richtigen und sicheren Antworten im Schnitt um 42 Prozentpunkte. Bei den Auffrischungen sah es anders aus: Der durchschnittliche Fortschritt lag bei 7 %, niemand schloss alle ab, und als Hauptgründe für die Inaktivität nannten die Teilnehmenden „keine Zeit“ (69 %) und „Nutzung vergessen“ (50 %).
- Einschränkung: Es gab keine Kontrollgruppe, der Zuwachs wurde innerhalb der Plattform und nur bei denjenigen gemessen, die den Kurs beendeten, was den Durchschnitt aller Eingeschriebenen zu gut aussehen lässt, und die Antwortsicherheit beruhte auf Selbsteinschätzung. Zwei Co-Autoren wurden vom Anbieter der Plattform bezahlt.
- Erkenntnis: Der Algorithmus deckte in dieser Studie Antworten auf, bei denen sich die Menschen sicher waren und trotzdem falsch lagen. Er brachte das stark ausgelastete Personal jedoch nicht dazu, dranzubleiben: Bis zum Abschluss brauchte es eine Programmverantwortliche und gestaffelte Erinnerungen, und selbst dann blieben die zeitlich verteilten Auffrischungen fast unbeachtet. Planen Sie fest freigehaltene Lernzeit und gezieltes Nachfassen ein.
Adaptives, personalisiertes und differenziertes Lernen im Vergleich
Die drei Begriffe werden oft wie Synonyme verwendet, sie sind aber keine. Der wichtige Unterschied liegt darin, wer entscheidet und auf welcher Grundlage.
| Ansatz | Wer entscheidet | Auf welcher Grundlage | Beispiel aus dem Arbeitsalltag |
|---|---|---|---|
| Adaptives Lernen | Der Kurs, über die Regeln eines Instructional Designers oder ein Softwaremodell | Antworten und Leistung des Lernenden | Ein Eingangstest entscheidet, welche Module ein Produktionsmitarbeiter absolviert |
| Personalisiertes Lernen | Unterschiedlich, weil es keine gemeinsame Definition gibt | Bedürfnisse, Ziele und Interessen jedes Lernenden | Ein Entwicklungsplan, der auf das Karriereziel einer Person zugeschnitten ist |
| Differenzierter Unterricht | Die Lehrkraft oder der Trainer | Lernstand und Interesse, direkt in der Gruppe eingeschätzt | Ein Trainer gibt einer schnelleren Gruppe im Workshop schwierigere Fälle |
| Lernerkontrolle | Der Lernende | Die eigene Wahl | Ein Lernender entscheidet, welches Modul er zuerst öffnet |
Carol Ann Tomlinsons ERIC-Digest zur Differenzierung bringt es auf den Punkt: „Im Kern besteht Differenzierung aus den Bemühungen von Lehrkräften, im Klassenzimmer auf die Unterschiede zwischen den Lernenden einzugehen.“ Personalisiertes Lernen ist weniger scharf umrissen. Ein RAND-Bericht von 2017 über Schulen, die es einführten, hält fest, „dass es noch keine breit geteilte Definition von personalisiertem Lernen gibt“. In 32 Schulen mit rund 5.500 Schülern schätzte er die Effekte auf etwa 0,09 Standardabweichungen in Mathematik und 0,07 im Lesen, gemessen an einer gematchten Vergleichsgruppe statt an einer randomisierten Gruppe, und nur das Mathematikergebnis war statistisch signifikant.
Lernerkontrolle ist die übliche Notlösung, wenn ein Kurs Lernende nicht gezielt leiten kann: Dann wählen die Lernenden selbst. Eine Metaanalyse zur Lernerkontrolle von Karich und Kollegen aus dem Jahr 2014 ergab, dass der Gesamteffekt „nahezu null war (g = 0,05)“, wenn Lernende beim Einsatz von Bildungstechnologie selbst die Kontrolle haben. Die freie Wahl allein ist also noch kein adaptives Lernen.
Ein System kann Inhalte zwar an einen angegebenen Lernstil anpassen, ein Lernvorteil ist damit aber nicht belegt. Wählen Sie den Lernpfad anhand relevanter Leistungsdaten und des Lernbedarfs. Für die Matching-Hypothese fehlen ausreichende Belege, und eine Vorliebe beweist nicht, welche Methode jemand braucht.
Diese Schlussfolgerung stammt aus dem Aufsatz von Harold Pashler und Kollegen von 2008 in Psychological Science in the Public Interest. Die Autoren betonen, dass viele Varianten von Lernstilen überhaupt nie getestet wurden. Solange das nicht geschehen ist, haben sie in einem Kursdesign nichts verloren. Gut belegt ist unter den Lernendenmerkmalen vor allem das Vorwissen.
Woher adaptives Lernen kommt
Die Idee ist rund ein Jahrhundert alt, und ihre Geschichte besteht größtenteils aus Regeln, nicht aus Algorithmen.
- Binets Test, frühes 20. Jahrhundert. Der Prüfer wählte jede Frage anhand der vorherigen Antworten des Kindes aus und hörte auf, sobald das Ergebnis feststand. Deshalb nennt Weiss ihn den ersten adaptiven Test.
- Presseys Maschine, 1924 bis 1926. Das Gerät von Sidney Pressey gab die nächste Frage erst frei, wenn die vorherige richtig beantwortet war. 1926 beschrieb er es als Apparat, der „Tests durchführt und auswertet und lehrt“.
- Skinners Lehrmaschinen, 1958. Der Aufsatz in Science von B. F. Skinner würdigte Pressey („Solche Maschinen, so Pressey (1926), könnten nicht nur testen und auswerten, sondern auch lehren“) und argumentierte, maschineller Unterricht „würde jedem Schüler erlauben, in seinem eigenen Tempo voranzukommen“.
- Blooms Mastery Learning, 1968. Benjamin Bloom griff John Carrolls Verständnis von Begabung als „der Zeit, die der Lernende benötigt, um den Stoff zu beherrschen“ auf und baute darauf eine Unterrichtsmethode (Mastery Learning, zielerreichendes Lernen): lehren, prüfen, korrigieren, erneut prüfen. Sein Aufsatz Learning for Mastery formulierte keinen Befund, sondern eine Überzeugung: „Die meisten Schüler (vielleicht über 90 Prozent) können beherrschen, was wir ihnen beizubringen haben.“
- Blooms 2-Sigma-Problem, 1984. Bloom stellte der Forschung die Aufgabe, Methoden für den Gruppenunterricht zu finden, die so wirksam sind wie Einzelunterricht durch einen Tutor. Genau darum geht es auch im Untertitel seines Aufsatzes.
- Intelligente Tutorsysteme, 1980er bis 1990er Jahre. Tutorsysteme modellierten die Fähigkeiten jedes Lernenden, die klassische Methode war Knowledge Tracing.
- KI-gestützte Systeme, ab den 2010er Jahren. Eine Metaanalyse von Wang und Kollegen aus dem Jahr 2024 über 45 Studien zu KI-gestützten adaptiven Lernsystemen berichtete einen gepoolten Effekt von g = 0,70 gegenüber nicht adaptivem Unterricht. Ich habe nur das Abstract gelesen, und ein Satz daraus verdient mehr Aufmerksamkeit als der Hauptbefund: „Die Art der in der adaptiven Engine eingesetzten KI moderierte die Effekte nicht.“
Blooms 2-Sigma-Problem: was die Studien wirklich zeigen
Benjamin Blooms Aufsatz von 1984 in Educational Researcher, The 2 Sigma Problem, liefert eine der meistzitierten Aussagen rund um adaptives Lernen. Meist heißt es verkürzt, Einzelbetreuung durch einen Tutor hebe die Leistung um zwei Standardabweichungen, und fast jeder Teil dieses Satzes braucht eine Einschränkung.
Worum es in den Studien ging. Bloom fasste zwei Doktorarbeiten der University of Chicago von Anania und Burke zusammen. Schülerinnen und Schüler der 4., 5. und 8. Klasse wurden zufällig einer von drei Lernformen zugeteilt, um Wahrscheinlichkeitsrechnung oder Kartografie zu lernen: einer herkömmlichen Klasse mit rund 30 Kindern, derselben Klasse mit Mastery Learning (formative Tests, Korrekturarbeit und ein paralleler Wiederholungstest) oder Tutoring mit demselben Feedback und denselben Wiederholungstests. „In jeder Teilstudie war die Unterrichtsmaßnahme auf 11 Unterrichtsstunden innerhalb eines Blocks von 3 Wochen begrenzt“ (S. 4). Stichprobengrößen nennt Bloom nicht.
Was herauskam. „Der durchschnittliche Schüler mit Tutoring lag etwa zwei Standardabweichungen über dem Durchschnitt der Kontrollklasse (der durchschnittliche Schüler mit Tutoring lag über 98 % der Schüler in der Kontrollklasse)“ (S. 4). Mastery Learning lag rund eine Standardabweichung über der herkömmlichen Klasse.
Was beim Weitererzählen verloren geht.
- Die 98 % sind ein Perzentil, keine Beherrschungsquote. Sie ordnen den durchschnittlichen Schüler mit Tutoring in die Kontrollklasse ein. Dass 98 % der Schüler mit Tutoring das Thema beherrschten, heißt das nicht.
- „Tutoring“ war nicht immer Einzelunterricht. Bloom selbst definierte es als „ein guter Tutor für jeden Schüler (oder für zwei oder drei Schüler gleichzeitig)“. Kurt VanLehn weist in seiner Übersichtsarbeit von 2011 in Educational Psychologist darauf hin, dass in fünf der sechs Experimente jeder Tutor mit drei Schülern arbeitete.
- Auch die Schüler mit Tutoring durchliefen die Mastery-Schleife. Sie erhielten dasselbe Feedback, dieselbe Korrekturarbeit und dieselben Wiederholungstests wie die Mastery-Learning-Gruppe.
- Die berühmte Kurve ist eine Zeichnung. Paul von Hippel merkt in seiner Analyse von 2024 in Education Next an, dass Blooms Abbildung „nicht an tatsächliche Daten angepasst war“, und Bloom selbst hält fest, dass die Verteilungen bei Mastery Learning und Tutoring „stark schief“ waren.
Von Hippels Lesart der Originalstudien trennt Mastery Learning und Tutoring voneinander.
Für das Tutoring selbst bleiben damit etwa 0,9, und zwar bei eng gefassten Tests am Ende einer Einheit zu unbekannten Themen. Spätere Synthesen liegen noch niedriger. VanLehn fand in 10 Vergleichen einen durchschnittlichen Effekt von d = 0,79 für menschliches Tutoring. James Kulik und J. D. Fletcher beziffern in einer Übersichtsarbeit von 2016 den Median menschlichen Tutorings über fünf Metaanalysen auf 0,40, „weit entfernt von Blooms (1984) Zwei-Sigma-Effekt“. Von Hippel kommt zu dem Schluss, die 2-Sigma-Behauptung sei „übertrieben und zu stark vereinfacht“, und: „Rund ein Drittel einer Standardabweichung scheint der typische Effekt eines intensiven, gut gestalteten Programms zu sein, das an breit angelegten Tests gemessen wird.“
Für das Kursdesign zählt die Hälfte von Blooms Aufsatz, die sich tatsächlich umsetzen lässt: vermitteln, jedes Lernziel prüfen, Falsches korrigieren und mit neuen Fragen erneut prüfen. Auch das garantiert kein Sigma. Robert Slavins Übersichtsarbeit von 1987 zu gruppenbasiertem Mastery Learning an Schulen fand bei standardisierten Tests über 7 Studien einen Median von +0,04 und bei vom Versuchsleiter erstellten Tests über 8 Studien von +0,255. Die Lernzuwächse zeigen sich in Tests zum vermittelten Stoff und liegen bei breit angelegten Messungen nahe null.
Funktioniert adaptives Lernen? Das zeigt die Forschung
Beim vermittelten Stoff meist ja, bei breit angelegten Tests deutlich weniger. Adaptives Tutoring schlägt Einheitsunterricht bei klar definierten Aufgaben und liegt ungefähr auf dem Niveau eines menschlichen Tutors, aber der Effekt schrumpft bei standardisierten Tests, großen Stichproben und langen Einsätzen. Die besten Belege stammen von intelligenten Tutorsystemen, der am besten untersuchten Form des adaptiven Lernens. Jede Zeile dieser Tabelle ist eine Synthese, keine Einzelstudie.
| Vergleich | Datenbasis | Effekt | Was ihn begrenzt |
|---|---|---|---|
| Tutorsysteme vs. herkömmlicher Unterricht | 50 Evaluationen (Kulik und Fletcher, 2016) | Median 0,66 SD; Random-Effects g 0,50 | Testart, Stichprobengröße und Fach sind miteinander verwoben |
| Dito, Studien mit bis zu 80 Personen vs. über 250 | 26 bzw. 13 Studien | 0,78 vs. 0,30 | Große Studien zeigen kleinere Effekte |
| Tutorsysteme vs. Unterricht in großen Gruppen | 66 Vergleiche (Ma und Kollegen, 2014) | g 0,44 | Vergleiche im Klassenraum; Ergebnisse insgesamt sehr uneinheitlich |
| Tutorsysteme vs. menschliches Einzeltutoring | 5 Vergleiche (Ma und Kollegen, 2014) | g -0,11, nicht signifikant | Wenige Studien |
| Tutorsysteme im Mathematikunterricht an Schulen | 26 Berichte, 34 Stichproben (Steenbergen-Hu und Cooper, 2013) | g 0,09, nicht signifikant | Effekt über ein ganzes Schuljahr kleiner |
| Adaptives E-Learning, Wissen von Gesundheitsfachkräften | 13 gepoolte Studien (Fontaine und Kollegen, 2019) | SMD 0,70, nicht signifikant | Evidenz von sehr niedriger Qualität; hohes Verzerrungsrisiko |
| Adaptives E-Learning, Fertigkeiten von Gesundheitsfachkräften | Dieselbe Übersichtsarbeit | SMD 1,19 | Evidenz von niedriger Qualität |
Die Metaanalyse von Kulik und Fletcher von 2016 in Review of Educational Research ist die Hauptquelle für die ersten beiden Zeilen: „Im Median hob intelligentes Tutoring in den 50 Evaluationen die Testergebnisse um 0,66 Standardabweichungen über das herkömmliche Niveau, also vom 50. auf das 75. Perzentil.“ Für das, was Sie versprechen sollten, ist aber etwas anderes entscheidend: wie stark der Effekt vom Test abhängt.
Die Autoren warnen, dass die Testart mit Stichprobengröße, Fach und Klassenstufe zusammenhängt und sich deshalb nicht eindeutig als Ursache ausmachen lässt. Auch findet nicht jede Übersichtsarbeit diesen Unterschied: Die Metaanalyse von Ma und Kollegen von 2014 stellte im Random-Effects-Modell fast keinen Unterschied fest. Ein Kursquiz, das von denselben Leuten stammt wie der Kurs, ist aber der am leichtesten zu bestehende Test, und ein adaptiver Kurs, der Lernende gezielt auf sein eigenes Quiz vorbereitet, kann besser aussehen, als er ist.
Die Metaanalyse von Ma und Kollegen fand einen positiven durchschnittlichen Effekt gegenüber lehrergeführtem Unterricht in großen Gruppen. In fünf Vergleichen mit individuellem menschlichem Tutoring stellte sie keinen statistisch signifikanten Unterschied fest (g = -0,11; 95-%-Konfidenzintervall -0,31 bis 0,10). Dieses Intervall schließt bedeutsame Unterschiede ein und beweist deshalb keine Gleichwertigkeit mit einem menschlichen Tutor.
Fast alle belastbaren Belege aus der Arbeitswelt, die ich gefunden habe, stammen aus dem Gesundheitswesen und dem Militär, und die meisten Evaluationen führten die Entwickler selbst durch. Vertretbar sind für ein Unternehmensteam deshalb diese Versprechen: weniger Zeitaufwand für alle, die den Stoff schon kennen, und ein Check zu jedem Lernziel für alle. Ein fester Zuwachs bei den Testergebnissen gehört nicht dazu.
Das durchgehende Beispiel: eine Auffrischungsschulung zur Guten Dokumentationspraxis
An diesem hypothetischen Beispiel gestalte ich ab hier den Kurs. Ein Lohnhersteller in Deutschland produziert an einem Standort Tabletten und Kapseln und beschäftigt rund 180 Produktionsmitarbeitende und Analysten in der Qualitätskontrolle (QC). Die Produktion füllt Chargenprotokolle, Line-Clearance-Checks und Wiegeprotokolle aus, das Labor führt Laborjournale und Chromatografiedaten. Die Erfahrung reicht von 3 Monaten bis zu 25 Jahren, und alle müssen jedes Jahr die Auffrischungsschulung zur Guten Dokumentationspraxis (GDocP) absolvieren. Die Betriebszugehörigkeit verrät nicht, wer korrekt dokumentiert: Einzelne Arbeitsproben und passende Eingangstests sind die besseren Belege.
Das Problem ist der Kurs des letzten Jahres. Alle absolvierten denselben 60-minütigen Kurs mit einem Quiz aus 10 Fragen am Ende. Erfahrene Kräfte klickten sich in 15 Minuten durch und bestanden, neue Mitarbeitende bestanden ebenfalls. Im Jahr darauf standen im Abweichungsprotokoll dieselben vier Dokumentationsfehler.
Der Kurs stützt sich allein auf das Standortverfahren SOP GDocP-001 „Gute Dokumentationspraxis“.
Die SOP GDocP-001 und ihre Regeln sind für dieses Beispiel erfunden. So lassen sich die Entscheidungen im Beispiel beurteilen. Ein echter Hersteller muss sein genehmigtes Dokumentationsverfahren verwenden. Die Routing-Regel mit zwei Fragen dient der Veranschaulichung und ist weder ein allgemeingültiges Minimum noch eine validierte Mastery-Schwelle. Die SOP enthält vier Regeln:
- Halten Sie jeden Eintrag zum Zeitpunkt der Tätigkeit fest.
- Korrigieren Sie einen Fehler mit einem einzelnen Strich, sodass das Original lesbar bleibt, und ergänzen Sie den korrekten Wert, Ihr Kürzel, das Datum und den Grund. Keine Korrekturflüssigkeit und kein Überschreiben.
- Tragen Sie einen versäumten Eintrag als verspäteten Eintrag nach: heutiges Datum und Uhrzeit, die Worte „verspäteter Eintrag“, der Grund und die Gegenzeichnung einer Führungskraft. Niemals rückdatieren.
- Unterschreiben Sie niemals für etwas, das Sie nicht selbst getan oder gesehen haben. Melden Sie jeden Druck in diese Richtung, jedes vorausgefüllte Protokoll und jeden gemeinsam genutzten Login noch am selben Tag Ihrer Führungskraft oder der QA.
Die Schulungsnachweise müssen für jede Person zeigen, welche Lernziele sie bereits im Eingangstest nachweislich erreicht und welche Module sie abgeschlossen hat. Die Auffrischung umfasst deshalb vier Lernziele mit je einem kurzen Modul von etwa 8 Minuten: zum Zeitpunkt der Tätigkeit dokumentieren, einen Fehler richtig korrigieren, einen versäumten Eintrag als verspäteten Eintrag behandeln sowie ein Datenintegritätsproblem erkennen und melden. Die Produktion braucht zusätzlich ein Modul zu Chargenprotokollen und Line Clearance, das Labor eines zu Laboraufzeichnungen und Audit Trails.
Im Ergebnis soll jede Person nur Zeit für die Lernziele aufwenden, die sie noch nicht erreicht hat, und der Standort einem Auditor zeigen können, wer wozu geprüft wurde. Dass die Dokumentationsfehler zurückgehen, kann der Kurs nicht beweisen. Das zeigt erst das Abweichungsprotokoll des nächsten Jahres.
Das Beispiel eignet sich für adaptives Lernen, weil es jeden Baustein verlangt, den ein Unternehmensteam ohne Algorithmus umsetzen kann: eine Diagnose pro Lernziel, eine Überspringregel, die Zuweisung nach Rolle, einen Mastery-Check, eine Nachschulung, eine Ansprechperson, wenn die Regeln nicht mehr weiterhelfen, und eine Dokumentation. Es zeigt auch die Grenze: Regeln können Lernende nur anhand dessen leiten, was die Fragen messen.
Einen adaptiven Kurs erstellen: Schritt für Schritt
Für dieses Vorgehen gibt es kein einzelnes Standardmodell. Die Schritte sind daher meine Synthese aus Mastery Learning, den regelbasierten Mechanismen der Adaptivität und den Fällen in diesem Leitfaden. Jeden Schritt setze ich an der GDocP-Auffrischung um.
- Entscheiden Sie, ob sich Adaptivität lohnt. Sie lohnt sich, wenn sich das Vorwissen der Lernenden stark unterscheidet, alle den Kurs absolvieren müssen, sich jedes Lernziel mit Fragen prüfen lässt und die Inhalte lange genug stabil bleiben, damit sich der Mehraufwand beim Schreiben auszahlt. Selten lohnt sie sich bei kleinen Gruppen mit ähnlicher Erfahrung, bei Inhalten, die sich monatlich ändern, oder bei Lernzielen, die keine Frage prüfen kann. Die GDocP-Auffrischung erfüllt alle vier Bedingungen: Die Erfahrung reicht von 3 Monaten bis zu 25 Jahren, alle müssen sie jährlich absolvieren, jede SOP-Regel lässt sich mit einem Szenario testen, und die SOP GDocP-001 ist stabil.
- Schreiben Sie Lernziele, an denen sich Lernpfade festmachen lassen. Jedes Lernziel braucht eine beobachtbare Entscheidung, die Sie mit einem Szenario testen können, etwa „einen Fehler richtig korrigieren“. Mit Lernzielen wie „GDocP verstehen“ lässt sich kein Lernpfad zuweisen. Wenn Sie die Bloomsche Taxonomie nutzen, ordnen Sie das Denken ein, das die jeweilige Entscheidung verlangt, nicht das Verb.
- Schreiben Sie einen Eingangstest mit mindestens zwei Fragen pro Lernziel. Arbeiten Sie mit kurzen Szenarien aus echten Protokollauszügen, damit die Frage die Entscheidung prüft und nicht den SOP-Wortlaut. Der GDocP-Eingangstest hat acht Fragen, zwei pro Lernziel, darunter diese vier:
- Lernziel 1: Ein Produktionsmitarbeiter wiegt das Bindemittel um 10:05 Uhr und trägt es um 11:30 Uhr, nach der Pause, als 10:05 Uhr ins Chargenprotokoll ein. Richtige Antwort: nicht zulässig; zum Zeitpunkt der Tätigkeit dokumentieren oder einen verspäteten Eintrag anlegen, mit tatsächlichem Eintragsdatum und tatsächlicher Uhrzeit, dem Grund und der von dieser fiktiven SOP verlangten Gegenzeichnung der Führungskraft.
- Lernziel 2: 25,4 kg wurden als 24,5 kg notiert. Richtige Antwort: ein einzelner Strich durch 24,5, sodass der Wert lesbar bleibt, dann 25,4, Kürzel, Datum und der Grund „Übertragungsfehler“.
- Lernziel 3: Der gestrige Line-Clearance-Check wurde durchgeführt, aber nicht unterschrieben. Richtige Antwort: heute als verspäteten Eintrag unterschreiben, mit Grund und Gegenzeichnung der Führungskraft, und niemals auf gestern datieren.
- Lernziel 4: Ein Kollege bittet Sie, als Zweitprüfer für eine Wägung zu unterschreiben, die Sie nicht gesehen haben, weil das „doch nur eine Formalität“ sei. Richtige Antwort: ablehnen und noch am selben Tag Ihre Führungskraft oder die QA informieren.
- Schreiben Sie die Routing-Regel und legen Sie fest, wer sie anwendet. Für die Auffrischung gilt: Sind beide Fragen des Eingangstests zu einem Lernziel richtig, wird das Modul übersprungen und als per Test nachgewiesen dokumentiert. Bei einer oder keiner richtigen Antwort absolviert der Lernende das Modul. Zwei Fragen schützen vor Zufallstreffern: Wer bei einer Frage mit vier Optionen rät, liegt in einem von vier Fällen richtig, bei zwei solchen Fragen nur noch in einem von 16. Dann klären Sie, wer die Personen auf den jeweiligen Lernpfad schickt: die Plattform, ein Administrator, der sie nach ihrem Ergebnis einschreibt, oder der Lernende selbst, dem erklärt wird, was sein Ergebnis bedeutet.
- Ergänzen Sie Mastery-Check, Nachschulung und eine Ansprechperson. Jedes GDocP-Modul endet mit zwei neuen Fragen, und wer beide richtig beantwortet, kommt weiter. Andernfalls folgt eine Nachschulungsseite mit einem Lösungsbeispiel genau zu diesem Fehler und der SOP-Klausel, danach zwei weitere neue Fragen. Scheitert jemand ein zweites Mal, wird er für einen 15-minütigen Coaching-Termin mit dem QA-Trainer außerhalb des Kurses vorgemerkt. Die Nachschulung muss sich vom Modul unterscheiden und darf nicht einfach dieselbe Seite wiederholen. Beim Coaching-Termin übernimmt ein Mensch, wo die Regeln nicht mehr weiterhelfen, ähnlich der abgestuften Hilfe in der Zone der nächsten Entwicklung.
- Weisen Sie nach Rolle zu, wo die Tätigkeit den Inhalt bestimmt. Die Produktion erhält „Chargenprotokolle und Line Clearance“ auf Basis einer vorausgefüllten Line-Clearance-Checkliste. Die QC-Analysten erhalten „Laboraufzeichnungen und Audit Trails“ auf Basis eines Chromatografieergebnisses, das ohne dokumentierten Grund neu ausgewertet wurde. Diese Zuweisung stützt sich auf ein Merkmal des Lernenden, nicht auf eine Punktzahl, und lässt sich daher am einfachsten über die Einschreibung einrichten.
- Alle beantworten vier neue Szenariofragen, eine pro Lernziel, wobei in diesem fiktiven Kurs jede kritische Antwort richtig sein muss. Ein Abschlusscheck verringert die Abhängigkeit vom Ergebnis des Eingangstests, garantiert aber nicht, dass Glückstreffer oder nicht gemessene Lücken auffallen. Der QA-Trainer muss beurteilen, ob die Fragen die geforderten Entscheidungen ausreichend abdecken, bevor eine Überspringregel zum Einsatz kommt. Der Kursabschluss berechtigt nicht zu Arbeiten außerhalb der genehmigten Standortverfahren.
- Führen Sie eine Dokumentation, die ein Auditor lesen kann. Für jede Person: die per Test nachgewiesenen Lernziele, die abgeschlossenen Module, das Ergebnis des Abschlusschecks und jede Weiterleitung zum Coaching. Die Weiterleitungen prüft der QA-Trainer.
- Prüfen Sie nach dem Start Stichproben echter Dokumentationsarbeit auf die Einhaltung des Verfahrens, als Beleg für Level 3 (Verhalten). Erfassen Sie Abweichungsraten getrennt als organisatorisches Ergebnis und berücksichtigen Sie dabei Produktionsvolumen, Auditintensität und andere Prozessänderungen. Eine reine Fehlerzahl isoliert keinen Schulungseffekt.
Bei Schritt 3 lässt sich die Anpassung vor Kursbeginn am günstigsten umsetzen, und eine Studie aus den Niederlanden zeigt, wo ihre Grenze liegt. Pflegefachkräfte in niederländischen Hausarztpraxen hielten sich bei der Beratung von Rauchern weniger gut als beabsichtigt an die nationale Neun-Schritte-Leitlinie. In der Studie von de Ruijter und Kollegen von 2018 im Journal of Medical Internet Research erhielten sie E-Learning-Module und einen Feedbackbrief, die einmalig auf ihre Antworten in einem Ausgangsfragebogen zugeschnitten waren. Von 269 Teilnehmenden, die den Ausgangsfragebogen ausfüllten, wurden 211 ausgewertet, und das Programm hatte keinen Gesamteffekt auf die selbst berichtete Einhaltung der Neun-Schritte-Leitlinie (p = 0,19). Nur Teilnehmende mit überdurchschnittlicher Beratungserfahrung verbesserten sich, um etwa 0,6 Schritte, und die Module wurden im Schnitt nur dreimal aufgerufen. Die Grenzen: Die Einhaltung war schon zu Beginn hoch (8,5 von 9 Schritten), das Ergebnis war selbst berichtet, und die Entwickler führten die Studie durch. Was das für die Auffrischung bedeutet: Eine Diagnose hilft nur, wenn die Menschen die zugewiesenen Inhalte anschließend auch durcharbeiten und danach handeln können.
Für Schritt 4 spricht noch ein zweiter Grund neben der Zeitersparnis. Hilfe, die neue Mitarbeitende brauchen, etwa ein vollständiges Lösungsbeispiel, kann Erfahrene behindern. Die Forschenden, die den Expertise-Reversal-Effekt benannten, schrieben: „Unterrichtstechniken, die bei unerfahrenen Lernenden sehr wirksam sind, können bei erfahreneren Lernenden ihre Wirksamkeit verlieren und sogar negative Folgen haben.“ Unser Leitfaden zur Cognitive Load Theory behandelt den Effekt im Detail. Eine Überspringregel schützt die Analystin mit 25 Jahren Erfahrung vor Material, das für jemanden im ersten Monat geschrieben wurde.
Der adaptive Designplan für die GDocP-Auffrischung
Die Tabelle zeigt den Plan für die vier Lernziele. In jeder Zeile gelten dieselben Regeln.
| Lernziel | Eingangstest | Beide richtig | Eine oder keine richtig | Modulcheck nicht bestanden | Erneut nicht bestanden |
|---|---|---|---|---|---|
| 1. Zum Zeitpunkt der Tätigkeit dokumentieren | 2 Szenariofragen, darunter das um 10:05 Uhr gewogene Bindemittel | Modul 1 überspringen; als per Test nachgewiesen dokumentiert | Modul 1 absolvieren | Lösungsbeispiel zu einem verspäteten Eintrag, SOP-Klausel 1, dann 2 neue Fragen | 15-minütiger Coaching-Termin mit dem QA-Trainer |
| 2. Einen Fehler richtig korrigieren | 2 Szenariofragen, darunter 25,4 kg als 24,5 kg notiert | Modul 2 überspringen; als per Test nachgewiesen dokumentiert | Modul 2 absolvieren | Lösungsbeispiel zu einer Korrektur mit einzelnem Strich, SOP-Klausel 2, dann 2 neue Fragen | 15-minütiger Coaching-Termin mit dem QA-Trainer |
| 3. Einen versäumten Eintrag als verspäteten Eintrag behandeln | 2 Szenariofragen, darunter die nicht unterschriebene Line Clearance | Modul 3 überspringen; als per Test nachgewiesen dokumentiert | Modul 3 absolvieren | Lösungsbeispiel zu einem verspäteten Eintrag, SOP-Klausel 3, dann 2 neue Fragen | 15-minütiger Coaching-Termin mit dem QA-Trainer |
| 4. Ein Datenintegritätsproblem erkennen und melden | 2 Szenariofragen, darunter die Bitte, als Zweitprüfer zu unterschreiben | Modul 4 überspringen; als per Test nachgewiesen dokumentiert | Modul 4 absolvieren | Lösungsbeispiel zu Ablehnen und Melden, SOP-Klausel 4, dann 2 neue Fragen | 15-minütiger Coaching-Termin mit dem QA-Trainer |
Zusätzlich zu diesen Zeilen absolviert die gesamte Produktion das Modul zu Chargenprotokollen, das gesamte Labor das Modul zu Laboraufzeichnungen, und alle absolvieren den Abschlusscheck mit vier Fragen. Die Modulchecks sind formativ, der Abschlusscheck ist summativ. Warum beide unterschiedliche Fragen brauchen, erklärt unser Leitfaden zu formativer und summativer Beurteilung.
Planen Sie einen adaptiven Kurs Lernziel für Lernziel: die Fragen des Eingangstests, die Überspringregel, das Modul, den Mastery-Check, die Nachschulung, wann eine Person eingreift, was die Dokumentation zeigt und wer welchen Lernpfad zuweist. Ausgefüllt für die Auffrischungsschulung zur Guten Dokumentationspraxis, mit leeren Seiten für Ihren eigenen Kurs. Bearbeitbare Word-Datei auf Englisch, ohne Angabe einer E-Mail-Adresse.
Benennen Sie für jede Regel, wer sie anwendet, bevor Sie mit der Erstellung beginnen. Eine Regel ohne Zuständigen bleibt ein Ratschlag auf dem Papier, und der Nachweis, wer sich per Test befreit hat, entsteht nie.
Was Coursebox-Kursanfragen über adaptives Lernen verraten
Um herauszufinden, ob Menschen adaptive Kurse überhaupt anfragen, habe ich mir die Kursanfragen angesehen, die in den 90 Tagen bis zum 7. Oktober 2026 in Coursebox eingegeben wurden: eine pro Person, aus englischsprachigen Browsern, ohne hochgeladene Datei. Von 266 Prompts waren 104 Kursanfragen. Zwei unabhängige KI-Modelle klassifizierten alle 104 nach schriftlichen Definitionen, danach las ich jeden positiven Treffer selbst vollständig nach. Die Zahlen stehen für die Vereinigungsmenge beider Klassifikationen nach meiner Prüfung. Verstehen Sie sie als Klassifikationsschätzungen, nicht als statistische Schätzwerte, denn übersehene Fälle und Grenzfälle sind möglich.
Keine der 104 Anfragen verlangte, dass Lernende überspringen dürfen, was sie schon können, und keine, dass die Antworten eines Lernenden beeinflussen, was er als Nächstes sieht. Höchstens 5 verlangten überhaupt etwas Adaptives, und nur eine davon betraf die Arbeitswelt: eine Sicherheitsunterweisung für Lager und Werkstatt mit einem Abschlusstest, der vor Arbeitsbeginn zu bestehen war. Das ist eine Schranke am Ende, kein Lernpfad.
Höchstens 27 der 104 Anfragen betrafen Mitarbeiterschulungen. Fünf dieser 27 beschrieben Lernende in unterschiedlichen Rollen oder mit unterschiedlicher Erfahrung, etwa Sicherheitskräfte mit ihren Vorgesetzten oder neue HR-Mitarbeitende zusammen mit Trainern, Vorgesetzten und Führungskräften. Alle fünf wollten einen einzigen Kurs für alle.
Die Stichprobe ist klein, sie erfasst das Eingetippte und nicht die fertigen Kurse, und Trainer könnten Lernende außerhalb des Kurserstellers steuern, indem sie verschiedene Gruppen in verschiedene Kurse einschreiben. In dieser Stichprobe verlangte trotz gemischter Lerngruppe niemand mehr als einen Lernpfad. Wenn Sie also einen adaptiven Kurs wollen, schreiben Sie den Eingangstest, die Routing-Regel, das Vorgehen nach einer falschen Antwort und die Dokumentation selbst ins Briefing.
Vorteile des adaptiven Lernens
Adaptive Designs können folgende Vorteile bieten. Belege und Voraussetzungen unterscheiden sich dabei jeweils.
- Weniger Zeit für bereits Beherrschtes. Wenn ein Design das Überspringen von Inhalten erlaubt, nachdem Lernende das nötige Wissen nachgewiesen haben, kann das unnötiges Lernen reduzieren. Rechnen Sie neben den übersprungenen Inhalten auch die Zeit für die Diagnose mit ein.
- Bessere Ergebnisse bei klar definierten Aufgaben. Die Metaanalyse von Kulik und Fletcher von 2016 beziffert den Median des intelligenten Tutorings auf 0,66 Standardabweichungen über herkömmlichem Unterricht, überwiegend bei Kurstests statt bei breit angelegten Tests.
- Unterstützung, die zum Lernenden passt. Ein vollständiges Lösungsbeispiel hilft neuen Mitarbeitenden und kann Erfahrene behindern, das ist der Expertise-Reversal-Effekt. Routing kann unterschiedliche Unterstützung bieten, sofern die Diagnose und die verfügbaren Versionen zur vermittelten Fähigkeit passen.
- Sichtbare Lücken pro Lernziel. Wenn das Design jedes geforderte Lernziel prüft und hilfreiches Feedback gibt, kann der Trainer einzelne Lücken erkennen, statt sich auf einen Kursdurchschnitt zu verlassen. Das setzt nicht jedes adaptive System so um.
Nachteile und Grenzen des adaptiven Lernens
Adaptives Lernen verursacht echte Kosten, und die Belege reichen weniger weit als das Marketing.
- Die Belege sind bei klar definierten Aufgaben am stärksten. VanLehns Übersichtsarbeit umfasste MINT-Aufgaben mit richtigen und falschen Antworten und schloss Lesen, Fremdsprachen, Musik und Sport aus. Ermessensentscheidungen im Arbeitsalltag liegen weiter von dieser Datenbasis entfernt.
- In großen Studien und bei breit angelegten Tests schrumpfen die Effekte. Große Studien und standardisierte Tests zeigen deutlich kleinere Effekte als kleine Studien und Kursquizze. Planen Sie also mit der kleineren Zahl.
- Schwächere Lernende profitieren nicht immer. Im Mathematikunterricht an Schulen fanden Steenbergen-Hu und Cooper in den drei Studien, die sie gesondert auswiesen, einen negativen Effekt für leistungsschwache Schüler.
- Selbstgesteuertes Mastery Learning kann die Abschlussquote senken. Eine Metaanalyse zu Mastery Learning von 1990 von Chen-Lin Kulik und Kollegen fand in 108 Evaluationen positive Effekte auf Prüfungen, aber auch, dass „selbstgesteuerte Mastery-Programme in College-Kursen die Abschlussquoten häufig senken“. Ich habe nur das Abstract gelesen.
- Langsamere Lernende zahlen mit Zeit. Das sah Bloom schon 1968: „Ob sich Mastery Learning mit diesem großen Aufwand für Schüler lohnt, die womöglich mehrere Jahre brauchen, ist höchst fraglich.“ In einem betrieblichen Kurs fallen die Kosten geringer aus, aber Nachschulung und Coaching kosten trotzdem Stunden, die jemand finanzieren muss.
- Menschen kommen nicht immer zurück. Regeln und Algorithmen entscheiden, was als Nächstes kommt, aber sie können niemanden dazu bringen, es zu öffnen, wie die Fälle aus Tansania und den Niederlanden gezeigt haben.
- Mit jeder Verzweigung steigt der Aufwand für Erstellung und Pflege. Eine Kostenangabe aus einer wissenschaftlich begutachteten Veröffentlichung liegt mir nicht vor. Der zusätzliche Aufwand lässt sich aber konkret beschreiben: Jeder Lernpfad braucht Inhalte, die jemand schreibt, prüft und bei Änderungen der SOP aktualisiert. Zwei Fragen pro Lernziel im Eingangstest, zwei in jedem Modulcheck, zwei weitere nach der Nachschulung und vier im Abschlusscheck ergeben für die vier GDocP-Lernziele 28 Szenariofragen, noch vor den Rollenmodulen.
- Regeln können Lernende nur anhand dessen leiten, was die Fragen messen. Wer zwei Szenariofragen richtig beantwortet, datiert ein Protokoll womöglich trotzdem zurück, wenn an der Linie viel los ist. Abschlusscheck, Dokumentation und Abweichungsprotokoll gibt es, weil der Eingangstest die echte Arbeit nicht ersetzt.
- Algorithmen sind schwer zu erklären. Das Rahmenwerk von Wayne Holmes und Kollegen von 2022 zur Ethik von KI in der Bildung fordert Aufmerksamkeit für „Fairness, Rechenschaftspflicht, Transparenz, Verzerrung, Autonomie, Handlungsfähigkeit und Inklusion“. Fragen Sie sich in einem regulierten Arbeitsumfeld, ob Sie einem Auditor erklären könnten, warum eine Person an einem Modul vorbeigeleitet wurde und eine andere nicht.
Adaptives Lernen mit einem KI-Kursersteller umsetzen
Am 12. Oktober 2026 habe ich Coursebox damit beauftragt, die GDocP-Auffrischung zu erstellen. Coursebox ist unser Produkt, bewerten Sie meinen Bericht also entsprechend. Das Briefing enthielt die vier SOP-Regeln im Wortlaut, die vier Lernziele, die vier beispielhaften Fragen des Eingangstests mit Antworten, die Routing-Regel, die Modulchecks, Nachschulung und Coaching-Termin, die beiden Rollenmodule, einen Abschlusscheck für alle und als allerletzten Abschnitt eine Zusammenfassung. Darin stand: „Sorgen Sie dafür, dass der Kurs jeden Lernenden tatsächlich zu den richtigen Modulen schickt, und sagen Sie ihm nicht nur, welche er lesen soll.“
Die erste Gliederung war zu dünn: 3 Abschnitte, 3 Seiten und ein Quiz, das Routing nur in einem Seitentitel. In einer Folgenachricht verlangte ich die Abschnitte in der gebrieften Reihenfolge und forderte den KI-Kursersteller auf, das Routing wirklich umzusetzen oder klar zu sagen, dass er das nicht kann. Danach stimmte die Reihenfolge, und auf die Routing-Frage antwortete das Tool direkt. Die zweite Gliederung hatte 10 Abschnitte in der gewünschten Reihenfolge. Im generierten Kurs war der Eingangstest ein Quiz mit einer Bestehensgrenze von 80 %, jedes Lernziel hatte eine Modulseite, einen Wissenscheck und eine Nachschulungsseite, die Nachschulungsseite zu Modul 1 behielt die Eskalation zum Coaching-Termin bei, und es folgten die beiden Rollenmodule und ein Abschlusscheck. Ehrlich war das Tool auch bei seiner Grenze: „Die Gliederung definiert die Überspring- und Nachschulungsregeln, aber ich kann in diesem Strukturschritt allein kein automatisches Routing nach Punktzahl oder Rolle erstellen; dieses Routing muss im Kurseditor oder LMS konfiguriert werden.“
Das eigentliche Problem zeigte sich erst in der Lernendenansicht. Im Menü sah jeder Lernende alle vier Module, alle vier Nachschulungsseiten und beide Rollenmodule. In den Standardeinstellungen war jeder Abschnitt „Locked“ (gesperrt), die Schaltfläche „Next“ blieb also deaktiviert, bis die aktuelle Aktivität abgeschlossen war, und ein Klick im Menü auf Modul 2 bewirkte nichts. Die Sperren halten jeden Lernenden in einem Abschnitt, bis er ihn beendet hat, und die vorgesehene Schranke hing an einer Gesamtnote von 80 %, die keine Mastery pro Lernziel belegte. Außerdem musste selbst eine Analystin mit 25 Jahren Erfahrung, die den Eingangstest mit Bestnote absolvierte, weiterhin jedes Modul, jede Nachschulungsseite und beide Rollenmodule durchlaufen. Im Kurseditor fand ich pro Abschnitt einen Schalter zwischen „Locked“ und offener Navigation, pro Block eine Sichtbarkeitseinstellung („Visible to everyone“, „Hidden from everyone“ oder „Hidden from learners“) und auf Kursebene die Option „Manage prerequisites“ für die Reihenfolge zwischen Kursen. Routing nach Punktzahl oder Rolle fand ich bei diesem Test in diesen Einstellungen nicht.
Also probierte ich den Workaround aus, den unser Support-Team beschrieben hatte, und überprüfte ihn im Produkt. Ich stellte die vier Lernzielmodule im Abschnittsmenü auf offene Navigation um, kontrollierte, dass Modul 1 offene Navigation anzeigte, wechselte in die Lernendenansicht und klickte aus dem Bereich von Modul 1 direkt auf die erste Seite von Modul 2, „Correct Without Obscuring“ (etwa: Korrigieren, ohne unleserlich zu machen). Sie öffnete sich. Vor der Änderung bewirkte derselbe Klick nichts.
Die offene Navigation im gesamten Kurs gab den Lernenden die Kontrolle über die Reihenfolge. Allein damit war noch keine leistungsbasierte Adaptivität umgesetzt, denn sie wählte keine Lernzielmodule anhand des Eingangstests aus. Der vorgeschlagene Workaround braucht ein geprüftes Ergebnis pro Lernziel, ausdrückliche Anweisungen zum Lernpfad, eine benannte Person, die den Lernpfad zuweist und dokumentiert, sowie die vorgeschriebenen Abschlusschecks. Er bleibt ein Vorschlag und keine in diesem Kurs getestete Routing-Funktion.
Gliederung, Editoreinstellungen und Lernendenansicht habe ich mit meinem eigenen Konto geprüft. Die Quizze habe ich nicht als zwei getrennte Testlernende absolviert. Ich habe also nicht gesehen, ob die Schranke nach der Änderung einen scheiternden Lernenden aufhält, und weder Voraussetzungen noch Lernpfade getestet oder geprüft, was der Lernendenbericht erfasst. Vor dem Einsatz sind noch zwei kleinere Korrekturen nötig: Der generierte Eingangstest hatte 4 statt der gebrieften 8 Fragen, und die Nachschulungsseite zu Modul 1 änderte eine Tatsache aus dem Briefing und beschrieb den Mitarbeiter so, als habe er die Wägung „als 11:30 Uhr“ eingetragen, obwohl der Fehler im Briefing darin bestand, um 11:30 Uhr 10:05 Uhr einzutragen. Die geänderte Navigation erlaubte meinem Konto, zwischen Abschnitten zu wechseln. Sie sorgte aber weder für ein geprüftes Ergebnis pro Lernziel noch für die Durchsetzung einer Überspringregel oder die Überprüfung der Lernendendokumentation. Das muss bei der Umsetzung noch geprüft werden.
Überarbeiten oder ersetzen Sie vor dem Einsatz dieses Kurses den Eingangstest mit vier Fragen so, dass er die vorgesehenen Entscheidungen pro Lernziel stützt, korrigieren Sie die 80-%-Gesamtregel, und testen Sie jeden Lernpfad für Bestehen, Nichtbestehen, Wiederholung und Weiterleitung. Ein Kurs mit offener Navigation und eine Fortschrittsanzeige in Prozent stellen weder das Routing noch die Mastery-Checks aus dem Briefing sicher. Weitere Produkttests liegen diesem Abschnitt nicht zugrunde.
Eine Fragenbank mit Platz für zwei Szenariofragen pro Lernziel, die richtige Antwort und was eine falsche Antwort verrät, dazu eine Routing-Tabelle für jedes Ergebnis (Überspringen, Modul absolvieren, Nachschulung, Coaching-Termin, Abschlusscheck, Zuweisung nach Rolle) und eine Checkliste, um die Regeln vor der Erstellung zu testen. Teilweise ausgefüllt für die Auffrischungsschulung zur Guten Dokumentationspraxis, mit leeren Seiten. Bearbeitbare Word-Datei auf Englisch, ohne Angabe einer E-Mail-Adresse.
So bringen Sie adaptives Lernen in die Praxis
Im Kern ist adaptives Lernen ein Kurs, der anhand von Daten entscheidet, was eine Person als Nächstes bekommt. In den meisten Mitarbeiterschulungen genügen dafür wenige Szenariofragen pro Lernziel und eine Handvoll Regeln, die sich aufschreiben und nachvollziehbar erklären lassen. Die Forschung spricht vor allem für die Zeitersparnis bei allen, die den Stoff schon kennen, und für Lerngewinne beim vermittelten Stoff, weniger bei breit angelegten Messungen. Zwei Sigma lassen sich damit nicht versprechen.
Adaptivität ist deshalb zuerst eine Designaufgabe und erst danach eine Kaufentscheidung für Software. Legen Sie Lernziele, Fragen, Regeln, die Unterstützung nach einem nicht bestandenen Check und die Dokumentation fest, und klären Sie dann, wer welchen Lernpfad zuweist.
Am besten fangen Sie klein an: Nehmen Sie eine Pflichtschulung, die Ihre Mitarbeitenden jedes Jahr wiederholen, schreiben Sie zu jedem ihrer Lernziele zwei Szenariofragen und probieren Sie diese mit drei erfahrenen und drei neuen Mitarbeitenden aus, bevor Sie irgendetwas erstellen.
Häufig gestellte Fragen
Beim adaptiven Lernen ändert sich, was jeder Lernende als Nächstes bekommt: Inhalte, Reihenfolge, Tempo, Feedback oder Tests. Grundlage sind Daten zu genau dieser Person, meist ihre Antworten, die nach Regeln eines Instructional Designers oder von einem Softwaremodell ausgewertet werden. Die Regeln können so einfach sein wie das Überspringen eines Moduls nach einem Eingangstest oder so komplex wie ein Tutorsystem, das die Beherrschung jeder einzelnen Fähigkeit schätzt.
Ein regelbasiertes Beispiel ist eine Fragenbank, die eine Frage nach 12 Tagen erneut stellt, wenn sie falsch beantwortet wurde, und nach 24 Tagen, wenn sie richtig beantwortet wurde, und sie nach zwei richtigen Antworten in Folge aussortiert, wie in einer Studie von 2014 mit Behandelnden in den USA. Ein algorithmisches Beispiel ist ein Tutorsystem, das für jede Fähigkeit eine Beherrschungswahrscheinlichkeit berechnet und Übungen zuweist, bis diese 0,95 erreicht. In Mitarbeiterschulungen ist ein Eingangstest geläufig, mit dem Mitarbeitende Module überspringen, deren Inhalte sie nachweislich schon beherrschen.
Adaptive Lernsysteme werden meist in drei Teilen beschrieben: einem Domänenmodell, das den Stoff in Lernziele oder Fähigkeiten mit passenden Fragen gliedert, einem Lernermodell, das schätzt, was jeder Lernende kann, und einem Instruktionsmodell aus Regeln oder Algorithmen, das den nächsten Schritt wählt. Auch ein regelbasierter Kurs hat alle drei, selbst wenn das Lernermodell nur aus den dokumentierten Ergebnissen des Eingangstests besteht.
Adaptive Kurse verursachen mehr Schreib- und Pflegeaufwand, weil jeder Lernpfad eigene Inhalte und Fragen braucht. Die Belege sind bei klar definierten Aufgaben am stärksten und werden bei breit angelegten Tests und beim Einsatz in größerem Maßstab schwächer. Algorithmen lassen sich Lernenden und Auditoren oft schwer erklären, selbstgesteuertes Mastery Learning kann die Abschlussquote senken, und kein System bringt Menschen dazu, für Auffrischungen zurückzukommen, für die sie keine Zeit haben.
Beim adaptiven Lernen ändert der Kurs oder das System anhand von Daten zur Person, meist ihrer Antworten, was sie als Nächstes bekommt. Für personalisiertes Lernen gibt es keine gemeinsame Definition. Meist bedeutet es, das Lernen auf die Bedürfnisse, Ziele und Interessen jeder Person zuzuschneiden, oft über ein ganzes Programm hinweg und oft nach Entscheidung der Lernenden oder einer Lehrkraft. Adaptives Lernen ist ein Weg zur Personalisierung, aber Personalisierung muss nicht adaptiv sein.
Carolina Martin
Carolina ist eine hocherfahrene Lerndesignerin mit Erfahrung in Tech-Start-ups. Sie ist in Sydney ansässig und hat zuvor gemeinsam mit Coursebox-Gründer Travis in einem früheren Job Kurse entworfen. Sie ist leidenschaftlich daran interessiert, ansprechende Lernerfahrungen zu bieten, und bringt dieselbe Perspektive auch in die Kundenerfahrung ein. Sie verwaltet unsere Kundensupport-Dokumentation und die Produkttestprozesse.

