

Kognitive Theorie des multimedialen Lernens: Mayers Prinzipien
Mayers kognitive Theorie des multimedialen Lernens verständlich erklärt: drei Grundannahmen, alle 15 Prinzipien mit Effektstärken, wann sie wirken, und zwei kostenlose Vorlagen.

Die kognitive Theorie des multimedialen Lernens ist Richard Mayers Erklärung dafür, wie Menschen aus Wort und Bild lernen. Sie beruht auf drei Annahmen: Sprache und Bilder laufen über getrennte Kanäle, jeder Kanal fasst nur wenig auf einmal, und Lernen erfordert aktive Verarbeitung.
- Mayers Liste der Gestaltungsprinzipien wuchs von 7 (2001) auf 12 (2009) und schließlich auf 15 in der Auflage seines Buchs von 2021.
- Drei der 15 Prinzipien zeigen, dass ein beliebtes Extra nicht zuverlässig hilft, etwa das Gesicht der sprechenden Person im Bild oder Virtual Reality.
- Das Redundanzprinzip rät davon ab, den Sprechertext zusätzlich neben einer vertonten Grafik einzublenden, vor allem bei Lerneinheiten mit hohem Tempo.
- Mayers Prinzipien helfen am meisten bei Neulingen, komplexem Stoff und Lerneinheiten, die am Stück durchlaufen. Bei erfahrenen Lernenden können sie dagegen den Lernprozess behindern.
- In einer Stichprobe von 112 Kursanfragen an Coursebox wünschten sich bis zu 57 kurze Abschnitte und höchstens 7 eine Vertonung.
Fünf Planungsfragen für einen Kurs. Diese Checkliste ist nicht validiert. Prüfen Sie jede Antwort einzeln; die Gesamtpunktzahl sagt nichts darüber aus, ob der Kurs stimmig, startklar oder wirksam ist.

Vom Storyboard zum interaktiven Kurs in wenigen Minuten
Erste Arbeitswoche im Labor: Eine neue Fachkraft klickt sich durch eine vertonte Foliensammlung zur Tischzentrifuge. Die Sprechstimme liest genau den Absatz vor, der auch auf der Folie steht, ein Stockfoto mit lächelnder Wissenschaftlerin füllt die halbe Fläche, im Hintergrund läuft Musik, und die einzige Skizze, die zeigt, wohin die Röhrchen gehören, steht auf einer anderen Folie als der Text, der sie erklärt. Irgendwann ist das Video zu Ende. Trotzdem belädt sie den Rotor danach mit Unwucht.
Bei Coursebox arbeite ich als Instructional Designer. Wir entwickeln ein Autorentool für Instruktionsdesign, das aus einem Briefing eine Kursgliederung mit Seiten, Bildern, Videos und Szenarien erstellt. Wie sich Text und Bild einen Bildschirm teilen, beschäftigt mich also jeden Tag. Richard Mayers kognitive Theorie des multimedialen Lernens erklärt, was in diesem Video schiefgelaufen ist, und seine Prinzipien zeigen, wie es besser geht. In diesem Leitfaden geht es um die Theorie selbst, um die 15 Prinzipien samt der Evidenz dahinter, um die Situationen, in denen sie am meisten bringen, und um denselben Zentrifugenkurs, neu gestaltet nach diesen Regeln.
Was ist die kognitive Theorie des multimedialen Lernens?
Die kognitive Theorie des multimedialen Lernens ist Richard Mayers Erklärung dafür, wie Menschen aus Wörtern und Bildern lernen. Sie stützt sich auf drei Annahmen: Menschen verarbeiten verbale und visuelle Informationen in getrennten Kanälen, jeder Kanal kann nur wenig gleichzeitig aufnehmen, und Lernen erfordert aktive Verarbeitung.
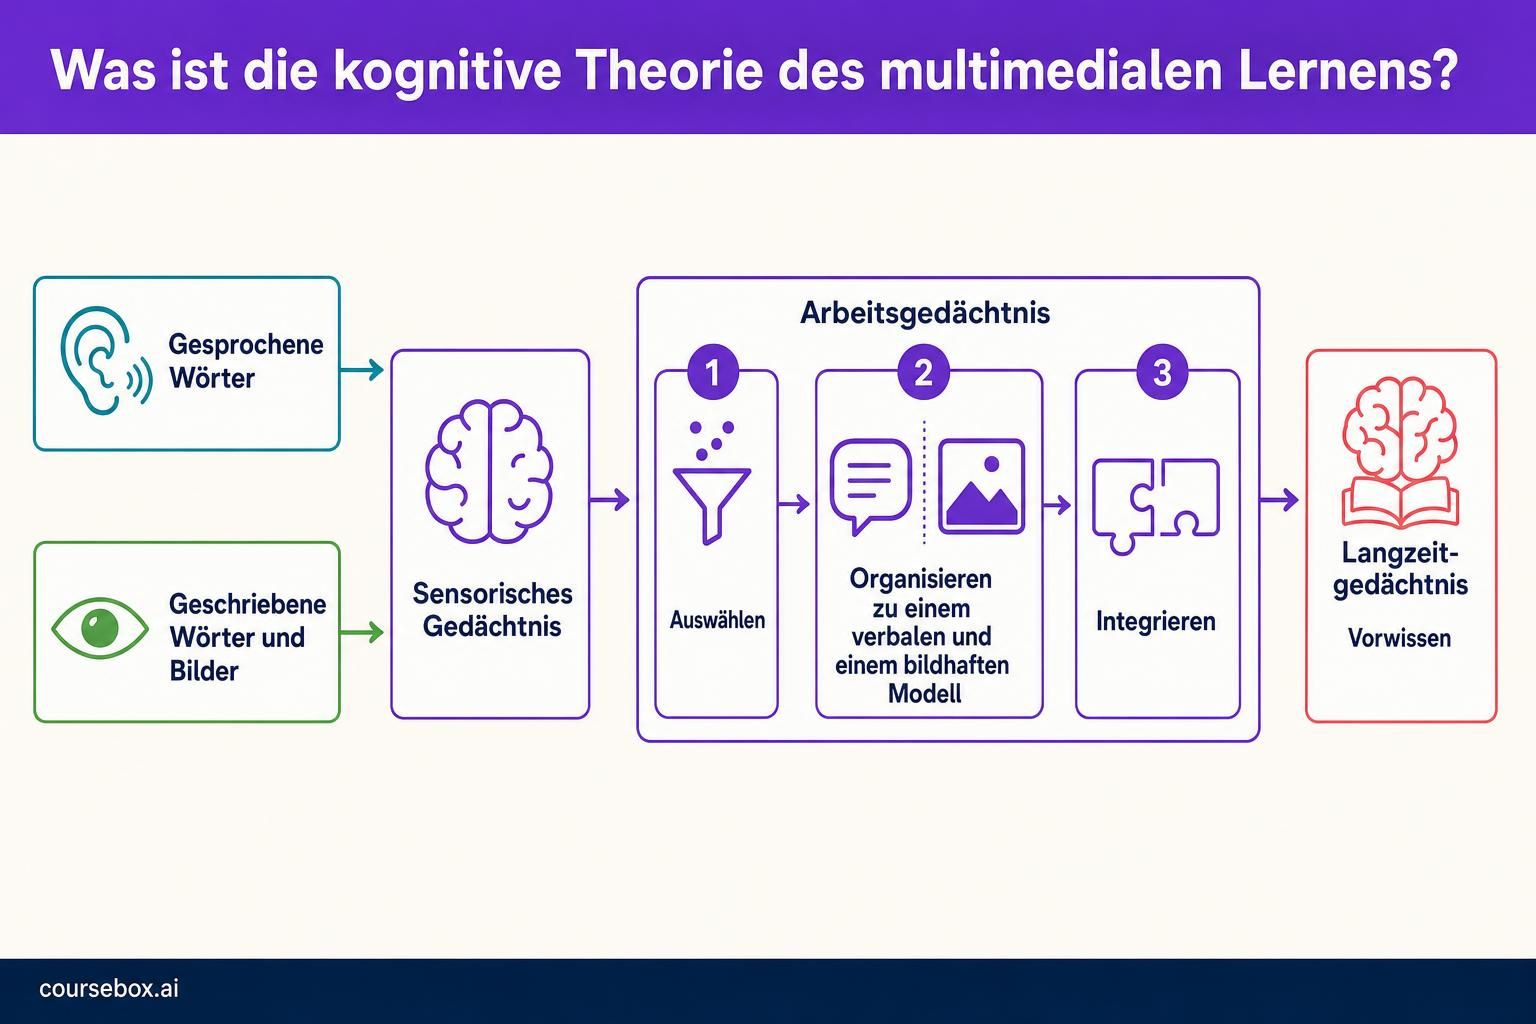
Diagramm in voller Größe ansehen
Die Theorie gilt für das, was Mayer eine multimediale Lernbotschaft nennt: „Lernmaterial aus Wörtern (z. B. gedrucktem oder gesprochenem Text) und Grafiken (z. B. Illustrationen, Fotos, Animationen, Videos oder immersiver virtueller Realität), das bei Lernenden neues Wissen oder neue Fähigkeiten fördern soll“. Diese Definition stammt aus Mayers frei zugänglichem Überblicksartikel von 2024 über Vergangenheit, Gegenwart und Zukunft der Theorie. Er ist die aktuelle Darstellung aus der Hand ihres Urhebers. Eine Foliensammlung mit Sprechertext, ein Erklärvideo, eine E-Learning-Seite mit Diagramm und ein gedrucktes Handbuch mit Abbildungen zählen alle dazu. Mayer will erklären, wie Menschen daraus „akademische Inhalte“ lernen. Gemessen wird das mit Transfertests, in denen die Lernenden das Gelernte auf neue Situationen anwenden müssen.
Die drei Annahmen in Mayers eigenen Worten (2024, S. 17):
- Duale Kanäle: „Menschen verfügen über getrennte, aber miteinander interagierende Kanäle für die Verarbeitung auditiv-verbaler und bildlich-visueller Informationen“.
- Begrenzte Kapazität: „Menschen können in jedem Kanal nur wenige Informationseinheiten gleichzeitig verarbeiten“.
- Aktive Verarbeitung: „Bedeutungsvolles Lernen findet statt, wenn Lernende während des Lernens angemessene kognitive Verarbeitungsprozesse ausführen“. Gemeint ist: auswählen, worauf man achtet, es ordnen und mit dem Vorwissen verknüpfen.
Mayers Modell verteilt das auf drei Gedächtnisspeicher und fünf Prozesse. Wörter und Bilder gelangen über Ohren und Augen ins sensorische Gedächtnis. Die Lernenden wählen einige der Wörter und Bilder für das Arbeitsgedächtnis aus, ordnen die Wörter zu einem verbalen und die Bilder zu einem bildhaften Modell und verknüpfen beide miteinander und mit Vorwissen aus dem Langzeitgedächtnis. Ein Detail erklärt, warum so viele Folien schlecht gestaltet sind: Geschriebene Wörter kommen über die Augen herein. Text auf dem Bildschirm konkurriert deshalb mit dem Bild um denselben visuellen Kanal, obwohl er sprachlich ist.
Weil das Arbeitsgedächtnis begrenzt ist, beschreibt Mayer drei Anforderungen, die eine Lerneinheit daran stellt (2024, S. 18):
- Extrinsische Verarbeitung dient keinem Lernziel und entsteht durch schlechte Gestaltung, etwa durch irrelevante Bilder oder Wörter.
- Essenzielle Verarbeitung ist die Arbeit, den Stoff selbst mental abzubilden. Sie steigt, je komplexer der Stoff für die jeweilige Person ist.
- Generative Verarbeitung ist die Anstrengung, den Stoff wirklich zu verstehen, und hängt davon ab, wie motiviert die Lernenden sind.
Aus jeder Anforderung folgt ein Gestaltungsziel: extrinsische Verarbeitung minimieren, essenzielle Verarbeitung steuern und generative Verarbeitung fördern. Jedes Prinzip dient einem dieser drei Ziele. Es handelt sich um Prüfpunkte, die gemeinsam gelten, nicht um eine Abfolge von Phasen.
Die 15 Prinzipien im Überblick
Die Tabelle folgt Mayers eigener Zusammenfassung der 15 Prinzipien aus der dritten Auflage seines Buchs Multimedia Learning (2021), wie sie in Tabelle 6 seines Überblicksartikels von 2024 unter einer CC-BY-4.0-Lizenz veröffentlicht ist. Die Effektstärken sind Mediane über die Experimente in Mayers Labor, angegeben als Cohens d. Nach Cohens Faustregel gilt 0,2 als kleiner, 0,5 als mittlerer und 0,8 als großer Effekt. Die Spalte „Tests“ zeigt, wie viele experimentelle Vergleiche hinter jedem Median stehen. Die Prinzipien nenne ich mit ihren deutschen Bezeichnungen, Mayers englische Originalnamen stehen in Klammern.
| Ziel | Prinzip | Was es besagt, in einfachen Worten | Effektstärke (2021) | Tests |
|---|---|---|---|---|
| Extrinsische Verarbeitung reduzieren | Kohärenz (Coherence) | Alles streichen, was dem Lernziel nicht dient | 0,86 | 19 |
| Extrinsische Verarbeitung reduzieren | Signalisierung (Signaling) | Hinweise ergänzen, die die Struktur des wesentlichen Stoffs hervorheben | 0,69 | 16 |
| Extrinsische Verarbeitung reduzieren | Redundanz (Redundancy) | Bei vertonten Grafiken keinen Text einblenden, der den Sprechertext wiederholt, wenn die Lerneinheit schnell abläuft | 0,10 | 12 |
| Extrinsische Verarbeitung reduzieren | Räumliche Nähe (Spatial contiguity) | Wörter nah an den Bildteilen platzieren, die sie beschreiben | 0,82 | 9 |
| Extrinsische Verarbeitung reduzieren | Zeitliche Nähe (Temporal contiguity) | Wörter und passende Bilder gleichzeitig darbieten | 1,31 | 8 |
| Essenzielle Verarbeitung steuern | Segmentierung (Segmenting) | Eine Lerneinheit in Abschnitte gliedern, deren Tempo die Lernenden bestimmen | 0,67 | 7 |
| Essenzielle Verarbeitung steuern | Vorab-Einführung (Pretraining) | Namen und Merkmale der zentralen Begriffe zuerst vermitteln | 0,78 | 10 |
| Essenzielle Verarbeitung steuern | Modalität (Modality) | Eine Grafik mit gesprochenem statt eingeblendetem Text erklären | 1,00 | 19 |
| Generative Verarbeitung fördern | Wort und Bild (Multimedia) | Wörter und Bilder statt nur Wörter verwenden | 1,35 | 13 |
| Generative Verarbeitung fördern | Personalisierung (Personalization) | Texte im Gesprächston formulieren | 1,00 | 15 |
| Generative Verarbeitung fördern | Stimme (Voice) | Mit freundlicher menschlicher Stimme statt mit Computerstimme sprechen | 0,74 | 7 |
| Generative Verarbeitung fördern | Bild der sprechenden Person (Image) | Das Bild der sprechenden Person einzublenden, hilft nicht zuverlässig | 0,20 | 7 |
| Generative Verarbeitung fördern | Verkörperung (Embodiment) | Ist eine vortragende Person im Bild: Gestik, Bewegung und Blickkontakt nutzen | 0,58 | 17 |
| Generative Verarbeitung fördern | Immersion (Immersion) | 3D-Virtual-Reality schneidet nicht zuverlässig besser ab als dieselbe Lerneinheit am Desktop | -0,10 | 9 |
| Generative Verarbeitung fördern | Generative Aktivität (Generative activity) | Lernende anleiten, während des Lernens zusammenzufassen, zu erklären oder sich selbst abzufragen | 0,71 | 44 |

Fallstudie: Compliance-Schulung für Apothekerinnen und Apotheker in Houston
Schulungen zur aktuellen Guten Herstellungspraxis (cGMP) sind in den USA für alle, die in der pharmazeutischen Herstellung arbeiten, bundesrechtlich vorgeschrieben, und die übliche Fassung besteht aus textlastigen regulatorischen Inhalten. Forschende des College of Pharmacy der University of Houston haben ein cGMP-Schulungsvideo neu gestaltet und mit Apothekerinnen und Apothekern aus dem Raum Houston getestet.
- Was sie gemacht haben: Sie wendeten Mayers Prinzipien zusammen mit der Cognitive Load Theory und weiteren Änderungen am Präsentationsdesign an. Der Bildschirmtext wurde auf Kernpunkte gekürzt, rund 90 % weniger als im Standardvideo, die Erklärung wanderte in den Sprechertext, zentrale regulatorische Punkte wurden mit Kontrastfarbe und Unterstreichung hervorgehoben, und die Folien nutzten randlose Fotos.
- Evidenz und Ergebnis: In einer 2026 veröffentlichten randomisierten Crossover-Studie sahen 49 Apothekerinnen und Apotheker je ein Standard- und ein neu gestaltetes Video in zufälliger Reihenfolge und wurden direkt nach jedem Video getestet. Die neue Fassung erzielte im Wissenstest 78 % gegenüber 72 % (p = 0,04), und die selbst eingeschätzte mentale Anstrengung sank von 3,5 auf 2,4.
- Einschränkung: Die beiden Videos behandelten unterschiedliche regulatorische Teilabschnitte, sodass sich Thema und Gestaltung nicht sauber trennen lassen. Außerdem bekam die neue Fassung Hintergrundmusik im Intro und Outro, wovon das Kohärenzprinzip abrät. Gemessen wurde nur unmittelbar danach, und niemand prüfte die Einhaltung im Arbeitsalltag.
- Erkenntnis: Eine Überarbeitung, die den Bildschirmtext auf Kernpunkte reduzierte, die Erklärung in den Sprechertext verlagerte und die Kernpunkte hervorhob, ging neben anderen Änderungen mit einem moderaten unmittelbaren Zuwachs und einem deutlichen Rückgang der empfundenen Anstrengung einher. Für folienlastige Compliance-Videos ist das ein günstiger erster Schritt. Prüfen Sie danach, was die Lernenden später noch wissen.
Wer hat die Theorie entwickelt, und wie viele Prinzipien gibt es?
Richard Mayer hat die Theorie mit Kolleginnen und Kollegen aus Experimenten entwickelt, die 1989 begannen. Ausgangspunkt war das spätere Multimedia-Prinzip, nach dem Menschen mit Wörtern und Bildern besser lernen als mit Wörtern allein; um diese Ergebnisse herum entstand die Theorie. Mayer benennt die Ideen, auf denen er aufbaut. Die dualen Kanäle stammen aus Allan Paivios Theorie der dualen Kodierung und Alan Baddeleys Arbeitsgedächtnismodell. Die begrenzte Kapazität stützt sich auf George Miller, Baddeley und John Sweller, dessen Cognitive Load Theory Mayer als konkurrierende Theorie beschreibt, bei der er Anleihen gemacht hat. Die aktive Verarbeitung geht auf Merlin Wittrocks Arbeiten zum generativen Lernen zurück. Diese Bezüge legt Mayer in seinem Überblicksartikel von 2024 dar.
Der Name hat sich erst nach und nach gefestigt. Mayers eigene Chronik nennt ein „Modell des bedeutungsvollen Lernens“, ein „Dual-Coding-Modell“ und das Modell aus Auswählen, Organisieren und Integrieren; in Aufsätzen von 1996 bis 2000 taucht dann der Name „kognitive Theorie des multimedialen Lernens“ auf. Das bekannte Diagramm stammt aus der ersten Auflage von Multimedia Learning (2001), und in jeder Auflage von The Cambridge Handbook of Multimedia Learning (2005, 2014 und 2022) hat die Theorie ein eigenes Kapitel. Mayer gehört außerdem zu den Autoren der Überarbeitung von Blooms Taxonomie aus dem Jahr 2001.
Wie viele Prinzipien es gibt, hängt von der Auflage ab. Mayers eigene Zählung nach den Tabellen 3 und 4 des Überblicksartikels von 2024:
| Auflage von Multimedia Learning | Prinzipien | Experimentelle Vergleiche | Was sich geändert hat |
|---|---|---|---|
| 1. Auflage, 2001 | 7 | 45 | Multimedia, räumliche Nähe, zeitliche Nähe, Kohärenz, Modalität, Redundanz und individuelle Unterschiede |
| 2. Auflage, 2009 | 12 | 93 | Neu: Signalisierung, Segmentierung, Pretraining, Personalisierung, Stimme und Bild; individuelle Unterschiede kein eigenes Prinzip mehr |
| 3. Auflage, 2021 | 15 | 201 | Neu: Verkörperung, Immersion und generative Aktivität |
„Mayers 12 Prinzipien“, die am häufigsten zitierte Liste, stammen aus der zweiten Auflage von 2009: Multimedia, Kohärenz, Signalisierung, Redundanz, räumliche Nähe, zeitliche Nähe, Segmentierung, Pretraining, Modalität, Personalisierung, Stimme und Bild. Die Liste stimmt, ist aber nicht mehr aktuell. Verkörperung gehört zur Auflage von 2021, nicht zu den zwölf von 2009. Es kursieren auch andere Zählungen: Mayers Artikel von 2008 in American Psychologist fasste 10 Prinzipien zusammen, ein Zeitschriftenüberblick von ihm aus dem Jahr 2017 nennt eine andere Zwölferliste mit Verkörperung, aber ohne Bild, und das Handbuch von 2022 behandelt 31 Prinzipien aus vielen Forschungsgruppen. Wenn Ihnen eine Liste begegnet, prüfen Sie, aus welcher Quelle sie stammt.
Welche Werke von Mayer sich lohnen
- Beginnen Sie mit Mayers frei zugänglichem Überblicksartikel von 2024: Er behandelt die Theorie, die fünfzehn Prinzipien und wie weit die Evidenz jeweils trägt.
- Für E-Learning im Unternehmen empfiehlt sich e-Learning and the Science of Instruction von Ruth Colvin Clark und Richard Mayer, fünfte Auflage (2024). Das Buch überträgt die Prinzipien auf die Gestaltung von Schulungen.
- Die vollständige Evidenz und die Randbedingungen jedes Prinzips finden Sie in Multimedia Learning, dritte Auflage (2021), erschienen bei Cambridge University Press.
Das Praxisbeispiel: ein Sicherheitskurs für die Zentrifuge
Um die Prinzipien in der Anwendung zu zeigen, begleitet ein fiktiver Kurs den Rest dieses Leitfadens: der Kurs aus der Eingangsszene. Ein Labor arbeitet neue Fachkräfte ein, die die Tischzentrifuge sicher bedienen sollen. Manche haben ein naturwissenschaftliches Studium, manche arbeiten in einer Zweitsprache, doch niemand kennt dieses Modell, und niemand wurde je auf dessen Alarm geschult. Der Ablauf hat sechs Teile: Röhrchen einsetzen, austarieren, Lauf starten, Lauf stoppen, entnehmen und auf einen Unwuchtalarm reagieren. Die Lernenden erhalten die schriftliche Arbeitsanweisung des Labors und das Herstellerhandbuch, und der Kurs soll sie auf einen ersten Lauf unter Aufsicht vorbereiten. Ziel ist, dass jede Fachkraft einen ausgewuchteten Rotor beladen, einen Lauf sicher starten und stoppen und richtig auf den Alarm reagieren kann, beurteilt von einer Aufsichtsperson direkt am Gerät.
Die bisherige Schulung ist eine vertonte Foliensammlung auf Basis des Handbuchs: ganze Absätze auf dem Bildschirm, die vorgelesen werden, ein dekoratives Foto auf den meisten Folien und die Rotorskizze auf einer anderen Folie als die Schritte, die sich darauf beziehen. An einem Zentrifugenkurs werden die meisten Prinzipien sichtbar, denn er hat benannte Bauteile, Schritte in fester Reihenfolge, Diagramme mit Beschriftung und eine zeitkritische Reaktion auf einen Alarm. Zugleich stößt er an die Grenzen der Theorie, denn Mayer hat sie vor allem an Erklärungen getestet, wie Systeme funktionieren, etwa Blitze, Bremsen und Pumpen. Sie auf Abläufe und motorische Fertigkeiten zu übertragen, ist eine Extrapolation, und ob sie trägt, zeigt sich erst am Gerät.
Extrinsische Verarbeitung reduzieren: fünf Prinzipien
Diese fünf Prinzipien reduzieren unnötigen Denkaufwand, damit den Lernenden mehr Kapazität für den eigentlichen Stoff bleibt.
Kohärenzprinzip
Menschen lernen besser, wenn überflüssiges Material weggelassen statt aufgenommen wird. Gemeint sind interessante, aber irrelevante Wörter, Bilder, Geräusche und Musik. Kohärenz bedeutet nicht „den Stoff klar darstellen“; das kommt eher der Signalisierung nahe.
- Was es besagt: Streichen Sie alles, was dem Lernziel nicht dient.
- Evidenz und Grenzen: Ein Median-Effekt von 0,86 aus 19 Tests. Laut Mayers Zusammenfassung von 2009 hilft Kohärenz womöglich am meisten Lernenden mit geringer Arbeitsgedächtniskapazität oder wenig Vorwissen zum Thema.
- Im Zentrifugenkurs: Die Firmengeschichte des Herstellers, die Hintergrundmusik und die Stockfotos fliegen raus. Es bleibt nur, was eine Fachkraft zum Beladen, Starten, Stoppen und Reagieren braucht.
Signalisierungsprinzip
Menschen lernen besser, wenn Hinweise die Struktur des wesentlichen Stoffs hervorheben.
- Was es besagt: Zeigen Sie den Lernenden mit Überschriften, einer Gliederung, Pfeilen oder Hervorhebungen, worauf sie achten sollen und wie die Teile zusammenhängen.
- Evidenz und Grenzen: Ein Median von 0,69 aus 16 Tests, gegenüber 0,52 aus 6 Tests im Jahr 2008.
- Im Zentrifugenkurs: Zu Beginn steht eine Übersicht der sechs Teile auf einem Bildschirm, jeder Bildschirm eines Teils trägt dieselbe Überschrift, und Deckelverriegelung sowie gegenüberliegende Röhrchenpositionen werden genau dann hervorgehoben, wenn der Sprechertext sie nennt.
Redundanzprinzip
Menschen lernen nicht besser, wenn zu Grafik und Sprechertext noch gedruckter Text hinzukommt, zumindest bei hohem Tempo. Oft wird das als Verbot gelesen, Wörter mit Bildern zu kombinieren. Das ist es nicht.
- Was es besagt: Wird eine Grafik bereits gesprochen erklärt, blenden Sie denselben Text nicht zusätzlich ein.
- Evidenz und Grenzen: Ein Median von nur 0,10 aus 12 Tests, und die Formulierung von 2021 beschränkt das Prinzip auf Lerneinheiten mit hohem Tempo. In ihrem Aufsatz von 2003 berichteten Mayer und Moreno das Gegenteil, wenn keine Animation gezeigt wurde: Sprechertext plus passender Bildschirmtext half. Eine Metaanalyse von Adesope und Nesbit aus dem Jahr 2012 mit 57 Studien ergab, dass gesprochene und geschriebene Wörter zusammen Lernenden mit wenig Vorwissen halfen, ebenso bei systemgesteuertem Tempo und bei Material ohne Bilder.
- Im Zentrifugenkurs: In der vertonten Animation eines Laufs zeigt der Bildschirm nur die Animation und kurze Beschriftungen wie „Rotor“ und „Deckelverriegelung“. Der vollständige Text gehört in ein Transkript oder auf eine Zusammenfassungsseite, nicht über die Animation.
Das Prinzip sagt weder „Grafik oder Text, nie beides“ noch „nie Informationen wiederholen“. Wörter nah am Bild betreffen das Prinzip der räumlichen Nähe, Wörter mit Bildern das Multimedia-Prinzip. Im Aufsatz von Mayer und Moreno aus dem Jahr 2003 wird der Redundanzeffekt „in einem engeren Sinn als bei Sweller“ definiert, nämlich als Wegfall „einer unnötigen Doppelung des wesentlichen Materials“: des Sprechertexts, der über einer vertonten Animation noch einmal gedruckt erscheint. Kurzer Bildschirmtext direkt neben dem Teil, den er benennt, kann weiterhin helfen.
Prinzip der räumlichen Nähe
Menschen lernen besser, wenn zusammengehörige Wörter und Bilder auf der Seite oder dem Bildschirm nah beieinander statt weit voneinander entfernt stehen.
- Was es besagt: Setzen Sie jede Beschriftung direkt an das Teil, das sie benennt, und jede Erklärung neben den Schritt, den sie beschreibt.
- Evidenz und Grenzen: Ein Median von 0,82 aus 9 Tests in Mayers Labor. Eine unabhängige Metaanalyse von Schroeder und Cenkci mit 58 Vergleichen und 2.426 Teilnehmenden fand für integrierte Gestaltungen g = 0,63: kleiner, aber immer noch deutlich.
- Im Zentrifugenkurs: Rotor, Becher, Deckelverriegelung und Alarmleuchte werden direkt im Diagramm beschriftet, nicht in einer Legende darunter. Das Feedback zu einer Quizfrage erscheint neben der Frage, nicht auf einem späteren Bildschirm.
Prinzip der zeitlichen Nähe
Menschen lernen besser, wenn zusammengehörige Wörter und Bilder gleichzeitig statt nacheinander dargeboten werden.
- Was es besagt: Nennen Sie jeden Schritt in dem Moment, in dem das Bild ihn zeigt, nicht vorher oder nachher.
- Evidenz und Grenzen: Der größte Median der Gruppe zur extrinsischen Verarbeitung: 1,31 aus 8 Tests. Laut Mayers Zusammenfassung von 2009 greift das Prinzip womöglich weniger, wenn sich kurze Abschnitte abwechseln oder die Lernenden das Tempo selbst steuern.
- Im Zentrifugenkurs: Der Sprechertext sagt „Deckel schließen, bis die Verriegelung einrastet“, während die Animation den Deckel beim Schließen zeigt, und nicht erst als Zusammenfassung am Ende des Clips.
Essenzielle Verarbeitung steuern: drei Prinzipien
Mancher Stoff ist für Neulinge komplex, wie gut er auch gestaltet ist. Diese drei Prinzipien verteilen die Last so, dass sie das Arbeitsgedächtnis nicht überfordert.
Segmentierungsprinzip
Menschen lernen besser, wenn eine multimediale Lerneinheit in Abschnitten dargeboten wird, deren Tempo sie selbst bestimmen, statt als durchgehende Einheit.
- Was es besagt: Gliedern Sie die Lerneinheit in sinnvolle Abschnitte und lassen Sie die Lernenden entscheiden, wann es weitergeht.
- Evidenz und Grenzen: Ein Median von 0,67 aus 7 Tests. Der eigentliche Wirkfaktor ist, dass die Lernenden das Tempo steuern. Mayer nennt keine Regel für die Länge eines Abschnitts; „Videos unter zehn Minuten halten“ ist also eine andere Aussage. Laut seiner Zusammenfassung von 2009 hilft Segmentierung am ehesten, wenn der Stoff komplex, die Darbietung schnell und die Lernenden unerfahren sind.
- Im Zentrifugenkurs: Ein kurzer Abschnitt pro Bildschirm, jeweils mit einer Weiter-Schaltfläche am Ende. Dieselbe Idee steckt hinter den meisten Microlearning-Videos.

Fallstudie: Ernährungsfachkräfte in 18 US-Bundesstaaten und -Territorien
Das Expanded Food and Nutrition Education Program (EFNEP) in den USA beschäftigt Ernährungsfachkräfte ohne Fachstudium, die Familien mit geringem Einkommen Ernährungswissen vermitteln. Sie sind über viele Bundesstaaten verteilt, haben einen unterschiedlichen Bildungsstand und hatten keine einheitliche Schulung: Diese unterschied sich von Bundesstaat zu Bundesstaat.
- Was sie gemacht haben: An der Colorado State University entstand im Rahmen einer Forschungsarbeit ein Online-Kurs zur Ernährung in der Schwangerschaft aus vierzig kurzen Videoclips. Er setzte die Prinzipien Multimedia, Modalität, Kohärenz, Segmentierung und Personalisierung um, kombiniert mit einem umfassenderen Instruktionsdesign-Modell und Rollenspielvideos. Gesprochen wurde im Gesprächston, und auf dekorative Hintergrundmusik wurde verzichtet.
- Evidenz und Ergebnis: In einer Doktorarbeit von 2016 wurden 139 Fachkräfte aus 18 Bundesstaaten und Territorien nach Bundesstaat dem Kurs oder einer Warteliste zugeteilt; ausgewertet wurden 131 (67 und 64). Nach dem Kurs erreichten 92 % der geschulten Gruppe im Wissenstest das festgelegte Kompetenzniveau, gegenüber 65 % der Personen auf der Warteliste. In einem Szenariotest, bei dem die Fachkräfte in Videos ungünstige Vermittlungspraxis erkennen sollten, lag das Verhältnis bei 95 % zu 75 %.
- Einschränkung: Die Vergleichsgruppe erhielt gar keine Schulung. Die Studie zeigt also, dass der Kurs gewirkt hat, nicht, dass Mayers Prinzipien den Zuwachs verursacht haben. Die Leistung bei der Vermittlung wurde nicht beobachtet, die Selbstwirksamkeit wurde selbst eingeschätzt, und die Tests hatten eine geringe interne Konsistenz.
- Erkenntnis: Bei räumlich verteilten Teilzeitkräften half ein Online-Kurs aus kurzen Clips den meisten Beschäftigten, das festgelegte Kompetenzniveau zu erreichen, während ungeschulte Kolleginnen und Kollegen es überwiegend nicht erreichten. Prüfen Sie das Urteilsvermögen mit Szenariofragen, nicht nur das Faktenwissen.
Pretraining-Prinzip
Menschen lernen besser aus einer multimedialen Lerneinheit, wenn sie Namen und Merkmale der zentralen Begriffe kennen. Pretraining ist ein Gestaltungsschritt, keine Aussage darüber, dass Lernende die Grundlagen schon mitbringen müssen.
- Was es besagt: Vermitteln Sie Bauteile und Begriffe vor der Lerneinheit, die zeigt, wie sie zusammenwirken.
- Evidenz und Grenzen: Ein Median von 0,78 aus 10 Tests.
- Im Zentrifugenkurs: Am Anfang steht eine Seite „Die Zentrifuge kennenlernen“ mit einem beschrifteten Diagramm, das Rotor, Becher oder Röhrchenhalter, Deckelverriegelung, Bedienfeld und Unwuchtalarm benennt. So kann der Ablauf darauf verweisen, ohne für Erklärungen anzuhalten.
Modalitätsprinzip
Menschen lernen besser aus Grafik und Sprechertext als aus Grafik und Bildschirmtext. Modalität und Redundanz sind zwei verschiedene Regeln. Modalität vergleicht gesprochenen Text mit gedrucktem Text neben einer Grafik. Redundanz fragt, ob zusätzlich zum Sprechertext noch gedruckter Text hinzukommen soll.
- Was es besagt: Braucht eine Grafik eine Erklärung, sprechen Sie diese, statt sie einzublenden.
- Evidenz und Grenzen: Ein Median von 1,00 aus 19 Tests, und 2008 schrieb Mayer, es habe „von allen untersuchten Prinzipien die stärkste Unterstützung“. Außerhalb seines Labors ist der Effekt kleiner, und in einer Studie im Schulunterricht von Harskamp und Kollegen, über die de Jong berichtet, verschwand er bei Lernenden, die das Lerntempo selbst bestimmen konnten. Mayers Zusammenfassung von 2009 ergänzt, dass gedruckte Wörter bei Lerneinheiten mit Fachbegriffen und Symbolen sowie bei Lernenden mit anderer Muttersprache sinnvoll sein können.
- Im Zentrifugenkurs: Die Animation eines Laufs wird vertont, Fachbegriffe wie die Drehzahleinstellung bleiben aber gedruckt neben dem Bedienfeld stehen, wo Beschäftigte, die in einer Zweitsprache arbeiten, sie nachlesen können.
Das Modalitätsprinzip gilt für alle Lernenden. Über „auditive“ oder „visuelle Lerntypen“ sagt es nichts. In seinem Artikel in American Psychologist von 2008 wies Mayer das Argument zurück, gedruckter Text erlaube es „Menschen, die lieber lesen“, zu lesen, während andere zuhören. Sein eigenes Labor hat die Idee verbaler und visueller Lerntypen getestet: Pashler und Kollegen berichten in ihrem Überblick von 2008, dass Massa und Mayer über fast 20 Merkmale individueller Unterschiede hinweg „keine Belege“ dafür fanden, die Vermittlung an Vorlieben anzupassen. Die übrige Forschung zu Lernstilen weist in dieselbe Richtung.
Generative Verarbeitung fördern: sieben Prinzipien
Diese sieben Prinzipien ermutigen die Lernenden, sich die Mühe zu machen, den Stoff wirklich zu verstehen.
Multimedia-Prinzip
Menschen lernen besser aus Wörtern und Bildern als aus Wörtern allein.
- Was es besagt: Ergänzen Sie den Text um ein relevantes Bild. Ein rein dekoratives Bild verstößt dagegen gegen das Kohärenzprinzip.
- Evidenz und Grenzen: Der größte Median aller 15 Prinzipien: 1,35 aus 13 Tests. Laut Mayers Zusammenfassung von 2009 wirkt es womöglich stärker bei Lernenden mit wenig Vorwissen, die Hilfe brauchen, um Wörter und Bilder zu verknüpfen.
- Im Zentrifugenkurs: Ein Diagramm des Rotors mit vier Röhrchen in gegenüberliegenden Positionen, direkt neben dem Text, der das Austarieren erklärt.
Personalisierungsprinzip
Menschen lernen besser aus multimedialen Lerneinheiten, wenn die Texte im Gesprächston statt in förmlichem Stil verfasst sind.
- Was es besagt: Sprechen Sie die Lernenden direkt an und schreiben Sie so, wie eine Kollegin oder ein Kollege es erklären würde.
- Evidenz und Grenzen: Ein Median von 1,00 aus 15 Tests. Laut Mayers Zusammenfassungen wirkt es womöglich am besten bei Einsteigern und wenn es nicht übertrieben wird, bei langen Lerneinheiten vielleicht gar nicht. Eine randomisierte Studie von 2024 mit Apothekern, Ärzten und weiteren Gesundheitsfachkräften mit erweiterten klinischen Befugnissen ergänzte ein 30-minütiges Modul um Personalisierung und Verkörperung. Das Wissen unterschied sich nicht (Cohens d 0,02), obwohl die Lernenden die Elemente bemerkten.
- Im Zentrifugenkurs: „Setzen Sie das zweite Röhrchen genau gegenüber dem ersten ein“ statt „Röhrchen sind in gegenüberliegenden Positionen zu platzieren“.
Stimmprinzip
Menschen lernen besser, wenn der Sprechertext mit einer freundlichen menschlichen Stimme statt einer Computerstimme gesprochen wird.
- Was es besagt: Vertonen Sie mit einer freundlichen menschlichen Stimme statt mit einer Computerstimme.
- Evidenz und Grenzen: Ein Median von 0,74 aus 7 Tests; 2009 wurde es noch als vorläufiges Forschungsergebnis geführt. Die Quellen, die ich gelesen habe, testen keine heutigen KI-Stimmen. Ob eine bestimmte synthetische Stimme gut genug ist, kann das Prinzip also nicht entscheiden.
- Im Zentrifugenkurs: Spielen Sie die Vertonung vor dem Start ein oder zwei Fachkräften vor und ersetzen Sie jede Stimme, der sie schwer folgen können.
Bildprinzip
Menschen lernen aus einer multimedialen Lerneinheit nicht unbedingt besser, wenn das Bild der sprechenden Person eingeblendet wird.
- Was es besagt: Ein sprechender Kopf im Bild hilft dem Lernen nicht zuverlässig. Verboten ist er deshalb aber auch nicht.
- Evidenz und Grenzen: Ein Median von 0,20 aus 7 Tests. Mayers Handbuchkapitel von 2014 berichtete von 14 Tests, die Hälfte davon mit negativen oder vernachlässigbaren Effekten.
- Im Zentrifugenkurs: Während des Ablaufs bleibt die Zentrifuge im Bild, nicht das Gesicht der Trainerin oder des Trainers.
Verkörperungsprinzip (Embodiment)
Menschen entwickeln ein tieferes Verständnis, wenn eine vortragende Person auf dem Bildschirm Gestik, Bewegung und Blickkontakt deutlich einsetzt, statt diese Ausdrucksmittel kaum zu nutzen. Das Prinzip ist neu in der Auflage von 2021.
- Was es besagt: Ist eine vortragende Person im Bild, sollte sie auf das zeigen und das anschauen, was die Lernenden sehen müssen.
- Evidenz und Grenzen: Ein Median von 0,58 aus 17 Tests. Es beschreibt, wie eine vortragende Person im Bild auftreten sollte, nicht, ob überhaupt eine zu sehen sein sollte. Die Studie von 2024 mit Gesundheitsfachkräften fand keinen signifikanten Unterschied im Wissen, als es zusammen mit Personalisierung ergänzt wurde.
- Im Zentrifugenkurs: Zeigt die Laborleitung die Reaktion auf den Alarm vor der Kamera, deutet sie auf Alarmleuchte und Stopptaste, während sie diese benennt.
Immersionsprinzip
Menschen lernen in immersiver 3D-Virtual-Reality nicht unbedingt besser als mit einer entsprechenden 2D-Darstellung am Desktop. Das Prinzip ist neu in der Auflage von 2021.
- Was es besagt: Virtual Reality verbessert das Lernen nicht von sich aus gegenüber derselben Lerneinheit am Bildschirm.
- Evidenz und Grenzen: Ein Median von -0,10 aus 9 Tests, also leicht zugunsten der Desktop-Version.
- Im Zentrifugenkurs: Eine Animation am Desktop und ein Lauf unter Aufsicht an der echten Zentrifuge, ohne VR-Brille.
Prinzip der generativen Aktivität
Menschen lernen besser, wenn sie während des Lernens angeleitet werden, generative Lernaktivitäten auszuführen. Das Prinzip ist neu in der Auflage von 2021, und hinter ihm stehen die meisten Tests.
- Was es besagt: Lassen Sie die Lernenden etwas mit dem Stoff tun: ihn zusammenfassen, sich selbst erklären oder sich selbst abfragen.
- Evidenz und Grenzen: Ein Median von 0,71 aus 44 Tests. Fiorella und Mayer (2016) beschreiben acht Aktivitäten: Zusammenfassen, Mapping, Zeichnen, Vorstellen, Selbsttest, Selbsterklärung, Lehren und Nachspielen.
- Im Zentrifugenkurs: Nach dem Abschnitt zum Austarieren entscheiden die Lernenden, wohin das vierte Röhrchen gehört, und begründen es. Der Alarmteil endet mit einem kurzen Szenario, in dem sie festlegen, was in welcher Reihenfolge zu tun ist. Ideen für interaktive E-Learning-Module passen genau hierher.
In der Praxis betrachte ich einen Bildschirm und stelle vier Fragen auf einmal: Was kann weg (Kohärenz)? Wohin soll der Blick fallen (Signalisierung)? Stehen die Wörter neben dem Bild (räumliche Nähe)? Wird der Sprechertext zusätzlich eingeblendet (Redundanz)? Ein Durchgang findet Probleme, die beim Abarbeiten Prinzip für Prinzip untergehen.
Wie belastbar ist die Evidenz hinter den Prinzipien?
Die Prinzipien beruhen auf mehr als 200 Experimenten, viele davon allerdings mit kurzen Lerneinheiten in Mayers Labor, und mehrere Effekte schrumpfen, je mehr Evidenz hinzukommt. Bevor Sie die Zahlen Stakeholdern präsentieren, sollten Sie drei Punkte im Blick haben.
Erstens: Drei der 15 Prinzipien zeigen, dass ein beliebtes Extra nicht zuverlässig hilft: zusätzlich eingeblendeter Text bei vertonten Grafiken (0,10, und nur bei hohem Tempo), das Bild der sprechenden Person (0,20) und Virtual Reality (-0,10).
Zweitens: Manche Effekte sind kleiner geworden, je mehr Evidenz vorlag.
Warum der Redundanzeffekt gesunken ist, sagen die Quellen, die ich gelesen habe, nicht, und ich will nicht spekulieren. Der Modalitätseffekt zeigt außerhalb von Mayers Labor dasselbe Muster. Eine Reanalyse von Reinwein aus dem Jahr 2012 verdoppelte die Datenbasis einer früheren Metaanalyse von Ginns, die d = 0,72 aus 43 Effekten gefunden hatte.
Drittens: Unabhängige Übersichtsarbeiten stützen nach wie vor den Kern der Theorie. In einem Überblick über Übersichtsarbeiten von Noetel und Kollegen aus dem Jahr 2022 berichtet die Zusammenfassung der Autoren von 29 Reviews mit 1.189 Studien und 78.177 Teilnehmenden, mit den größten Vorteilen für zeitliche und räumliche Nähe sowie Signalisierung. Laut derselben Zusammenfassung war gute Gestaltung bei komplexem Material und bei systemgesteuertem Tempo, etwa in Vorlesungen, wichtiger als bei selbstgesteuertem Lernen.
Nutzen Sie die Evidenz, um Gestaltungsänderungen zu finden, die einen Versuch wert sind, vor allem klarere Bezüge zwischen Beschriftungen, Bildern und Sprechertext. Effektstärken fassen unterschiedliche experimentelle Vergleiche zusammen; sie sind weder eine Rangliste austauschbarer Maßnahmen noch eine Prognose für Ihren Kurs. Prüfen Sie die jeweiligen Randbedingungen und testen Sie die Überarbeitung mit Ihren Lernenden.
Wann helfen Mayers Prinzipien am meisten?
In seinem Überblicksartikel von 2024 schreibt Mayer, dass jedes Prinzip Randbedingungen hat: „für wen das Prinzip gilt, für welche Art von Lerneinheit es gilt und unter welchen Umständen“. Drei Bedingungen tauchen immer wieder auf.
- Die Lernenden sind neu im Thema. Das Prinzip der individuellen Unterschiede aus der ersten Auflage besagte, dass Gestaltungseffekte bei Lernenden mit wenig Vorwissen stärker sind, weil sie Lücken nicht aus eigenem Wissen füllen können.
- Der Stoff ist für diese Lernenden komplex. Segmentierung und Modalität helfen am meisten, wenn viel gleichzeitig im Kopf behalten werden muss.
- Die Lerneinheit gibt das Tempo vor. Ein Video, das am Stück durchläuft, oder ein Live-Webinar lässt keine Zeit zum Nachlesen oder Wiederholen. Steuern die Lernenden das Tempo selbst, fallen die Gestaltungseffekte in den Studien kleiner aus.
Es gilt auch der Umkehrschluss. In einem Aufsatz von 2003 prägten Kalyuga und Kollegen den Begriff Expertise-Reversal-Effekt: „Instruktionstechniken, die bei unerfahrenen Lernenden sehr wirksam sind, können ihre Wirksamkeit verlieren und sogar negative Folgen haben, wenn sie bei erfahreneren Lernenden eingesetzt werden“. In einem ihrer Beispiele brauchten unerfahrene Elektro-Auszubildende Text, der in die Schaltpläne integriert war, während erfahrene mit dem Schaltplan allein besser zurechtkamen. Auch Sprechertext kann für Erfahrene überflüssig werden.
So lese ich diese Bedingungen für den Zentrifugenkurs. Die Tabelle ist meine Synthese der Quellen, keine Empfehlung von Mayer selbst.
| Ausgangslage | Prinzipien mit Vorrang | Was zurückgefahren werden kann |
|---|---|---|
| Neue Fachkräfte, vertontes Video, das am Stück durchläuft | Pretraining, Segmentierung, Modalität, räumliche und zeitliche Nähe, Signalisierung | Wenig; hier wirkt Gestaltung am stärksten |
| Erfahrene Fachkräfte, Auffrischung im eigenen Tempo | Kohärenz und generative Aktivität | Vollständiger Sprechertext und Schritt-für-Schritt-Beschriftungen, die sie nicht mehr brauchen |
| Lerneinheiten voller Fachbegriffe oder Beschäftigte, die in einer Zweitsprache arbeiten | Räumliche Nähe, mit zentralen Begriffen gedruckt neben dem Bild | Neue Begriffe ausschließlich gesprochen erklären |
| Gehörlose oder schwerhörige Lernende | Untertitel und Transkripte, dazu räumliche Nähe | Das Redundanzprinzip, das keinen Vorrang vor der Barrierefreiheit hat |
Halten Sie für aufgezeichnete, vertonte Videos genaue, synchronisierte Untertitel bereit. Ein Transkript ist eine sinnvolle Ergänzung, ersetzt synchronisierte Untertitel aber nicht. Das Redundanzprinzip betrifft bestimmte Vergleiche in der Forschung und setzt Anforderungen an die Barrierefreiheit nicht außer Kraft. Nutzen Sie kurze Beschriftungen in der Grafik, zuschaltbare Untertitel und eine passende Textalternative für visuelle Informationen.
Mit Mayers Prinzipien eine Lerneinheit gestalten oder prüfen
Beginnen Sie bei den Lernenden und der Durchführungsform, legen Sie dann die Struktur fest und prüfen Sie zuletzt jeden Bildschirm. In dieser Reihenfolge arbeite ich:
- Klären Sie, was die Lernenden schon wissen. Fragen Sie nach, testen Sie oder sehen Sie sich ihre Arbeit an, und schließen Sie nicht von der Stellenbezeichnung auf das Wissen. Vom Vorwissen hängt ab, wie viel die Prinzipien bringen.
- Legen Sie fest, wie die Lerneinheit abläuft. Halten Sie fest, ob sie am Stück durchläuft, wie bei einem Webinar oder Video, oder ob die Lernenden das Tempo steuern.
- Führen Sie unbekannte Bauteile und Begriffe vor der Lerneinheit ein, die darauf aufbaut, und nutzen Sie sinnvolle Abschnitte im Tempo der Lernenden, wo die Durchführung es zulässt. Wer die Begriffe bereits kennt, braucht womöglich keine eigene Pretraining-Seite.
- Planen Sie für jeden Bildschirm gemeinsam, was das Bild zeigt und was der Sprechertext dazu sagt. Beschränken Sie gedruckten Text auf Beschriftungen und Schlüsselbegriffe direkt neben dem, was sie benennen.
- Streichen Sie, was dem Ziel nicht dient, und heben Sie hervor, was ihm dient. Entfernen Sie dekorative Bilder, Musik und Abschweifungen und ergänzen Sie Hervorhebungen oder Überschriften für das, was die Lernenden bemerken müssen.
- Bauen Sie zwischen den Abschnitten eine generative Aktivität ein, etwa eine Vorhersage, eine Erklärung oder ein kurzes Szenario.
- Pilotieren Sie zuerst und prüfen Sie mit zeitlichem Abstand. Testen Sie, was die Lernenden einige Wochen später können, nicht nur am Ende der Lerneinheit.
Der Zentrifugenkurs, Bildschirm für Bildschirm
| Bildschirm | Vorher | Prinzip | Nachher |
|---|---|---|---|
| Die Zentrifuge kennenlernen | Keine Seite zu den Bauteilen; die Begriffe aus dem Handbuch tauchen erstmals im Ablauf auf | Pretraining (Vorab-Einführung) | Eine Einstiegsseite mit beschriftetem Diagramm von Rotor, Bechern, Deckelverriegelung, Bedienfeld und Alarm |
| Beladen und austarieren | Ein Absatz zum Austarieren und ein separates Foto des Rotors | Räumliche Nähe und Multimedia | Ein Diagramm mit Röhrchen in gegenüberliegenden Positionen, Beschriftungen an den Teilen und der Erklärung daneben |
| Lauf starten | Die Sprechstimme liest den vollständigen eingeblendeten Absatz über der Animation vor | Redundanz und Modalität | Vertonte Animation nur mit kurzen Beschriftungen; der vollständige Text ist auf eine Zusammenfassungsseite gewandert |
| Lauf starten | Der Deckel schließt sich in der Animation, bevor der Sprechertext ihn erwähnt | Zeitliche Nähe | Der Sprechertext nennt jeden Schritt, während die Animation ihn zeigt |
| Jeder Bildschirm | Stockfotos und Hintergrundmusik | Kohärenz | Entfernt |
| Stoppen und entnehmen | Eine lange vertonte Sequenz, die am Stück durchläuft | Segmentierung | Zwei Abschnitte, jeweils mit einer Weiter-Schaltfläche am Ende |
| Unwuchtalarm | Eine Folie mit einer Liste, was zu tun ist | Generative Aktivität und Signalisierung | Ein Szenario, in dem die Lernenden die Reihenfolge der Maßnahmen festlegen, mit hervorgehobener Alarmleuchte |
Prüfen Sie eine vertonte Lerneinheit oder ein Video anhand von Mayers 15 Prinzipien: mit der Frage, die Sie sich bei jedem Bildschirm stellen sollten, den Bedingungen, unter denen jedes Prinzip am meisten hilft, dem Zentrifugenkurs als geprüftem Beispiel und leeren Audit-Seiten zum Ausfüllen. Bearbeitbare Word-Datei, ohne Angabe Ihrer E-Mail-Adresse.
Was steht in Kursanfragen?
Um zu sehen, wie Menschen multimediale Kurse briefen, haben wir eine Stichprobe von Anfragen klassifiziert, die in den 90 Tagen bis zum 7. Oktober 2026 in Coursebox eingegeben wurden: eine pro Person, aus englischsprachigen Browsern, ohne hochgeladene Datei und bereinigt um Antworten vor der Gliederung und um Vorlagen-Duplikate. Ein Sprachmodell klassifizierte die verbleibenden 266 Prompts, davon 112 Kursanfragen, und wir haben seine Beispiele stichprobenartig von Hand geprüft. Es zählte großzügig, daher handelt es sich um modellcodierte Schätzungen, nicht um geprüfte Obergrenzen oder Schätzungen für alle Coursebox-Nutzer.
Bis zur Hälfte der Kursanfragen verlangte Inhalte in kurzen Modulen oder Häppchen, und damit die strukturelle Seite der Segmentierung.
Etwa 28 wünschten sich Visualisierungen, etwa 20 weniger Text und etwa 12 Videos. Die Aufteilung in Häppchen kam in den Anfragen deutlich häufiger vor als Vertonung. Wenn Sie ein Tool zur Kurserstellung briefen, legen Sie fest, welche Erklärungen über einer Grafik gesprochen werden sollen, wozu der Bildschirmtext dient und was wegbleiben soll. Sonst werden diese Entscheidungen für Sie getroffen.
Mayers Theorie und die Cognitive Load Theory im Vergleich
Mayers Theorie und John Swellers Cognitive Load Theory teilen die Vorstellung eines begrenzten Arbeitsgedächtnisses, und Mayer hat bei ihr Anleihen gemacht. Dennoch sind es getrennte Theorien mit eigenem Vokabular. Die Cognitive Load Theory beschreibt die Belastung, die Stoff und Gestaltung bei Lernenden erzeugen. Mayers Theorie beschreibt die Verarbeitung, die Lernende mit Wörtern und Bildern leisten, und im Handbuch von 2005 schrieb er, die Cognitive Load Theory konzentriere sich „nicht auf die Arten von Informationsprozessen, die beim multimedialen Lernen beteiligt sind“. Beide definieren Redundanz unterschiedlich: Mayers Fassung ist enger, während in der Cognitive Load Theory jede unnötige Wiederholung redundant sein kann. Auch Mayers eigene Begriffe haben sich verschoben: In seinem Aufsatz von 2003 meinte „essenzielle Verarbeitung“ etwas, das näher am Sinnverstehen lag. Bleiben Sie pro Dokument beim Vokabular einer Theorie.
| Merkmal | Mayers kognitive Theorie des multimedialen Lernens | Swellers Cognitive Load Theory |
|---|---|---|
| Leitfrage | Wie lernen Menschen aus Wörtern und Bildern zusammen? | Wie wirkt sich die Belastung durch Stoff und Gestaltung auf das Lernen aus? |
| Analyseeinheit | Die Verarbeitung durch die Lernenden: Auswählen, Organisieren und Integrieren | Die Belastung des Arbeitsgedächtnisses |
| Zentrale Begriffe | Extrinsische, essenzielle und generative Verarbeitung | Intrinsische, extrinsische und lernbezogene (germane) Belastung |
| Redundanz bedeutet | Gedruckter Text, der den Sprechertext einer vertonten Grafik wiederholt | Jede Information, die für die jeweiligen Lernenden unnötig ist |
| Am besten geeignet für | Gestaltung von Folien, Videos, Sprechertext und E-Learning-Bildschirmen | Entscheidung, wie viel Anleitung, ausgearbeitete Beispiele und Übung Lernende brauchen |
Grenzen der Theorie
Im Labor hält die Theorie gut stand. Offen sind Fragen zu langen Kursen, echten Arbeitsumgebungen und der Größe der Effekte.
- Die meisten Tests nutzten sehr kurze Lerneinheiten. In einer Kritik der Cognitive-Load-Forschung von 2010 wies Ton de Jong darauf hin, dass zwei Studien aus Mayers Gruppe Lerneinheiten von etwa 2,5 und 6 Minuten verwendeten und viele Teilnehmende dieser Forschung kein besonderes Interesse am Thema haben. In seinem Überblicksartikel von 2024 fordert Mayer selbst Studien in „Online-Kursen und beruflicher Weiterbildung“.
- Die Theorie bezieht sich auf akademische Erklärungen. Mayer beschreibt sie als Theorie über „akademische Inhalte“, und die meisten Tests nutzten Erklärungen dazu, wie Systeme funktionieren. Sie auf Abläufe, motorische Fertigkeiten oder Einstellungen zu übertragen, wie im Zentrifugenkurs, ist eine Extrapolation.
- Außerhalb des Ursprungslabors schrumpfen die Effekte. Reinweins Reanalyse ergab, dass die Forschungsgruppe einer der Faktoren war, die mit der Größe des Modalitätseffekts zusammenhingen.
- Kurzfristige Zuwächse können verblassen. Die meisten Tests finden direkt nach der Lerneinheit statt, und die einzige Studie aus der Arbeitswelt mit späterem Test, die ich gefunden habe, zeigt, wie der Vorsprung schmilzt.
- Die Evidenz aus der Arbeitswelt ist dünn. Ich konnte keinen belegten Fall eines privaten Unternehmens außerhalb des Gesundheitswesens finden, das sein E-Learning nach Mayers Prinzipien umgestaltet und das Ergebnis gemessen hat. Die veröffentlichte Evidenz aus der Praxis stammt überwiegend aus dem Gesundheitswesen und aus öffentlichen Programmen.
- Es gibt konkurrierende Modelle. Mayer nennt Wolfgang Schnotz' integriertes Modell des Text- und Bildverstehens als eines davon.

Fallstudie: OP-Pflegekräfte in Singapur
Perioperative Pflegekräfte im Day Surgery Centre des Khoo Teck Puat Hospital in Singapur müssen ein Protokoll für den Umgang mit Komplikationen bei Kataraktoperationen lernen. Die bisherigen Schulungsfolien waren textlastig, und ein wachsender Teil der Schulung lief inzwischen online.
- Was sie gemacht haben: Forschende erstellten E-Lecture-Folien nach den Prinzipien Redundanz, räumliche Nähe, Modalität, Segmentierung, Multimedia, Personalisierung und Verkörperung, mit einem animierten Agenten auf dem Bildschirm, und verglichen sie mit Stichpunktfolien mit wenigen Grafiken. Beide Vorlesungen dauerten etwa 30 Minuten.
- Evidenz und Ergebnis: In einem Preprint von 2025 wurden 44 Pflegekräfte zufällig auf zwei Gruppen mit jeweils 22 Personen verteilt. Direkt nach der Vorlesung erzielte die Gruppe mit den neu gestalteten Folien im Median 6,00 gegenüber 4,75 Punkten in einem Test mit sechs Fragen (p = 0,02). Vier Wochen später unterschieden sich die Gruppen nicht mehr signifikant (4,50 gegenüber 3,75, p = 0,21).
- Einschränkung: Es handelt sich um einen Preprint ohne Peer-Review. Die Studie ist klein und an nur einem Standort durchgeführt, der Test hatte nur sechs Fragen, alle Prinzipien wurden gleichzeitig geändert, und die berichteten Ausgangswerte sind widersprüchlich. Niemand hat die Pflegekräfte im OP beobachtet.
- Erkenntnis: Die Gruppe mit den neuen Folien schnitt unmittelbar besser ab, der spätere Vergleich lieferte jedoch kein eindeutiges Ergebnis. Ein nicht signifikanter Unterschied belegt weder gleich gutes Behalten noch gleich starkes Vergessen. Planen Sie für jedes Protokoll, das im Gedächtnis bleiben muss, verteiltes Üben und eine Auffrischung ein.
Mayers Prinzipien mit einem KI-Kursersteller umsetzen
Am 7. Oktober 2026 habe ich den Zentrifugenkurs in Coursebox gebrieft: Zielgruppe waren neue Laborfachkräfte, Inhalt die sechs Teile des Ablaufs, und die Gestaltung sollte auf Pretraining, Segmentierung, der Kombination von Wort und Bild, Kohärenz und Signalisierung beruhen. Da es unser eigenes Produkt ist, sollten Sie meine Einschätzung mit diesem Wissen lesen.
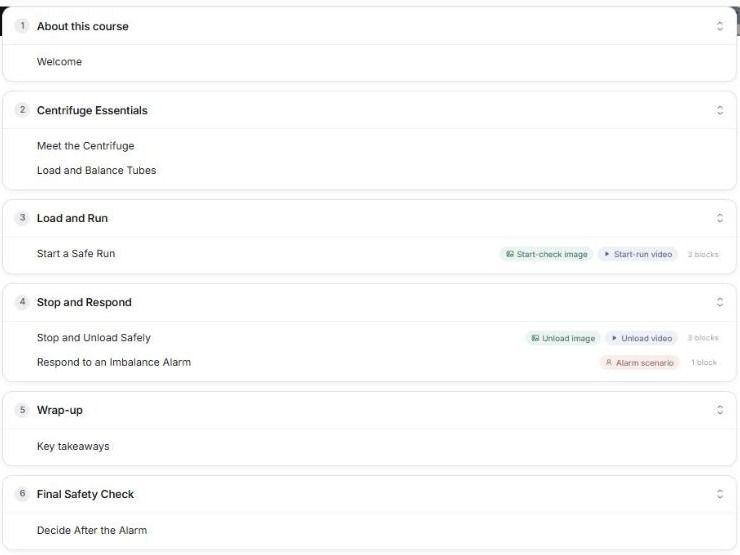
Den Großteil der Struktur hat Coursebox so umgesetzt, wie ich es vorgegeben hatte. Der Ablauf wurde auf kurze Seiten verteilt: „Load and Balance Tubes“, „Start a Safe Run“ und „Stop and Unload Safely“. Jede der beiden Schritt-Seiten hatte drei Blöcke in der Gliederung, darunter ein Bild und ein Video. „Start a Safe Run“ enthielt ein Start-Check-Bild und ein Start-Run-Video, „Stop and Unload Safely“ ein Unload-Bild und ein Unload-Video. Die Reaktion auf den Alarm wurde zum Szenario „Respond to an Imbalance Alarm“, und die Gliederung endet mit dem Abschnitt „Final Safety Check“, der „Decide After the Alarm“ enthält.
Eines ging verloren. Nach einer meiner Überarbeitungsanfragen fehlte in der Gliederung die Pretraining-Seite, die die Bauteile vor dem Ablauf benennt.
Ich habe sie als „Meet the Centrifuge“ wieder hinzufügen lassen, am Anfang des Abschnitts „Centrifuge Essentials“ und vor „Load and Balance Tubes“. Nach dem Neuladen stand „Meet the Centrifuge“ an erster Stelle in „Centrifuge Essentials“. Die finale Gliederung umfasste rund 20 Minuten in 6 Abschnitten und 8 Seiten, darunter einen Begrüßungsabschnitt „About this course“ und einen Abschnitt „Wrap-up“. Das bestätigt allerdings nur die Struktur. Für „Meet the Centrifuge“ zeigt die Gliederung noch keinen Bildblock, prüfen Sie also, ob ein beschriftetes Diagramm der Bauteile ergänzt wird, bevor die Lernenden damit arbeiten. Ob der Sprechertext den Bildschirmtext nicht wiederholt und ob die Fachkräfte die Zentrifuge sicher bedienen können, muss im fertigen Kurs und am Gerät geprüft werden.
Planen Sie für jeden Bildschirm einer vertonten Lerneinheit Bild und Sprechertext gemeinsam und halten Sie zusätzlich die eingeblendeten Beschriftungen, den Hinweis zur Aufmerksamkeitslenkung und die Handlung der Lernenden fest. Mit dem ausgefüllten Zentrifugenkurs als Beispiel und leeren Seiten zum Ausfüllen. Bearbeitbare Word-Datei, ohne Angabe Ihrer E-Mail-Adresse.
Mayers Prinzipien in die Praxis bringen
Wer Sprechertext zusätzlich einblendet, Folien dekoriert und Beschriftungen weit weg vom Bild platziert, verschenkt Lernwirkung. Mayers kognitive Theorie des multimedialen Lernens liefert den Grund dafür: Wort und Bild konkurrieren um ein knappes Arbeitsgedächtnis. Die Prinzipien zeigen, welche Korrekturen sich lohnen, und drei davon warnen vor Extras, die nicht zuverlässig helfen. Am meisten bringen sie bei Neulingen, komplexem Stoff und Lerneinheiten, die am Stück durchlaufen, und genau das trifft auf einen Großteil von Onboarding und Compliance-Schulungen zu. Bei erfahrenen Beschäftigten, die eine Auffrischung im eigenen Tempo absolvieren, fallen die Effekte kleiner aus; dort können Sie die Unterstützung zurückfahren.
Der beste Einstieg ist ein einzelner Bildschirm aus einer vertonten Lerneinheit, die Sie bereits einsetzen. Drei Fragen genügen: Wird der Sprechertext zusätzlich über der Grafik eingeblendet? Sitzt jede Beschriftung an dem Teil, das sie benennt? Was auf dem Bildschirm kann weg? Beheben Sie diese drei Punkte, ergänzen Sie vor dem Ablauf eine Seite, die die Bauteile benennt, und testen Sie die Lernenden einige Wochen später erneut. Auch die beste erste Lerneinheit ersetzt keine Übung.
Häufig gestellte Fragen
Die kognitive Theorie des multimedialen Lernens ist Richard Mayers Erklärung dafür, wie Menschen aus Wörtern und Bildern lernen. Sie beruht auf drei Annahmen: getrennte verbale und visuelle Kanäle, eine geringe Kapazität jedes Kanals und die Notwendigkeit aktiver Verarbeitung. Daraus leiten sich die 15 evidenzbasierten Gestaltungsprinzipien in der Auflage von 2021 seines Buchs Multimedia Learning ab.
Die 12 Prinzipien stammen aus der zweiten Auflage von Multimedia Learning (2009): Multimedia, Kohärenz, Signalisierung, Redundanz, räumliche Nähe, zeitliche Nähe, Segmentierung, Pretraining, Modalität, Personalisierung, Stimme und Bild. Die dritte Auflage von 2021 ergänzt Verkörperung, Immersion und generative Aktivität, womit es 15 sind.
Richard Mayer hat sie mit Kolleginnen und Kollegen aus Experimenten entwickelt, die 1989 begannen; der Name taucht in seinen Aufsätzen von 1996 bis 2000 auf. Er baute auf Allan Paivios Theorie der dualen Kodierung, Alan Baddeleys Arbeiten zum Arbeitsgedächtnis, John Swellers Cognitive Load Theory und Merlin Wittrocks generativem Lernen auf.
Das Modalitätsprinzip besagt, dass eine Grafik besser gesprochen als mit Bildschirmtext erklärt wird. Das Redundanzprinzip besagt, dass es bei einer bereits vertonten Grafik nicht hilft, denselben Sprechertext zusätzlich einzublenden, zumindest bei hohem Tempo. Kurze Beschriftungen neben der Grafik sind nach beiden Prinzipien in Ordnung.
Richard Mayer ist bekannt für die kognitive Theorie des multimedialen Lernens und ihre Gestaltungsprinzipien, für Multimedia Learning und The Cambridge Handbook of Multimedia Learning sowie für e-Learning and the Science of Instruction, gemeinsam mit Ruth Colvin Clark. Außerdem ist er Mitautor der Überarbeitung von Blooms Taxonomie aus dem Jahr 2001.
Carolina Martin
Carolina ist eine hocherfahrene Lerndesignerin mit Erfahrung in Tech-Start-ups. Sie ist in Sydney ansässig und hat zuvor gemeinsam mit Coursebox-Gründer Travis in einem früheren Job Kurse entworfen. Sie ist leidenschaftlich daran interessiert, ansprechende Lernerfahrungen zu bieten, und bringt dieselbe Perspektive auch in die Kundenerfahrung ein. Sie verwaltet unsere Kundensupport-Dokumentation und die Produkttestprozesse.

