

梅耶多媒体学习认知理论:15 条设计原则详解
一文读懂梅耶多媒体学习认知理论:三条基本假设、全部 15 条原则及其效应量、各原则最适用的情形,另附两份免费模板。

多媒体学习认知理论是理查德·梅耶(Richard Mayer)对“人如何从文字和图像中学习”的解释,建立在三条假设之上:人有相互独立的言语通道和视觉通道;每个通道一次只能容纳少量信息;真正的学习需要学习者主动加工。
- 梅耶提出的设计原则在不断扩充:2001 年为 7 条,2009 年增至 12 条,到 2021 年版《多媒体学习》已有 15 条。
- 15 条原则中有 3 条的结论是:一些流行的附加元素并不能稳定地提升学习效果,例如在屏幕上显示讲者的脸,或者使用虚拟现实。
- 冗余原则提醒:图像已有旁白讲解时,不要再在屏幕上显示旁白原文,这一点在节奏较快的课程中尤为重要。
- 梅耶的原则对新手、复杂内容以及从头播到尾的课程帮助最大;对经验丰富的学员,反而可能形成干扰。
- 在用户输入 Coursebox 的 112 条课程需求样本中,最多有 57 条要求把内容拆成短小的片段,提到旁白的不超过 7 条。
针对一门课程的五个规划问题。这是一份未经验证的检查清单,请逐题查看答案;总分无法说明课程是否对准目标、能否投入使用、是否有效。

几分钟内即可将故事板转化为互动课程
一位实验室新技术员入职第一周,要靠一套带旁白的幻灯片学会使用实验室的台式离心机。屏幕上印着一整段文字,旁白就照着念;半页幻灯片放着一张科学家微笑的图库照片;讲解声下面还垫着背景音乐;而真正标明离心管该放哪里的那张示意图,偏偏和讲解它的文字隔了一页。课看完了,这位技术员装转子时照样没有配平。
笔者是 Coursebox 的教学设计师。我们开发的教学设计软件能把设计师的需求说明直接生成课程大纲,包含页面、图片、视频和情景模拟,所以文字和图像如何在同一屏上分工,本来就是我的日常工作。上面那段视频错在哪里,理查德·梅耶的多媒体学习认知理论给出了解释,他提出的设计原则则告诉我们该怎么改。本文依次介绍这一理论、15 条原则及各自的证据、它们在什么情况下最有效,并用这些原则把同一门离心机课程重新设计一遍。
什么是多媒体学习认知理论?
多媒体学习认知理论是理查德·梅耶对人如何从文字和图像中学习的解释,建立在三条假设之上:人有相互独立的言语通道和视觉通道;每个通道一次只能容纳少量信息;学习需要主动加工。
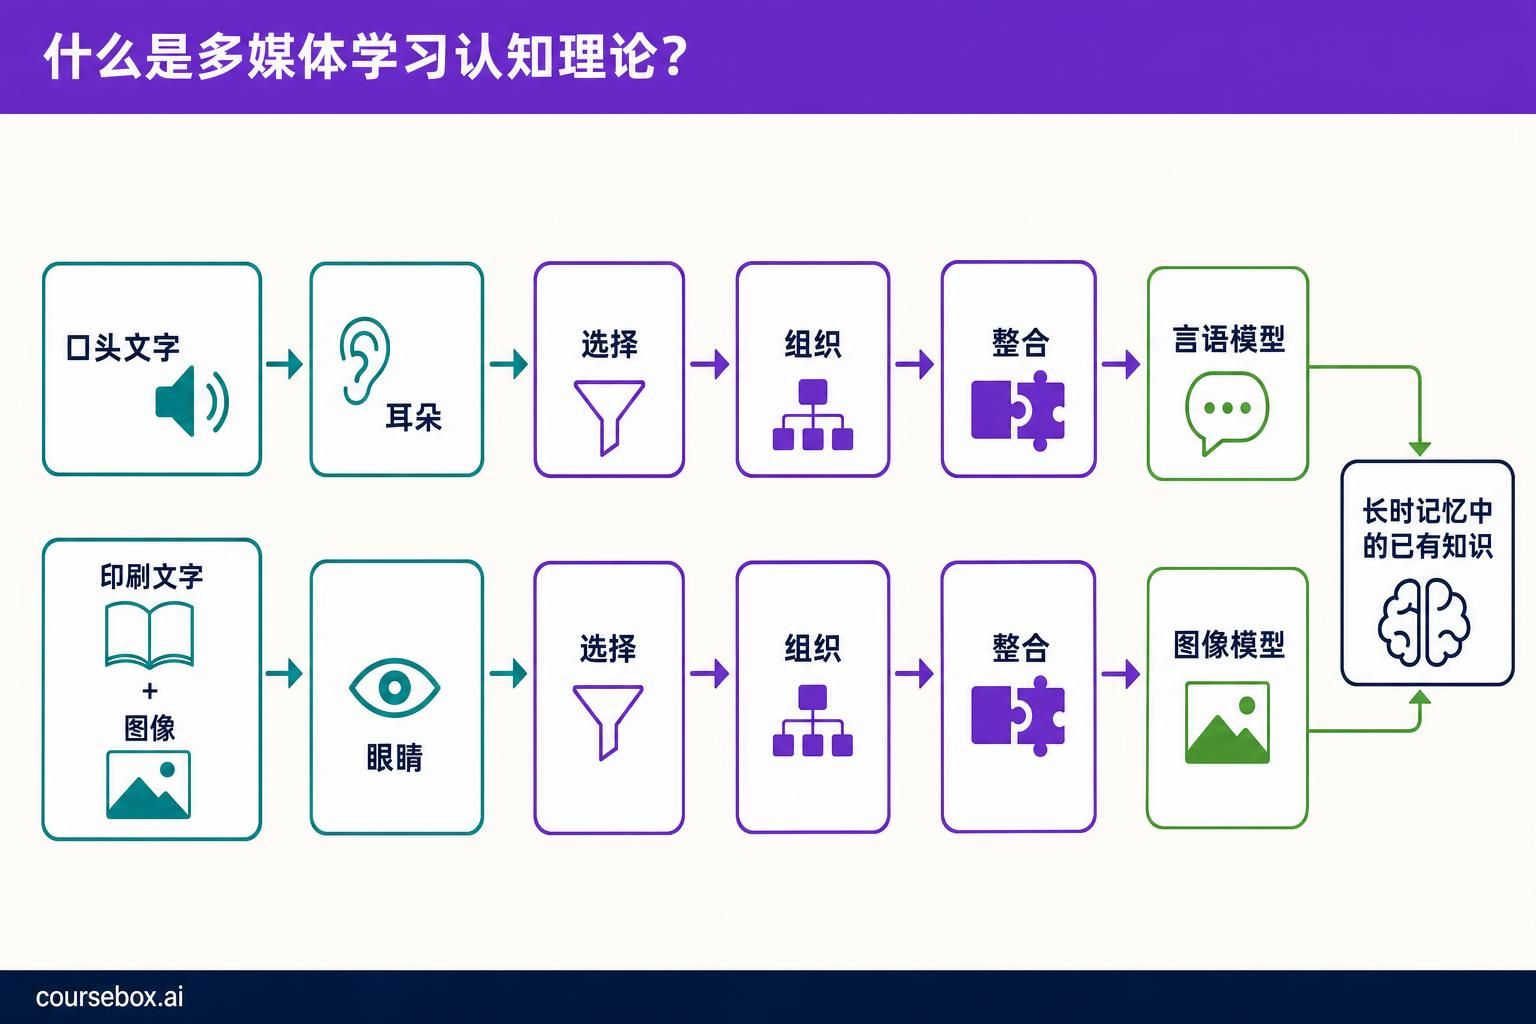
这一理论适用于梅耶所说的“多媒体教学信息”:“由文字(如印刷文本或口头讲述)和图形(如插图、照片、动画、视频或沉浸式虚拟现实)组成、旨在帮助学习者获得新知识或新技能的教学材料”。这个定义出自梅耶 2024 年对该理论过去、现在与未来的综述,是理论创立者本人对它的最新表述,可免费阅读。配旁白的幻灯片、讲解视频、带示意图的在线学习页面,以及配插图的纸质手册,都属于这一范畴。梅耶的目标是解释人如何从这些材料中学习“学术内容”,衡量标准是迁移测试,即要求学习者把所学用到新的情境中。
三条假设,用梅耶的原话来说(2024,第 17 页):
- 双通道:“人类拥有相互独立但彼此作用的两个通道,分别处理听觉/言语信息和图像/视觉信息”。
- 容量有限:“人类在每个通道中同一时间只能处理少量信息”。
- 主动加工:“当学习者在学习过程中进行恰当的认知加工时,有意义的学习才会发生”,也就是选择要关注的内容、加以组织,并与已有知识建立联系。
梅耶的模型用三种记忆系统和五个加工过程来体现这些假设。文字和图像经由耳朵和眼睛进入感觉记忆。学习者从中选择部分文字和部分图像送入工作记忆,把文字组织成言语模型、把图像组织成图像模型,再将二者彼此整合,并与长时记忆中的已有知识整合起来。有一个细节能解释很多糟糕的幻灯片设计:印刷文字是通过眼睛进入的,所以屏幕上的文字虽然属于言语信息,却要和图片争抢同一个视觉通道。
由于工作记忆容量有限,梅耶描述了学习过程中对工作记忆的三种需求(2024,第 18 页):
- 外在加工不服务于任何教学目标,源于糟糕的设计,例如无关的图片或文字。
- 必要加工是在头脑中表征材料本身所需的工作,材料对该学习者越复杂,这部分负担就越重。
- 生成性加工是为理解材料所付出的努力,取决于学习者的学习动机有多强。
每种需求对应一个设计目标:减少外在加工、管理必要加工、促进生成性加工。每条原则都服务于其中之一。它们是需要同时应用的设计检查项,而不是依次执行的几个阶段。
15 条原则一览
下表改编自梅耶本人在其著作《多媒体学习》第三版(2021)中对 15 条原则的总结,该总结收录于他 2024 年综述的表 6,采用 CC BY 4.0 许可发布。效应量取梅耶实验室各项实验的中位数,以 Cohen's d 表示。按照科恩的经验标准,0.2 为小效应,0.5 为中等效应,0.8 为大效应。“检验次数”一列是每个中位数背后的实验对比数量。原则名称采用国内教育技术文献中的通行译法。
| 目标 | 原则 | 通俗解释 | 效应量(2021) | 检验次数 |
|---|---|---|---|---|
| 减少外在加工 | 一致性原则 | 删除与目标无关的内容 | 0.86 | 19 |
| 减少外在加工 | 信号原则 | 添加提示,突出核心内容的组织结构 | 0.69 | 16 |
| 减少外在加工 | 冗余原则 | 课程节奏较快时,如果图像已有旁白,不要再添加重复旁白的屏幕文字 | 0.10 | 12 |
| 减少外在加工 | 空间邻近原则 | 把文字放在它所描述的图像部位旁边 | 0.82 | 9 |
| 减少外在加工 | 时间邻近原则 | 文字与对应的图像同时呈现 | 1.31 | 8 |
| 管理必要加工 | 分段原则 | 把课程分成由学习者控制进度的小段 | 0.67 | 7 |
| 管理必要加工 | 预训练原则 | 先讲解主要概念的名称和特征 | 0.78 | 10 |
| 管理必要加工 | 通道原则 | 用旁白而不是屏幕文字来讲解图像 | 1.00 | 19 |
| 促进生成性加工 | 多媒体原则 | 文字配合图像,而不是只有文字 | 1.35 | 13 |
| 促进生成性加工 | 个性化原则 | 用对话式的语言风格来写 | 1.00 | 15 |
| 促进生成性加工 | 声音原则 | 用亲切的真人声音而不是机器声音来讲解 | 0.74 | 7 |
| 促进生成性加工 | 图像原则 | 在画面中加入讲者形象,并不能稳定地提升学习效果 | 0.20 | 7 |
| 促进生成性加工 | 具身原则 | 讲者出镜时,要配合手势、身体动作和眼神交流 | 0.58 | 17 |
| 促进生成性加工 | 沉浸原则 | 3D 虚拟现实并不能稳定地胜过桌面端的同一课程 | -0.10 | 9 |
| 促进生成性加工 | 生成活动原则 | 引导学习者在学习过程中进行总结、解释或自测 | 0.71 | 44 |

案例:美国休斯敦药师的合规培训
在美国,从事药品生产的人员依联邦法规必须接受现行药品生产质量管理规范(cGMP)培训,而标准版培训内容大多是文字密集的法规条文。休斯敦大学药学院的研究人员重新设计了一部 cGMP 培训视频,并在休斯敦地区的药师中进行了测试。
- 做法:研究人员结合梅耶的原则、认知负荷理论以及其他演示设计改进来修改视频。屏幕文字压缩为要点,比标准版少了约 90%;讲解改由旁白承担;关键法规要点用对比色和下划线标出;幻灯片改用满版照片。
- 证据与结果:在一项 2026 年发表的随机交叉研究中,49 名药师按随机顺序各观看一部标准版和一部改版视频,每看完一部立即测试。改版视频的知识测评得分为 78%,标准版为 72%(p = 0.04);自评心理努力从 3.5 降至 2.4。
- 局限:两部视频涵盖的法规条款不同,因此无法完全区分差异来自主题还是设计。改版视频还在片头和片尾加了背景音乐,而这正是一致性原则不建议的做法。所有测量都是即时进行的,也没有人检查药师在实际工作中是否合规。
- 启示:这次改版把屏幕文字压缩为要点、把讲解交给旁白、并对关键点加以提示,再配合其他调整,带来了小幅的即时提升,主观感受到的努力程度也大幅下降。对于幻灯片密集的合规培训视频,这是一种低成本的第一步改进,之后还要检查学员过一段时间后还记得多少。
这一理论由谁提出?共有多少条原则?
理查德·梅耶与同事从 1989 年开始的一系列实验中发展出这一理论。他最早研究的是后来被称为多媒体原则的发现,即人从文字加图像中学得比只看文字更好,然后围绕实验结果逐步构建起理论。梅耶明确交代了自己借鉴的思想来源:双通道来自艾伦·佩维奥(Allan Paivio)的双重编码理论和艾伦·巴德利(Alan Baddeley)的工作记忆模型;容量有限借鉴了乔治·米勒、巴德利和约翰·斯威勒(John Sweller),梅耶把斯威勒的认知负荷理论描述为一个与自己相互竞争、但他也从中借鉴的理论;主动加工则体现了梅林·维特罗克(Merlin Wittrock)关于生成性学习的研究。梅耶在 2024 年的综述中逐一说明了这些渊源。
这个名称经历了一段时间才定下来。根据梅耶本人的回顾,它先后被称为“有意义学习模型”“双重编码模型”和“选择、组织、整合模型”,到 1996 年至 2000 年的论文中才使用“多媒体学习认知理论”这一名称。标准示意图最早出现在 2001 年第一版《多媒体学习》中,而《剑桥多媒体学习手册》的每一版(2005、2014 和 2022 年)都为这一理论单列一章。梅耶也是 2001 年修订版布鲁姆教育目标分类法的作者之一。
原则有多少条,取决于您读的是哪一版。以下是梅耶本人的统计,出自 2024 年综述的表 3 和表 4:
| 《多媒体学习》版本 | 原则数 | 实验对比数 | 变化 |
|---|---|---|---|
| 第一版,2001 年 | 7 | 45 | 多媒体、空间邻近、时间邻近、一致性、通道、冗余和个体差异 |
| 第二版,2009 年 | 12 | 93 | 新增信号、分段、预训练、个性化、声音和图像;个体差异不再单列为一条原则 |
| 第三版,2021 年 | 15 | 201 | 新增具身、沉浸和生成活动 |
最常被引用的“梅耶 12 条原则”出自 2009 年第二版:多媒体、一致性、信号、冗余、空间邻近、时间邻近、分段、预训练、通道、个性化、声音和图像。这份清单确实存在,但已不是最新版本。具身原则属于 2021 年版,不在 2009 年的 12 条之列。此外还流传着其他数字:梅耶 2008 年发表在《美国心理学家》上的文章总结了 10 条原则;他 2017 年的一篇期刊综述列出的是另一组 12 条,包含具身原则而没有图像原则;2022 年版手册则涵盖了来自众多研究团队的 31 条原则。看到一份原则清单时,先确认它出自哪个来源。
梅耶的著作该读哪些
- 先读梅耶 2024 年的开放获取综述,了解这一理论、15 条原则及其证据范围。
- 如果关注职场在线学习,推荐露丝·克拉克(Ruth Colvin Clark)与理查德·梅耶合著的《e-Learning and the Science of Instruction》第五版(2024),书中把这些原则应用到了培训设计中。
- 想看每条原则的完整证据和边界条件,请读《多媒体学习》第三版(2021),由剑桥大学出版社出版。
实例演示:离心机安全课程
为了展示这些原则的实际用法,本文后半部分将始终围绕一门假设的课程展开,也就是开头提到的那门课。某实验室正在为新技术员做入职培训,他们需要学会安全使用实验室的台式离心机。其中一些人有理科学位,一些人用第二语言工作,但没有人用过这一型号,也没有人接受过它的报警处理培训。操作流程分为六部分:装管、配平、启动运行、停止运行、取出样品,以及处理不平衡报警。学员手头有实验室的书面操作规程和厂家说明书,课程要让他们做好准备,在主管监督下完成第一次上机操作。预期成果是:每位技术员都能装好配平的转子、安全地启动和停止运行,并正确处理报警,由主管在实验台旁现场观察评定。
现有的培训是根据说明书制作的一套配旁白幻灯片:屏幕上是整段文字,旁白照着念;大多数幻灯片配有装饰性照片;转子示意图和用到它的操作步骤不在同一页。离心机课程能让大多数原则都显现出来,因为它有需要认识的部件名称、顺序固定的步骤、需要标注的示意图,以及对报警的限时响应。这对理论来说也是一次延伸:梅耶主要用“系统如何运作”类的讲解来检验它,例如闪电、刹车和打气筒。操作流程和动作技能属于外推,最终要在实验台前接受检验。
减少外在加工:五条原则
这五条原则减少与学习无关的认知负担,让学习者把更多认知容量留给学习材料本身。
一致性原则
排除而不是加入无关材料时,人们学得更好。无关材料是指有趣但不相关的文字、图片、声音和音乐。一致性并不是指“把内容讲清楚”,那更接近信号原则。
- 要点:删掉一切不服务于教学目标的内容。
- 证据与局限:19 次检验的效应量中位数为 0.86。梅耶 2009 年的总结指出,一致性原则对工作记忆容量较低或对该主题了解较少的学习者帮助可能最大。
- 在离心机课程中:删掉厂家的发展历史、背景音乐和图库照片,只保留技术员装管、运行、停止和处理报警所需的内容。
信号原则
添加突出核心材料组织结构的提示时,人们学得更好。
- 要点:用标题、大纲、箭头或高亮,告诉学习者该看哪里、各部分如何衔接。
- 证据与局限:16 次检验的中位数为 0.69,高于 2008 年 6 次检验时的 0.52。
- 在离心机课程中:开头用一屏概览六个部分;同一部分的每一屏都使用相同的标题;旁白提到盖锁和对称的离心管位置时,同步高亮显示。
冗余原则
在图像和旁白之外再添加印刷文字,人们并不会学得更好,至少在课程节奏较快时如此。这条原则常被误读为禁止文字配图,其实并非如此。
- 要点:如果图像已经有旁白讲解,就不要再把同样的旁白打在屏幕上。
- 证据与局限:12 次检验的中位数仅为 0.10,而且 2021 年的表述把它限定在节奏较快的课程中。梅耶和莫雷诺在 2003 年的论文中报告,在不播放动画时结果恰好相反:旁白加上与之匹配的屏幕文字反而有帮助。Adesope 和 Nesbit 2012 年对 57 项研究的元分析发现,口头和书面文字同时呈现,对已有知识较少的学习者、由系统控制节奏的材料以及没有图片的材料都有帮助。
- 在离心机课程中:在演示运行过程的旁白动画中,屏幕上只保留动画和“转子”“盖锁”这类简短标签。完整文字放进文字稿或总结页,不要叠在动画上。
这条原则并没有说“图像和文字只能二选一”,也没有说“信息绝不能重复”。文字放在图片附近属于空间邻近原则,文字配合图片属于多媒体原则。在梅耶和莫雷诺 2003 年的论文中,冗余效应的定义“比斯威勒的含义更窄”,指的是去掉“对核心材料不必要的重复”,即在有旁白的动画上再以文字形式重复显示旁白内容。放在所指部位旁边的简短屏幕文字依然有帮助。
空间邻近原则
在页面或屏幕上,将相互对应的文字和图像放在彼此邻近的位置,比将它们分开放得很远更有助于学习。
- 要点:把每个标签放在它所指的部件上,把每段解释放在它描述的步骤旁边。
- 证据与局限:在梅耶实验室的 9 次检验中,中位数为 0.82。Schroeder 和 Cenkci 另做了一项独立的元分析,涵盖 58 组对比、共 2,426 名参与者,发现整合式设计的效应为 g = 0.63,虽然略小,但依然明显。
- 在离心机课程中:直接在示意图上标注转子、吊篮、盖锁和报警灯,而不是放在图下方的图例里。测验题的反馈显示在题目旁边,而不是下一屏。
时间邻近原则
相互对应的文字和图像同时呈现而不是先后呈现时,人们学得更好。
- 要点:画面展示哪一步,旁白就同时讲哪一步,不提前也不滞后。
- 证据与局限:在减少外在加工的五条原则里中位数最高,8 次检验为 1.31。梅耶 2009 年的总结指出,当课程交替呈现短小片段,或由学习者自行控制节奏时,这条原则的作用可能较小。
- 在离心机课程中:动画显示盖子合上的同时,旁白说“合上盖子,直到听到锁扣咔嗒一声”,而不是在片段结束时再总结。
管理必要加工:三条原则
有些内容对新手来说,无论设计得多好都很复杂。这三条原则把负担分散开,避免工作记忆不堪重负。
分段原则
多媒体课程以学习者自定节奏的小段呈现,而不是连续播放时,人们学得更好。
- 要点:把课程拆成有意义的小段,并由学习者决定何时进入下一段。
- 证据与局限:7 次检验的中位数为 0.67。起作用的关键是学习者能控制节奏。梅耶没有规定每段多长,所以“视频不要超过十分钟”是另一回事。他 2009 年的总结指出,当内容复杂、呈现节奏快、学习者缺乏经验时,分段最可能有帮助。
- 在离心机课程中:每屏一个短小片段,结尾放一个“继续”按钮。大多数微课视频也是同样的思路。

案例:美国 18 个州和属地的营养教育工作者
美国的扩展食品与营养教育计划(EFNEP)聘用辅助专业人员,为低收入家庭讲授营养知识。这些教育工作者分布在许多州,学历参差不齐,而且没有统一的培训,各州做法各不相同。
- 做法:科罗拉多州立大学的一名研究人员制作了一门关于孕期营养的在线课程,由四十个短视频片段组成,综合运用了多媒体、通道、一致性、分段和个性化原则,同时结合了一个更宏观的教学设计模型和角色扮演视频。讲解者采用对话式风格,设计中也去掉了装饰性的背景音乐。
- 证据与结果:在一项 2016 年的博士研究中,来自 18 个州和属地的 139 名教育工作者按州被分配到课程组或候补组,最终分析了 131 人(分别为 67 人和 64 人)。课程结束后,培训组有 92% 在知识测试中达到掌握水平,候补组为 65%;在要求找出视频中不当教学做法的情景测试中,两组分别为 95% 和 75%。
- 局限:对照组完全没有接受培训,所以这项研究只能说明课程有效,不能说明提升是梅耶的原则带来的。研究没有观察实际教学表现,自我效能为自评,测试的内部一致性也偏低。
- 启示:对于分散各地的兼职人员,一门由短视频片段组成的在线课程让大多数人达到了掌握水平,而未受培训的同行大多没有。检验判断能力要用情景题,不能只考记忆。
预训练原则
当人们了解主要概念的名称和特征时,从多媒体课程中学得更好。预训练是一种设计手段,并不是说学习者必须事先掌握基础知识。
- 要点:在讲解各部件如何协同工作之前,先介绍这些部件和术语。
- 证据与局限:10 次检验的中位数为 0.78。
- 在离心机课程中:第一页是“认识离心机”,用一张带标注的示意图标出转子、吊篮或离心管架、盖锁、控制面板和不平衡报警,这样后面的操作流程提到它们时就不必停下来解释。
通道原则
图像配旁白时,人们比图像配屏幕文字时学得更好。通道原则和冗余原则是两条不同的规则:通道原则比较的是图像旁边用旁白还是用印刷文字;冗余原则讨论的是在已有旁白的情况下,要不要再叠加印刷文字。
- 要点:图像需要讲解时,用旁白说明,而不是在屏幕上显示讲解文字。
- 证据与局限:19 次检验的中位数为 1.00。梅耶在 2008 年写道,它“在我们研究过的所有原则中得到的支持最多”。在他的实验室之外,这一效应较小;de Jong 介绍过 Harskamp 等人的一项课堂研究,对于自己掌控学习时间的学习者,这一效应完全消失。梅耶 2009 年的总结还指出,对于含有技术术语和符号的课程,以及母语不是授课语言的学习者,印刷文字可能更合适。
- 在离心机课程中:运行过程的动画用旁白讲解;转速设定这类技术术语则以文字形式保留在控制面板旁边,方便使用第二语言工作的员工阅读。
通道原则适用于所有学习者,与“听觉型学习者”或“视觉型学习者”毫无关系。在 2008 年发表于《美国心理学家》的文章中,梅耶驳斥了“印刷文字能让‘喜欢阅读的人’去读、其他人去听”这一说法。他的实验室还专门检验过言语型与视觉型学习者的说法:Pashler 等人 2008 年的综述提到,Massa 和梅耶在近 20 项个体差异指标上,都“没有找到支持”按偏好匹配教学的证据。关于学习风格的更广泛证据也指向同一结论。
促进生成性加工:七条原则
这七条原则鼓励学习者投入精力去理解学习材料。
多媒体原则
文字配合图像时,人们比只看文字学得更好。
- 要点:为文字配上相关的图片。装饰性图片则违反了一致性原则。
- 证据与局限:15 条原则中中位数最高,13 次检验为 1.35。梅耶 2009 年的总结指出,它对已有知识较少的学习者作用可能更强,因为这些学习者需要帮助才能把文字和图像联系起来。
- 在离心机课程中:一张转子示意图,四支离心管两两对称放置,旁边就是解释配平的文字。
个性化原则
多媒体课程使用对话式而不是正式书面语时,人们学得更好。
- 要点:用“你”直接称呼学习者,写得像一位同事在当面讲解。
- 证据与局限:15 次检验的中位数为 1.00。梅耶的总结指出,它可能对初学者最有效,前提是不过度使用,而且未必适用于时长较长的课程。一项 2024 年针对药师、医生和高级执业医疗人员的随机试验在一个 30 分钟的模块中加入了个性化和具身设计,学习者虽然注意到了这些设计,知识得分却没有差别(Cohen's d 0.02)。
- 在离心机课程中:写“把第二支离心管放在第一支的正对面”,而不是“离心管应置于相对位置”。
声音原则
旁白由亲切的真人声音而不是机器声音讲述时,人们学得更好。
- 要点:用亲切的真人声音配旁白,而不是机器声音。
- 证据与局限:7 次检验的中位数为 0.74,在 2009 年还被列为初步研究。我查阅的研究都没有测试过如今的 AI 语音,因此这条原则无法判断某个合成语音是否够用。
- 在离心机课程中:上线前,先把旁白放给一两位技术员听,替换掉他们觉得难以听懂的声音。
图像原则
在屏幕上加入讲者的形象,人们并不一定能从多媒体课程中学得更好。
- 要点:讲者头像出镜并不能稳定地帮助学习,但也不是禁止出镜。
- 证据与局限:7 次检验的中位数为 0.20。梅耶在 2014 年版手册的章节中报告了 14 次检验,其中一半的效应为负或可以忽略。
- 在离心机课程中:演示操作流程时,画面对准离心机,而不是培训师的脸。
具身原则
屏幕上的讲者表现出高具身性(即手势、身体动作和眼神交流)而不是低具身性时,人们学得更深入。这是 2021 年版新增的原则。
- 要点:讲者出镜时,应指向并注视学习者需要看的地方。
- 证据与局限:17 次检验的中位数为 0.58。它讨论的是讲者如何出镜,而不是该不该出镜;2024 年那项针对医疗专业人员的试验发现,与个性化设计一同加入时,知识得分没有显著差异。
- 在离心机课程中:如果由实验室主管出镜演示报警处理,说到报警灯和停止按钮时要用手指向它们。
沉浸原则
与对应的 2D 桌面呈现相比,人们在 3D 沉浸式虚拟现实中并不一定学得更好。这是 2021 年版新增的原则。
- 要点:虚拟现实本身并不会比在屏幕上学习同一课程效果更好。
- 证据与局限:9 次检验的中位数为 -0.10,略微有利于桌面版本。
- 在离心机课程中:先看桌面端动画,再在他人监督下实际操作离心机,不需要头显。
生成活动原则
在学习过程中得到引导去开展生成性学习活动时,人们学得更好。这是 2021 年版新增的原则,背后的检验次数也最多。
- 要点:让学习者对材料做点什么,例如总结、自我解释或自测。
- 证据与局限:44 次检验的中位数为 0.71。Fiorella 和梅耶(2016)列出了八种活动:总结、绘制概念图、画图、想象、自测、自我解释、教给他人和动作演示。
- 在离心机课程中:配平这一段结束后,让学员选择第四支离心管放在哪里,并说出理由。报警部分以一个简短的情景模拟收尾,由学员决定该做什么、按什么顺序做。各种互动式在线学习模块的思路都适合放在这里。
实际工作中,我会盯着一屏同时问四个问题:哪些内容可以删(一致性)?视线应该落在哪里(信号)?文字是否紧挨着图片(空间邻近)?屏幕上是否还显示了与旁白重复的文字(冗余)?一次检查就能发现逐条原则审查时漏掉的问题。
这些原则背后的证据有多强?
这些原则建立在 200 多项实验之上,但其中很多是在梅耶实验室进行的短时课程,而且随着证据增加,有几项效应在缩小。在把这些数字拿给利益相关方看之前,请记住三点。
第一,15 条原则中有 3 条的结论是某种流行的附加元素并不能稳定地带来帮助:在有旁白的图像上叠加文字(0.10,且仅限节奏较快的课程)、讲者形象(0.20)以及虚拟现实(-0.10)。
第二,随着证据增加,一些效应在缩小。
我读过的资料没有说明冗余效应为何下降,所以我不做猜测。通道效应在梅耶实验室之外也呈现同样的规律。Reinwein 2012 年的再分析把 Ginns 早先一项元分析的证据基础扩大了一倍,而 Ginns 当时在 43 个效应中得出 d = 0.72。
第三,独立综述依然支持该理论的核心。在 Noetel 等人 2022 年的综述之综述中,据作者摘要,该研究共涵盖 29 篇综述、1,189 项研究和 78,177 名参与者,其中时间邻近、空间邻近和信号原则的收益最大。同一摘要还指出,对于复杂材料以及讲座这类由系统控制节奏的场景,良好设计的作用比自定节奏的场景更大。
用这些证据来确定值得尝试的设计调整,尤其是理清标签、图片和旁白之间的关系。效应量概括的是各不相同的实验对比,既不能当成一份按大小排序、随意挑选的修改清单,也不能用来预测您的课程效果。请核对相关的边界条件,并让学员测试改版后的课程。
梅耶的原则在什么情况下最有效?
梅耶在 2024 年的综述中写道,每条原则都有边界条件:“原则适用于谁、适用于哪类课程、在什么情况下适用”。有三种情况反复出现。
- 学习者刚接触这个主题。第一版中的个体差异原则指出,设计效应对知识水平较低的学习者更强,因为他们无法用已有知识填补空白。
- 内容对该学习者来说很复杂。当需要同时记住很多东西时,分段和通道原则的帮助最大。
- 课程按固定节奏播放。从头播到尾的视频或网络直播研讨会,不给人重读或回放的时间。当学习者自己控制节奏时,研究中的设计效应会更小。
反过来也成立。在 2003 年的一篇论文中,Kalyuga 等人提出了专长逆转效应:“对缺乏经验的学习者非常有效的教学技术,用在经验较丰富的学习者身上时,可能失去效果,甚至产生负面影响”。在他们的一个例子中,缺乏经验的电工学员需要把文字整合到电路图中,而有经验的学员只看图反而表现更好。对有经验的学习者来说,旁白也可能变得多余。
下面是我对离心机课程的解读。这张表是我对各方资料的综合,并非梅耶本人的建议。
| 情境 | 优先应用的原则 | 可以逐步撤掉的辅助 |
|---|---|---|
| 新技术员,从头播到尾的旁白视频 | 预训练、分段、通道、空间邻近和时间邻近、信号 | 几乎不需要减少;这正是设计作用最大的情形 |
| 有经验的技术员,自定节奏的复训课程 | 一致性和生成活动 | 他们已不再需要的完整旁白和逐步标签 |
| 术语密集的课程,或使用第二语言工作的员工 | 空间邻近,在图片旁印出关键术语 | 只靠旁白讲解新术语 |
| 失聪或听力障碍的学员 | 字幕和文字稿,再加上空间邻近 | 冗余原则,它不能凌驾于无障碍需求之上 |
预录的旁白视频应始终提供准确的同步字幕。文字稿是有用的补充,但不能替代同步字幕。冗余原则针对的是特定的教学对比,不能凌驾于无障碍需求之上。请在图像上使用简短标签,提供学员可自行开启的字幕,并为视觉信息配上合适的替代文本。
如何用梅耶的原则设计或审查一门课程
先了解学员和课程的呈现方式,再确定结构,最后逐屏检查。下面是我的工作顺序:
- 了解学员已经掌握了什么。通过询问、测试或查看他们的工作成果来判断,不要凭职位头衔推测他们的知识水平。已有知识决定了这些原则能发挥多大作用。
- 确定课程的呈现方式。记下它是像网络研讨会或视频那样从头播到尾,还是由学员自己控制节奏。
- 在讲解需要用到陌生部件或术语的课程内容之前,先介绍这些部件和术语;在呈现方式允许的情况下,按内容划分有意义的小段,让学员自行控制学习进度。已经熟悉这些术语的学员,可能不需要单独的预训练页面。
- 规划每一屏时,把图片和旁白放在一起考虑:图片展示什么,旁白讲什么。屏幕上的文字只保留标签和关键术语,并放在它们所指内容的旁边。
- 删掉不服务于目标的内容,突出服务于目标的内容。去掉装饰图片、音乐和离题内容,并为学员必须注意的地方添加高亮或标题。
- 在分段之间加入生成活动。例如一次预测、一段解释或一个简短的情景模拟。
- 先试点,过一段时间再检验。几周后再测试学员能做什么,而不只是在课程结束时测试。
离心机课程逐屏改造
| 屏幕 | 改造前 | 原则 | 改造后 |
|---|---|---|---|
| 认识离心机 | 没有部件介绍页;说明书中的术语第一次出现就在操作流程里 | 预训练 | 第一页放一张带标注的示意图,标出转子、吊篮、盖锁、控制面板和报警装置 |
| 装管与配平 | 一段讲配平的文字,加一张单独的转子照片 | 空间邻近和多媒体 | 一张示意图:离心管对称放置,部件上直接标注,旁边配上解释 |
| 启动运行 | 动画播放时,旁白逐字朗读屏幕上显示的整段文字 | 冗余和通道 | 旁白动画只配简短标签;完整文字移到总结页 |
| 启动运行 | 动画中盖子已经合上,旁白才提到这一步 | 时间邻近 | 动画展示每一步时,旁白同步说出这一步 |
| 每一屏 | 图库照片和背景音乐 | 一致性 | 已删除 |
| 停止并取出样品 | 一段从头播到尾的长旁白 | 分段 | 拆成两段,每段结尾有一个“继续”按钮 |
| 不平衡报警 | 一张列出处理步骤的幻灯片 | 生成活动和信号 | 一个情景模拟,由学员决定处理步骤的顺序,报警灯高亮显示 |
对照梅耶的 15 条原则检查一门旁白课程或视频:包含每一屏要问的问题、每条原则最有效的条件、以离心机课程为例的审查示范,以及可直接使用的空白审查页。可编辑的 Word 文件,无需留邮箱。
课程需求里都提了什么?
为了了解大家如何提出多媒体课程需求,我们对截至 2026 年 10 月 7 日的 90 天内输入 Coursebox 的需求做了抽样分类:每人一条,来自英文浏览器,未上传文件,并剔除了大纲生成前的问答和重复的模板内容。剩下的 266 条提示由一个语言模型分类,其中 112 条是课程需求,我们还人工抽查了它给出的示例。模型的计数较为宽松,因此这些是由模型归类得出的估算值,既不是经过审核的上限,也不代表全部 Coursebox 用户。
最多有一半的课程需求要求把内容拆成短小的模块或片段,这对应的是分段原则中关于课程结构的那部分。
约 28 条要求配图,约 20 条要求减少文字,约 12 条要求视频。提到分段的需求远多于提到旁白的。如果您要给课程生成工具提需求,请说明哪些讲解应以旁白配合图像呈现、屏幕文字起什么作用、哪些内容不要放。否则,这些决定就只能交给工具替您做了。
梅耶的理论与认知负荷理论
梅耶的理论与约翰·斯威勒的认知负荷理论都认为工作记忆容量有限,梅耶也借鉴了后者,但它们是两套独立的理论,各有自己的术语体系。认知负荷理论描述的是材料和设计给学习者带来的负荷;梅耶的理论描述的是学习者对文字和图像进行的加工。梅耶在 2005 年版手册中写道,认知负荷理论“并不关注多媒体学习中涉及的信息加工类型”。两者对冗余的定义也不同:梅耶的定义更窄,而在认知负荷理论中,任何不必要的重复都可能算作冗余。梅耶自己的术语也有过变化:在他 2003 年的论文中,“必要加工”的含义更接近于理解材料。同一份文档里,请只用一套理论的术语。
| 对比项 | 梅耶的多媒体学习认知理论 | 斯威勒的认知负荷理论 |
|---|---|---|
| 核心问题 | 人如何同时从文字和图像中学习? | 材料和设计带来的负荷如何影响学习? |
| 分析单位 | 学习者的加工过程:选择、组织和整合 | 工作记忆承受的负荷 |
| 关键术语 | 外在加工、必要加工和生成性加工 | 内在负荷、外在负荷和相关负荷 |
| 冗余的含义 | 有旁白的图像上重复旁白内容的屏幕文字 | 对该学习者而言任何不必要的信息 |
| 最适合 | 设计幻灯片、视频、旁白和在线学习页面 | 判断学习者需要多少指导、样例和练习 |
这一理论的局限
这一理论在实验室中站得住脚。悬而未决的问题在于长课程、真实工作场所以及效应的大小。
- 大多数检验用的是很短的课程。Ton de Jong 在 2010 年对认知负荷研究的一篇评论中指出,梅耶团队的两项研究所用课程分别只有约 2.5 分钟和 6 分钟,而且这类研究的许多参与者对主题并没有特别的兴趣。梅耶本人在 2024 年的综述中也呼吁开展“在线课程和职业培训”方面的研究。
- 这一理论针对的是学术性讲解。梅耶说它关注的是“学术内容”,大多数检验用的是“系统如何运作”类的讲解。把它用于操作流程、动作技能或态度培养(比如离心机课程),属于外推。
- 在最初开展研究的实验室之外,效应会缩小。Reinwein 的再分析发现,研究由哪个团队开展,是与通道效应大小相关的因素之一。
- 即时收益可能会消退。大多数检验都在课程结束后立即进行,而我找到的唯一一项有延迟测试的职场研究显示,两组差距在缩小。
- 职场证据很少。我没能找到一个经过核实的案例,证明医疗行业以外的私营企业用梅耶的原则重新设计了在线学习课程并衡量了效果。已发表的职场证据主要集中在医疗行业和公共项目中。
- 还有与之竞争的理论。梅耶提到的其中之一是 Wolfgang Schnotz 的图文理解整合模型。

案例:新加坡手术室护士
新加坡邱德拔医院(Khoo Teck Puat Hospital)日间手术中心的围术期护士,必须掌握白内障手术并发症的应对流程。原有的教学幻灯片文字密集,而且越来越多的教学已转到线上。
- 做法:研究人员依据冗余、空间邻近、通道、分段、多媒体、个性化和具身原则制作了电子讲座幻灯片,并配有一个屏幕动画讲解角色,再与图形极少的要点式幻灯片进行比较。两场讲座都约 30 分钟。
- 证据与结果:在一篇 2025 年的预印本中,44 名护士被随机分为两组,各 22 人。讲座刚结束时,改版组在六道题的测试中得分中位数为 6.00,对照组为 4.75(p = 0.02)。四周后,两组差异不再显著(4.50 对 3.75,p = 0.21)。
- 局限:这是一篇未经同行评审的预印本。研究规模小、仅在单一机构开展,测试只有六道题,所有原则同时改动,报告的基线数据也前后不一致。没有人观察护士在手术室中的实际表现。
- 启示:改版组的即时得分更高,但延迟比较的结果并不确定。差异不显著,并不能证明两组记得一样牢或忘得一样多。对于任何需要长期记住的流程,都应安排间隔练习和复训。
用 AI 课程生成工具应用梅耶的原则
2026 年 10 月 7 日,我在 Coursebox 中为离心机课程提交了需求:面向实验室新技术员,涵盖操作流程的六个部分,设计上采用预训练、分段、图文结合、一致性和信号原则。Coursebox 是我们自己的产品,请您在参考我的评价时考虑到这一点。
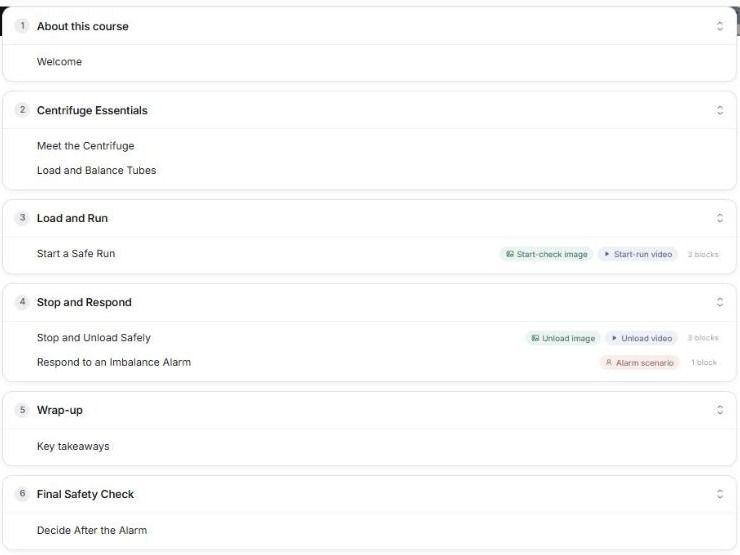
大部分结构都按我的要求生成了。操作流程被拆成了几个短页面:Load and Balance Tubes(装管与配平)、Start a Safe Run(安全启动运行)和 Stop and Unload Safely(安全停止并取出样品)。两个步骤页在大纲中各有三个模块,其中包括一张图片和一段视频:Start a Safe Run 有一张启动检查图片和一段启动运行视频,Stop and Unload Safely 有一张取样图片和一段取样视频。报警处理变成了一个情景模拟 Respond to an Imbalance Alarm(处理不平衡报警),大纲最后是 Final Safety Check(最终安全检查)部分,其中包含 Decide After the Alarm(报警后的决策)。
有一处内容丢了。在我提出某次修改要求之后,大纲里不再有预训练页面,也就是在操作流程之前介绍各个部件的那一页。
我要求把它加回来,命名为 Meet the Centrifuge(认识离心机),放在 Centrifuge Essentials(离心机基础)部分的开头、Load and Balance Tubes 之前。重新加载大纲后,Meet the Centrifuge 已排在 Centrifuge Essentials 的第一位。最终大纲时长约 20 分钟,共 6 个部分、8 个页面,其中包括 About this course 欢迎部分和 Wrap-up 总结部分。这只能确认结构没问题。大纲中 Meet the Centrifuge 页面目前还没有图片模块,所以在学员使用之前,请确认已补上带标注的部件示意图。旁白是否避免了重复屏幕文字、技术员能否安全操作离心机,还需要在生成的课程中以及实验台前进行检验。
规划旁白课程的每一屏时,把图片和旁白配成一组:图片展示什么、旁白讲什么、屏幕标签、提示以及学员要做的动作。附有填好的离心机课程示例和可直接使用的空白页面。可编辑的 Word 文件,无需留邮箱。
把梅耶的原则用起来
回到开头那位技术员:问题不在于不够用心,而在于那一屏同时塞进了照念的文字、装饰图片和东一处西一处的标签,文字和图像在有限的工作记忆里互相争抢。梅耶的多媒体学习认知理论解释了这一点,他的原则则指出该先改什么,其中三条还提醒您,别指望那些并不稳定有效的附加元素。学员是新手、内容复杂、课程从头播到尾,这三种情况下原则最见效,而大量入职培训和合规培训恰好同时符合。如果面对的是有经验的员工、学的是自定节奏的复训课程,收益会小一些,辅助内容也可以相应精简。
不妨从手头一门正在使用的旁白课程开始,只审查其中一屏:图像上是否又叠加了与旁白重复的文字?每个标签是否落在它所指的部件上?屏幕上有哪些东西可以删掉?先改好这三处,再在操作流程前加一页部件介绍,几周后重新测试学员。毕竟,第一次课讲得再好,也替代不了后续的练习。
常见问题
多媒体学习认知理论是理查德·梅耶对人如何从文字和图像中学习的解释,建立在三条假设之上:人有相互独立的言语通道和视觉通道;每个通道一次只能容纳少量信息;学习需要主动加工。由此衍生出 2021 年版《多媒体学习》中的 15 条循证设计原则。
这 12 条原则出自 2009 年第二版《多媒体学习》:多媒体、一致性、信号、冗余、空间邻近、时间邻近、分段、预训练、通道、个性化、声音和图像。2021 年第三版又新增了具身、沉浸和生成活动,共 15 条。
理查德·梅耶与同事从 1989 年开始的实验中发展出这一理论,这一名称出现在他 1996 年至 2000 年的论文中。他借鉴了艾伦·佩维奥的双重编码理论、艾伦·巴德利关于工作记忆的研究、约翰·斯威勒的认知负荷理论,以及梅林·维特罗克的生成性学习理论。
通道原则指出,讲解图像时,用旁白比用屏幕文字效果更好。冗余原则指出,图像已有旁白时,再在屏幕上显示与旁白相同的文字并没有帮助,至少在节奏较快的课程中如此。在图像旁边放简短标签,两条原则都允许。
理查德·梅耶以多媒体学习认知理论及其设计原则闻名,著有《多媒体学习》和《剑桥多媒体学习手册》,并与露丝·克拉克(Ruth Colvin Clark)合著了《e-Learning and the Science of Instruction》。他也是 2001 年修订版布鲁姆教育目标分类法的合著者之一。
Carolina Martin
Carolina Martin 是组织发展和变革管理领域的领导者。凭借在Fortune 500公司的工作经验,她引导各组织完成数字化转型和文化变革,以构建基于强大信任与协作的高绩效团队而闻名。

