

Cognitieve theorie van multimediaal leren: de principes van Mayer
De cognitieve theorie van multimediaal leren van Mayer uitgelegd: de drie aannames, alle 15 principes met effectgroottes, wanneer ze helpen en twee gratis templates.

De cognitieve theorie van multimediaal leren is de verklaring van Richard Mayer voor hoe mensen leren van woorden en beelden. Ze rust op drie aannames: we verwerken verbale en visuele informatie via aparte kanalen, elk kanaal kan maar weinig tegelijk aan en leren vraagt actieve verwerking.
- Het aantal ontwerpprincipes van Mayer groeide van 7 in 2001 naar 12 in 2009 en 15 in de editie van zijn boek uit 2021.
- Drie van Mayers 15 principes laten zien dat een populaire toevoeging niet consequent betere leerresultaten oplevert, zoals het gezicht van de spreker in beeld of virtual reality.
- Het redundantieprincipe raadt af om de gesproken tekst ook nog uit te schrijven naast een afbeelding met gesproken uitleg, vooral in lessen met een hoog tempo.
- De principes van Mayer helpen het meest bij beginners, complexe stof en lessen die in één keer doorlopen, en kunnen ervaren cursisten juist in de weg zitten.
- In een steekproef van 112 cursusaanvragen die in Coursebox waren ingetypt, vroegen er maximaal 57 om korte segmenten en niet meer dan 7 om gesproken uitleg.
Vijf vragen om één cursus mee te plannen. Dit is een niet-gevalideerde checklist. Bekijk elk antwoord afzonderlijk: op basis van de totaalscore kun je niet vaststellen of de cursus goed is afgestemd, klaar is voor gebruik of effectief is.

Ga in enkele minuten van storyboard naar een interactieve cursus
Stel je een nieuwe laborant voor in de eerste werkweek, die door een ingesproken diapresentatie over de tafelcentrifuge van het lab klikt. De stem leest een alinea voor die ook woordelijk op de dia staat, een stockfoto van een lachende onderzoeker vult de halve dia, onder de stem speelt achtergrondmuziek, en het enige schema dat laat zien waar de buisjes moeten, staat op een andere dia dan de uitleg die erbij hoort. Na de video plaatst de laborant de rotor nog steeds uit balans.
Ik werk als instructional designer bij Coursebox. Wij maken software voor instructional design die de briefing van een ontwerper omzet in een cursusopzet met pagina's, afbeeldingen, video en scenario's, dus hoe woorden en beelden samen een scherm delen, is gewoon mijn dagelijkse werk. Met de cognitieve theorie van multimediaal leren van Richard Mayer zie je precies wat er in die video misging, en zijn principes laten zien hoe het beter kan. Hieronder bespreek ik de theorie, alle 15 principes met het onderzoek erachter en de situaties waarin ze het meeste opleveren, en ik laat zien hoe dezelfde centrifugecursus eruitziet als je ze toepast.
Wat is de cognitieve theorie van multimediaal leren?
De cognitieve theorie van multimediaal leren is de verklaring van Richard Mayer voor hoe mensen leren van woorden en beelden. Ze rust op drie aannames: we verwerken verbale en visuele informatie via aparte kanalen, elk kanaal kan maar weinig tegelijk aan en leren vraagt actieve verwerking.
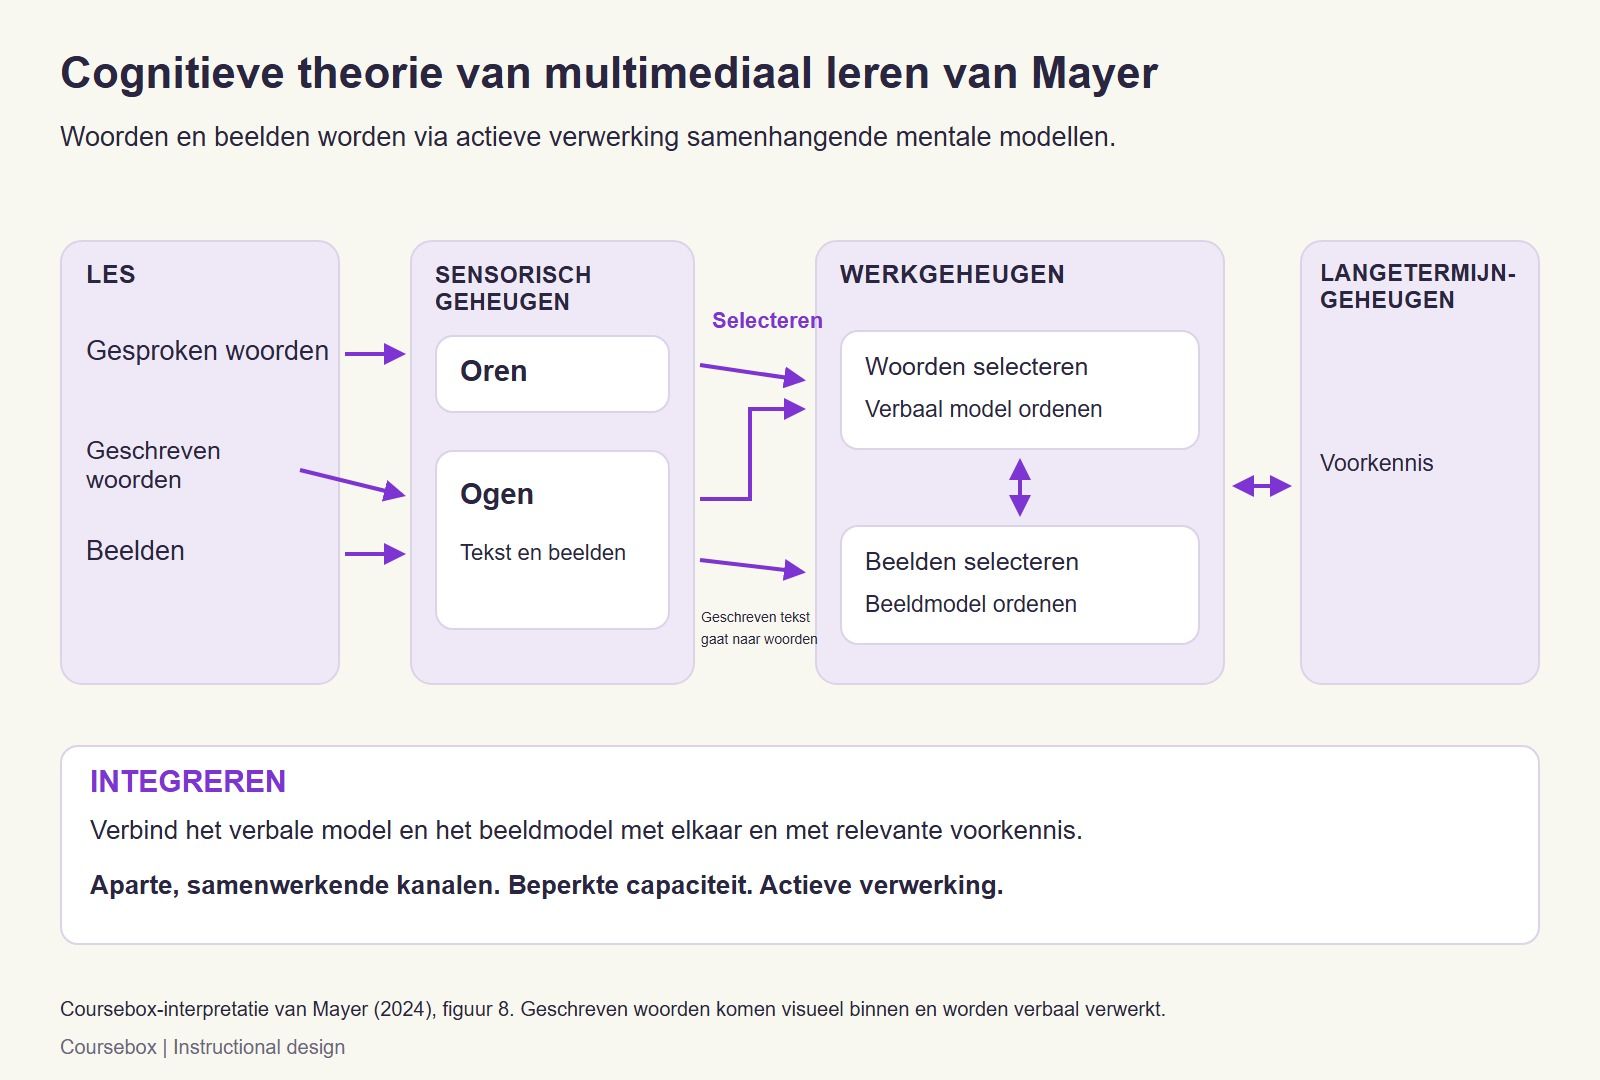
Bekijk het schema op volledige grootte
De theorie gaat over wat Mayer een multimediale instructieboodschap noemt: “instructiemateriaal dat bestaat uit woorden (bijvoorbeeld geschreven of gesproken tekst) en beelden (bijvoorbeeld illustraties, foto's, animatie, video of immersieve virtual reality), bedoeld om bij een lerende nieuwe kennis of vaardigheden op te bouwen”. Die definitie komt uit Mayers overzichtsartikel uit 2024 over het verleden, heden en de toekomst van de theorie, de actuele beschrijving door de bedenker zelf en gratis te lezen. Een diapresentatie met voice-over, een uitlegvideo, een e-learningpagina met een schema en een gedrukte handleiding met illustraties vallen er allemaal onder. Mayer wil verklaren hoe mensen hiermee “theoretische leerstof” leren, gemeten met transfertoetsen: opdrachten waarin mensen het geleerde in nieuwe situaties moeten toepassen.
De drie aannames, in de woorden van Mayer (2024, p. 17):
- Twee kanalen: “mensen hebben afzonderlijke maar samenwerkende kanalen voor het verwerken van auditieve/verbale informatie en beeldmatige/visuele informatie”.
- Beperkte capaciteit: “mensen kunnen in elk kanaal maar een paar stukjes informatie tegelijk verwerken”.
- Actieve verwerking: “betekenisvol leren vindt plaats wanneer de lerende tijdens het leren de juiste cognitieve verwerking uitvoert”. Dat betekent: kiezen waar je op let, dat ordenen en het koppelen aan wat je al weet.
Mayers model verdeelt dit over drie geheugens en vijf processen. Woorden en beelden komen via oren en ogen binnen in het sensorisch geheugen. De lerende kiest een deel van de woorden en beelden uit voor het werkgeheugen, ordent de woorden tot een verbaal model en de beelden tot een beeldmodel, en integreert die twee daarna met elkaar en met voorkennis uit het langetermijngeheugen. Eén detail verklaart veel slecht diaontwerp: geschreven woorden komen via de ogen binnen. Tekst op het scherm concurreert dus met het beeld om hetzelfde visuele kanaal, ook al is het verbale informatie.
Omdat het werkgeheugen beperkt is, onderscheidt Mayer drie soorten belasting tijdens een les (2024, p. 18):
- Overbodige verwerking (extraneous processing) draagt niet bij aan het leerdoel en komt voort uit slecht ontwerp, zoals irrelevante beelden of woorden.
- Essentiële verwerking (essential processing) is het werk dat nodig is om de stof zelf te verwerken, en neemt toe naarmate de stof voor die lerende complexer is.
- Generatieve verwerking (generative processing) is de moeite die iemand doet om de stof te begrijpen, en hangt af van hoe gemotiveerd de lerende is.
Elke soort levert een ontwerpdoel op: overbodige verwerking beperken, essentiële verwerking in goede banen leiden en generatieve verwerking stimuleren. Elk principe dient een van die drie doelen. Het zijn ontwerpcontroles die je tegelijk toepast, geen fasen die je na elkaar doorloopt.
De 15 principes in één overzicht
De tabel is gebaseerd op Mayers eigen samenvatting van de 15 principes uit de derde editie van zijn boek Multimedia Learning (2021), zoals gepubliceerd in tabel 6 van zijn overzichtsartikel uit 2024 onder een CC BY 4.0-licentie. De effectgroottes zijn medianen over de experimenten in Mayers lab, uitgedrukt in Cohens d. Volgens de vuistregel van Cohen is 0,2 een klein effect, 0,5 een middelgroot en 0,8 een groot effect. De kolom Vergelijkingen geeft het aantal experimentele vergelijkingen achter elke mediaan. Ik gebruik Nederlandse namen voor de principes en zet de Engelse naam van Mayer erbij waar dat helpt om ze in de bronnen terug te vinden.
| Doel | Principe | Wat het zegt, in gewone taal | Effectgrootte (2021) | Vergelijkingen |
|---|---|---|---|---|
| Overbodige verwerking beperken | Coherentie (coherence) | Schrap materiaal dat niet bijdraagt aan het doel | 0,86 | 19 |
| Overbodige verwerking beperken | Signalering (signaling) | Voeg aanwijzingen toe die laten zien hoe de kernstof in elkaar zit | 0,69 | 16 |
| Overbodige verwerking beperken | Redundantie (redundancy) | Zet bij een afbeelding met gesproken uitleg niet ook de gesproken tekst op het scherm als de les een hoog tempo heeft | 0,10 | 12 |
| Overbodige verwerking beperken | Ruimtelijke nabijheid (spatial contiguity) | Plaats woorden dicht bij de delen van het beeld die ze beschrijven | 0,82 | 9 |
| Overbodige verwerking beperken | Temporele nabijheid (temporal contiguity) | Bied woorden en de bijbehorende beelden tegelijk aan | 1,31 | 8 |
| Essentiële verwerking in goede banen leiden | Segmentering (segmenting) | Deel een les op in segmenten waarvan de cursist zelf het tempo bepaalt | 0,67 | 7 |
| Essentiële verwerking in goede banen leiden | Pretraining | Leg eerst de namen en kenmerken van de belangrijkste begrippen uit | 0,78 | 10 |
| Essentiële verwerking in goede banen leiden | Modaliteit (modality) | Licht een afbeelding toe met gesproken uitleg in plaats van met tekst op het scherm | 1,00 | 19 |
| Generatieve verwerking stimuleren | Multimedia | Gebruik woorden en beelden in plaats van alleen woorden | 1,35 | 13 |
| Generatieve verwerking stimuleren | Personalisatie (personalization) | Schrijf in een informele, persoonlijke stijl | 1,00 | 15 |
| Generatieve verwerking stimuleren | Stem (voice) | Gebruik een vriendelijke menselijke stem in plaats van een computerstem | 0,74 | 7 |
| Generatieve verwerking stimuleren | Beeld (image) | Het beeld van de spreker toevoegen levert niet consequent betere leerresultaten op | 0,20 | 7 |
| Generatieve verwerking stimuleren | Belichaming (embodiment) | Staat er een instructeur in beeld, laat die dan gebaren, bewegen en oogcontact maken | 0,58 | 17 |
| Generatieve verwerking stimuleren | Immersie (immersion) | 3D-virtual reality levert niet consequent betere leerresultaten op dan dezelfde les op een desktop | -0,10 | 9 |
| Generatieve verwerking stimuleren | Generatieve activiteit (generative activity) | Laat cursisten tijdens het leren samenvatten, uitleggen of zichzelf overhoren | 0,71 | 44 |

Casus: compliancetraining voor apothekers in Houston
In de Verenigde Staten is training in current good manufacturing practice (cGMP) op federaal niveau wettelijk verplicht voor iedereen die in de farmaceutische productie werkt. De standaardtraining bestaat grotendeels uit tekst over regelgeving. Onderzoekers van het University of Houston College of Pharmacy hebben een cGMP-trainingsvideo opnieuw ontworpen en die getest met apothekers in de regio Houston.
- Wat ze deden: Ze pasten de principes van Mayer toe, samen met de cognitieve belastingstheorie en andere aanpassingen in de presentatie. De tekst op het scherm werd teruggebracht tot kernpunten, ongeveer 90% minder dan in de standaardvideo, de uitleg verhuisde naar de gesproken tekst, belangrijke punten uit de regelgeving werden uitgelicht met een contrasterende kleur en onderstreping, en de dia's kregen beeldvullende foto's zonder marges.
- Onderzoek en resultaat: In een gerandomiseerd cross-overonderzoek uit 2026 bekeken 49 apothekers elk één standaardvideo en één herontworpen video in willekeurige volgorde, met direct na elke video een toets. De herontworpen versie scoorde 78% tegenover 72% op de kennistoets (p = 0,04), en de zelf ingeschatte mentale inspanning daalde van 3,5 naar 2,4.
- Beperking: De twee video's behandelden verschillende onderdelen van de regelgeving, dus onderwerp en ontwerp zijn niet volledig van elkaar te scheiden. Het nieuwe ontwerp voegde ook achtergrondmuziek toe aan het begin en einde, wat het coherentieprincipe juist afraadt. Alles werd direct gemeten en niemand controleerde of mensen de regels op de werkvloer naleefden.
- Wat je ervan leert: Een herontwerp dat de tekst op het scherm terugbracht tot kernpunten, de uitleg naar de gesproken tekst verplaatste en de kernpunten uitlichtte, naast andere aanpassingen, ging gepaard met een bescheiden verbetering direct na de training en een flinke daling in ervaren inspanning. Het is een goedkope eerste stap voor compliancevideo's vol dia's, gevolgd door een controle van wat mensen later nog weten.
Wie heeft de theorie ontwikkeld, en hoeveel principes zijn er?
Richard Mayer ontwikkelde de theorie samen met collega's op basis van experimenten die in 1989 begonnen. Hij startte met wat later het multimediaprincipe werd, namelijk dat mensen beter leren van woorden en beelden dan van alleen woorden, en bouwde de theorie op rond de resultaten. Mayer noemt de ideeën waarop hij voortbouwde. De twee kanalen komen uit de duale-coderingstheorie van Allan Paivio en het werkgeheugenmodel van Alan Baddeley. Beperkte capaciteit steunt op George Miller, Baddeley en John Sweller, wiens cognitieve belastingstheorie Mayer omschrijft als een concurrerende theorie waaraan hij ideeën ontleende. Actieve verwerking sluit aan bij het werk van Merlin Wittrock over generatief leren. In zijn overzichtsartikel uit 2024 legt Mayer uit op wie hij voortbouwde.
De naam stond niet meteen vast. In Mayers eigen overzicht komen achtereenvolgens een “model van betekenisvol leren”, een “dual-codingmodel” en het selecteren-ordenen-integreren-model voorbij, en daarna de naam “cognitive theory of multimedia learning” in artikelen uit 1996 tot 2000. Het bekende schema stamt uit de eerste editie van Multimedia Learning uit 2001, en de theorie heeft een eigen hoofdstuk in elke editie van The Cambridge Handbook of Multimedia Learning (2005, 2014 en 2022). Mayer is bovendien een van de auteurs van de herziene taxonomie van Bloom uit 2001.
Hoeveel principes er zijn, hangt af van de editie die je leest. Mayers eigen aantallen, uit tabel 3 en 4 van het overzichtsartikel uit 2024:
| Editie van Multimedia Learning | Principes | Experimentele vergelijkingen | Wat er veranderde |
|---|---|---|---|
| 1e editie, 2001 | 7 | 45 | Multimedia, ruimtelijke nabijheid, temporele nabijheid, coherentie, modaliteit, redundantie en individuele verschillen |
| 2e editie, 2009 | 12 | 93 | Signalering, segmentering, pretraining, personalisatie, stem en beeld toegevoegd; individuele verschillen niet langer een apart principe |
| 3e editie, 2021 | 15 | 201 | Belichaming, immersie en generatieve activiteit toegevoegd |
De “12 principes van Mayer”, de lijst die het vaakst wordt aangehaald, komen uit de tweede editie van 2009: multimedia, coherentie, signalering, redundantie, ruimtelijke nabijheid, temporele nabijheid, segmentering, pretraining, modaliteit, personalisatie, stem en beeld. Die lijst klopt, maar is niet meer actueel. Belichaming hoort bij de editie van 2021, niet bij de twaalf van 2009. Er circuleren ook andere aantallen: Mayers artikel uit 2008 in American Psychologist vatte 10 principes samen, een overzichtsartikel van hem uit 2017 noemt een andere reeks van 12, met belichaming en zonder beeld, en het handboek uit 2022 behandelt 31 principes van tal van onderzoeksgroepen. Zie je een lijst, ga dan na uit welke bron die komt.
Welk werk van Mayer je het beste kunt lezen
- Begin met Mayers vrij toegankelijke overzichtsartikel uit 2024 voor de theorie, de vijftien principes en de reikwijdte van het onderzoek erachter.
- Voor e-learning op de werkvloer lees je e-Learning and the Science of Instruction van Ruth Colvin Clark en Richard Mayer, vijfde editie (2024). Dat boek past de principes toe op het ontwerpen van trainingen.
- Voor al het onderzoek en de randvoorwaarden van elk principe lees je Multimedia Learning, derde editie (2021), uitgegeven door Cambridge University Press.
Het uitgewerkte voorbeeld: een veiligheidscursus voor de centrifuge
Om te laten zien hoe de principes in de praktijk werken, neem ik in de rest van deze gids één fictieve cursus als voorbeeld: de cursus uit de openingsscène. Een laboratorium werkt nieuwe laboranten in, en die moeten leren de tafelcentrifuge van het lab veilig te gebruiken. Sommigen hebben een natuurwetenschappelijke opleiding en sommigen werken in een tweede taal, maar niemand heeft dit model eerder gebruikt en niemand is getraind op het alarm. De procedure bestaat uit zes onderdelen: de buisjes plaatsen, ze in balans brengen, een run starten, de run stoppen, uitladen en reageren op een onbalansalarm. Cursisten krijgen de schriftelijke procedure van het lab en de handleiding van de fabrikant, en de cursus moet hen voorbereiden op een eerste run onder begeleiding aan de werkbank. Het beoogde resultaat: elke laborant kan een rotor in balans laden, een run veilig starten en stoppen en correct op het alarm reageren, beoordeeld door een leidinggevende die meekijkt aan de werkbank.
De huidige training is een ingesproken diapresentatie op basis van de handleiding: volledige alinea's op het scherm die worden voorgelezen, een decoratieve foto op de meeste dia's en het rotorschema op een andere dia dan de stappen waarvoor het nodig is. Een centrifugecursus maakt de meeste principes zichtbaar: cursisten moeten de namen van onderdelen leren, stappen in een vaste volgorde uitvoeren, schema's met labels begrijpen en binnen een bepaalde tijd op een alarm reageren. Tegelijk gaat zo'n cursus verder dan wat de theorie dekt, want Mayer testte vooral uitleg over hoe systemen werken, zoals bliksem, remmen en pompen. De toepassing op procedures en fysieke vaardigheden is een extrapolatie, en aan de werkbank blijkt of die standhoudt.
Overbodige verwerking beperken: vijf principes
Deze vijf principes halen werk weg dat het leren niet helpt, zodat de cursist meer capaciteit overhoudt voor de stof zelf.
Coherentieprincipe
Mensen leren beter als overbodig materiaal wordt weggelaten in plaats van toegevoegd. Overbodig materiaal betekent interessante maar irrelevante woorden, beelden, geluiden en muziek. Coherentie betekent niet “presenteer de stof helder”; dat ligt dichter bij signalering.
- Wat het zegt: Schrap alles wat niet bijdraagt aan het leerdoel.
- Onderzoek en grenzen: Een mediaan effect van 0,86 over 19 experimentele vergelijkingen. Volgens Mayers samenvatting uit 2009 helpt coherentie mogelijk het meest bij cursisten met een kleine werkgeheugencapaciteit of weinig kennis van het onderwerp.
- In de centrifugecursus: Schrap de geschiedenis van de fabrikant, de achtergrondmuziek en de stockfoto's. Houd alleen over wat een laborant nodig heeft om te laden, te starten, te stoppen en te reageren.
Signaleringsprincipe
Mensen leren beter als er aanwijzingen worden toegevoegd die de opbouw van de kernstof laten zien.
- Wat het zegt: Laat cursisten zien waar ze moeten kijken en hoe de onderdelen samenhangen, met kopjes, een overzicht, pijlen of markeringen.
- Onderzoek en grenzen: Een mediaan van 0,69 over 16 experimentele vergelijkingen, tegenover 0,52 over 6 experimentele vergelijkingen in 2008.
- In de centrifugecursus: Open met een overzicht van de zes onderdelen op één scherm, gebruik op elk scherm van een onderdeel hetzelfde kopje, en markeer de dekselvergrendeling en de tegenover elkaar liggende posities van de buisjes op het moment dat de stem ze noemt.
Redundantieprincipe
Mensen leren niet beter als er geschreven tekst wordt toegevoegd aan beeld en gesproken uitleg, in elk geval niet bij een les met een hoog tempo. Het principe wordt vaak gelezen als een verbod op woorden bij beelden, maar dat is het niet.
- Wat het zegt: Wordt een afbeelding al met gesproken uitleg toegelicht, zet die gesproken tekst dan niet ook nog op het scherm.
- Onderzoek en grenzen: Een mediaan van slechts 0,10 over 12 experimentele vergelijkingen, en de formulering van 2021 beperkt het principe tot lessen met een hoog tempo. In hun artikel uit 2003 vonden Mayer en Moreno het omgekeerde als er geen animatie werd getoond: gesproken uitleg plus bijpassende tekst op het scherm hielp juist. Een meta-analyse uit 2012 van 57 studies door Adesope en Nesbit liet zien dat gesproken en geschreven woorden samen hielpen bij cursisten met weinig voorkennis, bij materiaal met een vast tempo en bij materiaal zonder beelden.
- In de centrifugecursus: Laat in de ingesproken animatie van een run alleen de animatie en korte labels zien, zoals “rotor” en “dekselvergrendeling”. Zet de volledige tekst in een transcript of op een samenvattingspagina, niet over de animatie heen.
Het principe zegt niet “gebruik beeld of tekst, nooit allebei” en ook niet “herhaal nooit informatie”. Woorden dicht bij een beeld vallen onder het principe van ruimtelijke nabijheid, en woorden met beelden onder het multimediaprincipe. In het artikel van Mayer en Moreno uit 2003 wordt het redundantie-effect gedefinieerd “in engere zin dan bij Sweller”, namelijk dat je “een onnodige verdubbeling van essentieel materiaal” weglaat: de gesproken tekst die nog eens uitgeschreven over een ingesproken animatie staat. Korte tekst op het scherm naast het onderdeel dat hij benoemt, kan nog steeds helpen.
Principe van ruimtelijke nabijheid
Mensen leren beter als bij elkaar horende woorden en beelden dicht bij elkaar op de pagina of het scherm staan in plaats van ver uit elkaar.
- Wat het zegt: Zet elk label op het onderdeel dat het benoemt, en elke uitleg naast de stap die hij beschrijft.
- Onderzoek en grenzen: Een mediaan van 0,82 over 9 experimentele vergelijkingen in Mayers lab. Een onafhankelijke meta-analyse van 58 vergelijkingen door Schroeder en Cenkci, met 2.426 deelnemers, vond g = 0,63 voor geïntegreerde ontwerpen: kleiner, maar nog steeds duidelijk.
- In de centrifugecursus: Zet de labels voor de rotor, de bekers, de dekselvergrendeling en het alarmlampje op het schema zelf, niet in een legenda eronder. Toon feedback op een quizvraag naast de vraag, niet op een later scherm.
Principe van temporele nabijheid
Mensen leren beter als bij elkaar horende woorden en beelden tegelijk worden aangeboden in plaats van na elkaar.
- Wat het zegt: Benoem elke stap op het moment dat het beeld hem laat zien, niet ervoor of erna.
- Onderzoek en grenzen: De grootste mediaan in de groep overbodige verwerking: 1,31 over 8 experimentele vergelijkingen. Volgens Mayers samenvatting uit 2009 geldt het principe mogelijk minder als een les korte segmenten afwisselt of als de cursist zelf het tempo bepaalt.
- In de centrifugecursus: De stem zegt “sluit het deksel tot de vergrendeling klikt” terwijl de animatie het deksel laat dichtgaan, en niet pas als samenvatting aan het eind van de clip.
Essentiële verwerking in goede banen leiden: drie principes
Sommige stof is voor een nieuwkomer complex, hoe goed die ook is ontworpen. Deze drie principes spreiden die belasting zodat het werkgeheugen niet overloopt.
Segmenteringsprincipe
Mensen leren beter als een multimediale les wordt aangeboden in segmenten waarvan de cursist het tempo bepaalt, in plaats van als één doorlopend geheel.
- Wat het zegt: Deel de les op in zinvolle segmenten en laat cursisten zelf bepalen wanneer ze verdergaan.
- Onderzoek en grenzen: Een mediaan van 0,67 over 7 experimentele vergelijkingen. Het werkzame bestanddeel is dat de cursist het tempo bepaalt. Mayer geeft geen regel voor de lengte van een segment, dus “houd video's onder de tien minuten” is een andere bewering. Volgens zijn samenvatting uit 2009 helpt segmenteren het meest als de stof complex is, de presentatie een hoog tempo heeft en de cursist weinig ervaring heeft.
- In de centrifugecursus: Eén kort segment per scherm, elk afgesloten met een knop Doorgaan. Hetzelfde idee zit achter de meeste microlearningvideo's.

Casus: voedingsvoorlichters in 18 Amerikaanse staten en territoria
Het Expanded Food and Nutrition Education Program (EFNEP) in de Verenigde Staten heeft paraprofessionele voorlichters in dienst die gezinnen met een laag inkomen voorlichting geven over voeding. Ze werken verspreid over veel staten, hebben uiteenlopende opleidingsniveaus en kregen geen standaardtraining: die verschilde per staat.
- Wat ze deden: Een onderzoeker van Colorado State University maakte een online cursus over voeding tijdens de zwangerschap op basis van veertig korte videoclips. Daarbij gebruikte ze de principes multimedia, modaliteit, coherentie, segmentering en personalisatie, samen met een breder instructional-designmodel en rollenspelvideo's. De verteller sprak in een informele stijl, en decoratieve achtergrondmuziek bleef achterwege.
- Onderzoek en resultaat: In een promotieonderzoek uit 2016 werden 139 voorlichters uit 18 staten en territoria per staat ingedeeld bij de cursus of bij een wachtlijst, en van 131 werden de resultaten geanalyseerd (67 en 64). Na de cursus beheerste 92% van de getrainde groep de stof volgens de kennistoets, tegenover 65% van de wachtlijstgroep, en 95% tegenover 75% op een scenariotoets waarin voorlichters in video's slechte voorlichtingspraktijken moesten herkennen.
- Beperking: De vergelijkingsgroep kreeg helemaal geen training, dus het onderzoek laat zien dat de cursus werkte, niet dat de principes van Mayer de winst veroorzaakten. Hoe de voorlichters het in de praktijk deden, werd niet geobserveerd, het vertrouwen in eigen kunnen werd door de deelnemers zelf gerapporteerd en de toetsen hadden een lage interne consistentie.
- Wat je ervan leert: Voor verspreid werkende parttimers bracht een online cursus met korte clips de meeste medewerkers op het vereiste niveau, terwijl ongetrainde collega's dat meestal niet haalden. Toets het beoordelingsvermogen met scenariovragen, niet alleen met reproductie.
Pretrainingsprincipe
Mensen leren beter van een multimediale les als ze de namen en kenmerken van de belangrijkste begrippen kennen. Pretraining is een ontwerpkeuze, geen stelling dat cursisten de basis al moeten kennen.
- Wat het zegt: Leg de onderdelen en termen uit vóór de les die laat zien hoe ze samenwerken.
- Onderzoek en grenzen: Een mediaan van 0,78 over 10 experimentele vergelijkingen.
- In de centrifugecursus: Eerst komt een pagina “Maak kennis met de centrifuge”, met een gelabeld schema van de rotor, de bekers of buishouders, de dekselvergrendeling, het bedieningspaneel en het onbalansalarm, zodat de procedure ernaar kan verwijzen zonder steeds te stoppen voor uitleg.
Modaliteitsprincipe
Mensen leren beter van beeld met gesproken uitleg dan van beeld met tekst op het scherm. Modaliteit en redundantie zijn verschillende regels. Modaliteit vergelijkt gesproken uitleg met geschreven tekst naast een afbeelding. Redundantie gaat over de vraag of je geschreven tekst toevoegt bovenop de gesproken uitleg.
- Wat het zegt: Moet een afbeelding worden toegelicht, spreek de uitleg dan uit in plaats van hem uit te schrijven.
- Onderzoek en grenzen: Een mediaan van 1,00 over 19 experimentele vergelijkingen, en in 2008 schreef Mayer dat dit principe “de meeste steun heeft van alle principes die we hebben onderzocht”. Buiten zijn lab is het effect kleiner, en in een onderzoek van Harskamp en collega's in een echte lessituatie, beschreven door De Jong, verdween het bij lerenden die er zelf de tijd voor namen. Mayers samenvatting uit 2009 voegt toe dat geschreven woorden beter kunnen passen bij lessen met vaktermen en symbolen, en bij cursisten die geen moedertaalspreker zijn.
- In de centrifugecursus: Spreek de animatie van een run in, en laat vaktermen zoals de snelheidsinstelling uitgeschreven staan naast het bedieningspaneel, waar medewerkers die in een tweede taal werken ze kunnen lezen.
Het modaliteitsprincipe geldt voor alle cursisten. Het zegt niets over “auditieve” of “visuele leerders”. In zijn artikel uit 2008 in American Psychologist verwierp Mayer het argument dat geschreven tekst “mensen die liever lezen” laat lezen terwijl anderen luisteren. Zijn eigen lab testte het idee van verbale tegenover visuele leerders: het overzicht van Pashler en collega's uit 2008 meldt dat Massa en Mayer “geen ondersteuning vonden” voor het afstemmen van instructie op voorkeuren, over bijna 20 maten van individuele verschillen. Het bredere onderzoek naar leerstijlen wijst dezelfde kant op.
Generatieve verwerking stimuleren: zeven principes
Deze zeven principes zetten de cursist ertoe aan zich in te spannen om de stof echt te begrijpen.
Multimediaprincipe
Mensen leren beter van woorden en beelden dan van alleen woorden.
- Wat het zegt: Voeg een relevant beeld toe aan de woorden. Een decoratief beeld gaat juist in tegen het coherentieprincipe.
- Onderzoek en grenzen: De grootste mediaan van alle 15: 1,35 over 13 experimentele vergelijkingen. Volgens Mayers samenvatting uit 2009 geldt het principe mogelijk sterker voor cursisten met weinig voorkennis, die hulp nodig hebben om woorden en beelden aan elkaar te koppelen.
- In de centrifugecursus: Een schema van de rotor met vier buisjes in tegenover elkaar liggende posities, naast de woorden die balans uitleggen.
Personalisatieprincipe
Mensen leren beter van multimediale lessen als de woorden een informele, persoonlijke stijl hebben in plaats van een formele.
- Wat het zegt: Spreek de cursist aan met “je” en schrijf zoals een collega het zou uitleggen.
- Onderzoek en grenzen: Een mediaan van 1,00 over 15 experimentele vergelijkingen. Volgens Mayers samenvattingen werkt het mogelijk het best bij beginners en als je het niet overdrijft, en geldt het misschien niet voor lange lessen. Een gerandomiseerd onderzoek uit 2024 met apothekers, artsen en zorgverleners met uitgebreide klinische bevoegdheden (advanced practice providers) voegde personalisatie en belichaming toe aan een module van 30 minuten, en de kennis verschilde niet (Cohens d 0,02), al merkten de deelnemers de aanpassingen wel op.
- In de centrifugecursus: “Zet je tweede buisje recht tegenover het eerste” in plaats van “Buizen dienen in tegenover elkaar gelegen posities te worden geplaatst”.
Stemprincipe
Mensen leren beter als de gesproken tekst wordt ingesproken door een vriendelijke menselijke stem in plaats van een computerstem.
- Wat het zegt: Laat de tekst inspreken door een vriendelijke menselijke stem in plaats van een computerstem.
- Onderzoek en grenzen: Een mediaan van 0,74 over 7 experimentele vergelijkingen, en in 2009 stond het principe nog te boek als voorlopig onderzoek. De bronnen die ik las, testen de AI-stemmen van nu niet, dus het principe geeft geen uitsluitsel over de vraag of een bepaalde synthetische stem goed genoeg is.
- In de centrifugecursus: Laat een of twee laboranten de gesproken tekst vóór de lancering beluisteren, en vervang elke stem die ze moeilijk te volgen vinden.
Beeldprincipe
Mensen leren niet per se beter van een multimediale les als het beeld van de spreker op het scherm wordt toegevoegd.
- Wat het zegt: Een pratend hoofd in beeld levert niet consequent betere leerresultaten op. Een verbod is het ook niet.
- Onderzoek en grenzen: Een mediaan van 0,20 over 7 experimentele vergelijkingen. Mayers handboekhoofdstuk uit 2014 noemde 14 vergelijkingen, waarvan de helft een negatief of verwaarloosbaar effect liet zien.
- In de centrifugecursus: Houd het beeld tijdens de procedure op de centrifuge gericht, niet op het gezicht van de trainer.
Belichamingsprincipe
Mensen verwerken de leerstof diepgaander als een instructeur op het scherm veel gebruikmaakt van gebaren, beweging en oogcontact, in plaats van weinig. Dat bedoelt Mayer met een hoge mate van belichaming. Dit principe is nieuw in de editie van 2021.
- Wat het zegt: Staat er een instructeur in beeld, dan wijst en kijkt die naar wat de cursist moet zien.
- Onderzoek en grenzen: Een mediaan van 0,58 over 17 experimentele vergelijkingen. Het principe beschrijft hoe een instructeur in beeld verschijnt, niet of dat moet, en het onderzoek uit 2024 met zorgprofessionals vond geen significant verschil in kennis toen belichaming samen met personalisatie werd toegevoegd.
- In de centrifugecursus: Doet de labmanager de reactie op het alarm voor de camera voor, dan wijst die naar het alarmlampje en de stopknop terwijl die ze benoemt.
Immersieprincipe
Mensen leren niet per se beter in immersieve 3D-virtual reality dan met een vergelijkbare 2D-presentatie op een desktop. Dit principe is nieuw in de editie van 2021.
- Wat het zegt: Virtual reality verbetert het leren op zichzelf niet ten opzichte van dezelfde les op een scherm.
- Onderzoek en grenzen: Een mediaan van -0,10 over 9 experimentele vergelijkingen, licht in het voordeel van de desktopversie.
- In de centrifugecursus: Een animatie op de desktop en een run onder begeleiding op de echte centrifuge, zonder headset.
Principe van generatieve activiteit
Mensen leren beter als ze tijdens het leren worden begeleid bij generatieve leeractiviteiten. Dit principe is nieuw in de editie van 2021 en heeft de meeste experimenten achter zich.
- Wat het zegt: Laat cursisten iets doen met de stof, zoals samenvatten, het aan zichzelf uitleggen of zichzelf overhoren.
- Onderzoek en grenzen: Een mediaan van 0,71 over 44 experimentele vergelijkingen. Fiorella en Mayer (2016) beschrijven acht activiteiten: samenvatten, in kaart brengen, tekenen, verbeelden, zelftoetsing, zelfuitleg, uitleggen aan anderen en naspelen.
- In de centrifugecursus: Na het segment over balans kiezen cursisten waar het vierde buisje moet en leggen ze uit waarom. Het onderdeel over het alarm sluit af met een kort scenario waarin ze beslissen wat ze doen en in welke volgorde. Ook ideeën voor interactieve e-learningmodules passen op deze plek.
In de praktijk bekijk ik één scherm en stel ik vier vragen tegelijk: wat kan er weg (coherentie), waar moet het oog naartoe (signalering), staan de woorden naast het beeld (ruimtelijke nabijheid) en staat de gesproken tekst ook uitgeschreven (redundantie). Zo vang je in één ronde problemen die je mist als je principe voor principe kijkt.
Hoe sterk is het onderzoek achter de principes?
De principes rusten op meer dan 200 experimenten, maar veel daarvan waren korte lessen in Mayers lab, en een aantal effecten wordt kleiner naarmate er meer onderzoek bijkomt. Houd drie punten in gedachten voordat je de cijfers aan stakeholders voorlegt.
Ten eerste gaan drie van de 15 principes over populaire toevoegingen die niet consequent betere leerresultaten opleveren: geschreven tekst bij een afbeelding met gesproken uitleg (0,10, en alleen bij lessen met een hoog tempo), het beeld van de spreker (0,20) en virtual reality (-0,10).
Ten tweede zijn sommige effecten kleiner geworden naarmate er meer onderzoek kwam.
De bronnen die ik las, verklaren niet waarom het redundantie-effect kleiner werd, dus daar ga ik niet naar gissen. Het modaliteitseffect laat buiten zijn lab hetzelfde patroon zien. Een heranalyse door Reinwein uit 2012 verdubbelde de onderzoeksbasis van een eerdere meta-analyse van Ginns, die d = 0,72 had gevonden over 43 effecten.
Ten derde ondersteunen onafhankelijke reviews nog steeds de kern van de theorie. In een overzicht van reviews uit 2022 door Noetel en collega's melden de auteurs 29 reviews met samen 1.189 studies en 78.177 deelnemers, met de grootste winst voor temporele en ruimtelijke nabijheid en signalering. Dezelfde samenvatting stelt dat goed ontwerp belangrijker was bij complexe stof en in situaties met een vast tempo, zoals hoorcolleges, dan wanneer mensen in hun eigen tempo werken.
Gebruik het onderzoek om ontwerpaanpassingen te vinden die het proberen waard zijn, vooral een duidelijker verband tussen labels, beelden en gesproken uitleg. Effectgroottes vatten verschillende experimentele vergelijkingen samen. Ze vormen geen ranglijst van oplossingen die je onderling kunt uitwisselen en voorspellen niet het resultaat van jouw cursus. Controleer de relevante randvoorwaarden en test het nieuwe ontwerp met je cursisten.
Wanneer helpen de principes van Mayer het meest?
In zijn overzichtsartikel uit 2024 schrijft Mayer dat elk principe randvoorwaarden heeft: “voor wie het principe geldt, voor welk soort les het principe geldt en onder welke omstandigheden”. Drie voorwaarden komen steeds terug.
- De cursist is nog niet vertrouwd met het onderwerp. Het principe van individuele verschillen uit de eerste editie stelde dat ontwerpeffecten sterker zijn bij cursisten met weinig voorkennis, die gaten niet kunnen opvullen met wat ze al weten.
- De stof is complex voor deze cursist. Segmenteren en modaliteit helpen het meest als er veel tegelijk te onthouden valt.
- De les loopt in een vast tempo. Een video die in één keer doorloopt of een live webinar laat geen tijd om iets terug te lezen of opnieuw af te spelen. Bepalen cursisten zelf het tempo, dan zijn de ontwerpeffecten in de studies kleiner.
Het omgekeerde geldt ook. In een artikel uit 2003 gaven Kalyuga en collega's het expertise-omkeringseffect een naam: “Instructietechnieken die zeer effectief zijn bij onervaren lerenden, kunnen hun effectiviteit verliezen en zelfs negatieve gevolgen hebben als ze bij meer ervaren lerenden worden ingezet”. In een van hun voorbeelden hadden onervaren elektrotechnische trainees tekst nodig die in de schakelschema's was verwerkt, terwijl ervaren trainees beter presteerden met alleen het schema. Ook gesproken uitleg kan voor ervaren cursisten overbodig worden.
Zo vertaal ik die voorwaarden naar de centrifugecursus. De tabel is mijn eigen synthese van de bronnen, geen advies van Mayer zelf.
| Situatie | Principes met voorrang | Wat je kunt afbouwen |
|---|---|---|
| Nieuwe laboranten, ingesproken video die in één keer doorloopt | Pretraining, segmentering, modaliteit, ruimtelijke en temporele nabijheid, signalering | Weinig; hier heeft ontwerp het meeste effect |
| Ervaren laboranten, opfriscursus in eigen tempo | Coherentie en generatieve activiteit | Volledige gesproken uitleg en stap-voor-staplabels die ze niet meer nodig hebben |
| Lessen vol vaktermen, of medewerkers die in een tweede taal werken | Ruimtelijke nabijheid, met kerntermen uitgeschreven naast het beeld | Uitleg van nieuwe termen die alleen gesproken wordt |
| Cursisten die doof of slechthorend zijn | Ondertiteling en transcripten, plus ruimtelijke nabijheid | Het redundantieprincipe, dat niet boven toegankelijkheid gaat |
Zorg bij vooraf opgenomen video met gesproken uitleg altijd voor nauwkeurige, gesynchroniseerde ondertiteling. Een transcript is een nuttige aanvulling, maar vervangt gesynchroniseerde ondertiteling niet. Het redundantieprincipe gaat over specifieke vergelijkingen in instructie en gaat niet boven toegankelijkheidsbehoeften. Gebruik korte labels in de afbeelding, ondertiteling die cursisten zelf kunnen aanzetten en een passend tekstalternatief voor visuele informatie.
Zo gebruik je de principes van Mayer om een les te ontwerpen of te beoordelen
Begin bij de cursisten en de manier van aanbieden, bepaal dan de opbouw en controleer daarna elk scherm. Dit is de volgorde die ik aanhoud:
- Zoek uit wat cursisten al weten. Vraag het, test het of bekijk hun werk, en leid kennis niet af uit een functietitel. Voorkennis bepaalt hoeveel de principes opleveren.
- Bepaal hoe de les verloopt. Ga na of hij in één keer doorloopt, zoals een webinar of een video, of dat cursisten zelf het tempo bepalen.
- Leg onbekende onderdelen en termen uit vóór de les die erop voortbouwt, en gebruik zinvolle segmenten in het tempo van de cursist waar de vorm dat toelaat. Cursisten die de termen al kennen, hebben misschien geen aparte pretrainingspagina nodig.
- Plan voor elk scherm het beeld en de gesproken uitleg samen: wat laat het beeld zien en wat zegt de stem? Beperk geschreven woorden tot labels en kerntermen, naast wat ze benoemen.
- Schrap wat niet bijdraagt aan het doel en markeer wat wel bijdraagt. Haal decoratieve beelden, muziek en zijpaden weg, en voeg markeringen of kopjes toe voor wat cursisten moeten opmerken.
- Voeg tussen segmenten een generatieve activiteit toe. Denk aan een voorspelling, een uitleg of een kort scenario.
- Draai een pilot en controleer na een tijdje opnieuw. Test wat cursisten een paar weken later kunnen, niet alleen aan het eind van de les.
De centrifugecursus, scherm voor scherm
| Scherm | Voor | Principe | Na |
|---|---|---|---|
| Maak kennis met de centrifuge | Geen pagina met onderdelen; de termen uit de handleiding verschijnen pas in de procedure | Pretraining | Een eerste pagina met een gelabeld schema van de rotor, bekers, dekselvergrendeling, het bedieningspaneel en het alarm |
| Laden en balanceren | Een alinea over balans en een losse foto van de rotor | Ruimtelijke nabijheid en multimedia | Eén schema met buisjes in tegenover elkaar liggende posities, labels op de onderdelen en de uitleg ernaast |
| Een run starten | De verteller leest de volledige uitgeschreven alinea voor over de animatie | Redundantie en modaliteit | Ingesproken animatie met alleen korte labels; de volledige tekst staat op een samenvattingspagina |
| Een run starten | In de animatie gaat het deksel dicht voordat de stem het noemt | Temporele nabijheid | De stem benoemt elke stap op het moment dat de animatie hem laat zien |
| Elk scherm | Stockfoto's en achtergrondmuziek | Coherentie | Verwijderd |
| Stoppen en uitladen | Eén lange ingesproken reeks die in één keer doorloopt | Segmentering | Twee segmenten, elk afgesloten met een knop Doorgaan |
| Onbalansalarm | Een dia met een lijst van wat je moet doen | Generatieve activiteit en signalering | Een scenario waarin de cursist de volgorde van de handelingen bepaalt, met het alarmlampje uitgelicht |
Toets een ingesproken les of video aan de 15 principes van Mayer, met per scherm de vraag die je stelt, de omstandigheden waarin elk principe het meest helpt, de centrifugecursus als uitgewerkt voorbeeld en lege auditpagina's om zelf te gebruiken. Bewerkbaar Word-bestand, geen e-mailadres nodig.
Wat vragen gebruikers in hun cursusaanvragen?
Om te zien hoe mensen een briefing voor een multimediale cursus schrijven, hebben we een steekproef geclassificeerd van aanvragen die in de 90 dagen tot 7 oktober 2026 in Coursebox zijn ingetypt: één per persoon, vanuit Engelstalige browsers, zonder geüpload bestand, en zonder antwoorden vóór de cursusopzet en dubbele templates. Een taalmodel classificeerde de 266 prompts die overbleven, waarvan er 112 cursusaanvragen waren, en we hebben de voorbeelden steekproefsgewijs met de hand gecontroleerd. Het model rekende ruim, dus dit zijn door het model gecodeerde schattingen, geen gecontroleerde bovengrenzen en geen schattingen voor alle gebruikers van Coursebox.
Tot ongeveer de helft van de cursusaanvragen vroeg om inhoud die is opgedeeld in korte modules of stukken, en dat is de structurele helft van segmenteren.
Ongeveer 28 vroegen om beeldmateriaal, ongeveer 20 om minder tekst en ongeveer 12 om video. In de aanvragen ging het veel vaker over opdelen in stukken dan over gesproken uitleg. Geef je een cursusmaker een briefing, zeg dan welke uitleg ingesproken moet worden bij een afbeelding, waar de tekst op het scherm voor dient en wat er weg kan. Anders worden die keuzes voor je gemaakt.
De theorie van Mayer en de cognitieve belastingstheorie
De theorie van Mayer en de cognitieve belastingstheorie van John Sweller delen het idee van een beperkt werkgeheugen, en Mayer heeft er ideeën aan ontleend, maar het zijn aparte theorieën met elk een eigen terminologie. De cognitieve belastingstheorie beschrijft de belasting die stof en ontwerp opleggen aan de lerende. De theorie van Mayer beschrijft de verwerking die de lerende uitvoert met woorden en beelden, en in het handboek uit 2005 schreef hij dat de cognitieve belastingstheorie “zich niet richt op de soorten informatieprocessen die bij multimediaal leren een rol spelen”. De twee definiëren redundantie verschillend. De versie van Mayer is smaller, terwijl in de cognitieve belastingstheorie elke onnodige herhaling redundant kan zijn. Ook Mayers eigen termen zijn verschoven: in zijn artikel uit 2003 betekende “essentiële verwerking” iets wat dichter ligt bij het begrijpen van de stof. Gebruik per document de terminologie van één theorie.
| Kenmerk | Cognitieve theorie van multimediaal leren (Mayer) | Cognitieve belastingstheorie (Sweller) |
|---|---|---|
| Hoofdvraag | Hoe leren mensen van woorden en beelden samen? | Hoe beïnvloedt de belasting door stof en ontwerp het leren? |
| Analyse-eenheid | De verwerking door de lerende: selecteren, ordenen en integreren | De belasting van het werkgeheugen |
| Kernbegrippen | Overbodige, essentiële en generatieve verwerking | Intrinsieke, extrinsieke en germane belasting |
| Redundantie betekent | Geschreven tekst die de gesproken uitleg bij een afbeelding herhaalt | Alle informatie die voor die lerende overbodig is |
| Het meest geschikt voor | Het ontwerpen van dia's, video, gesproken uitleg en e-learningschermen | Bepalen hoeveel begeleiding, uitgewerkte voorbeelden en oefening cursisten nodig hebben |
Beperkingen van de theorie
In het lab houdt de theorie goed stand. De open vragen gaan over lange cursussen, echte werkplekken en de grootte van de effecten.
- De meeste experimenten gebruikten zeer korte lessen. In een kritische analyse uit 2010 van het onderzoek naar cognitieve belasting merkte Ton de Jong op dat twee studies van Mayers groep lessen van ongeveer 2,5 en 6 minuten gebruikten, en dat veel deelnemers aan dit onderzoek geen bijzondere interesse in het onderwerp hebben. In zijn overzichtsartikel uit 2024 roept Mayer zelf op tot onderzoek in “online cursussen en professionele training”.
- De theorie gaat over uitleg van theoretische leerstof. Mayer zegt zelf dat ze gaat over “theoretische leerstof”, en de meeste experimenten gebruikten uitleg over hoe systemen werken. De theorie toepassen op procedures, fysieke vaardigheden of houdingen, zoals in de centrifugecursus, is een extrapolatie.
- Effecten worden kleiner buiten het lab waar ze zijn ontdekt. Uit de heranalyse van Reinwein bleek dat de onderzoeksgroep een van de factoren was die samenhing met de grootte van het modaliteitseffect.
- Directe winst kan wegebben. De meeste experimenten meten direct na de les, en het ene onderzoek op de werkvloer dat ik vond met een latere meting laat zien dat het verschil kleiner wordt.
- Bewijs uit de werkpraktijk is schaars. Ik heb geen geverifieerd voorbeeld gevonden van een commercieel bedrijf buiten de zorg dat zijn e-learning met de principes van Mayer heeft herontworpen en het resultaat heeft gemeten. Het gepubliceerde bewijs uit de werkpraktijk komt vooral uit de zorg en publieke programma's.
- Er zijn concurrerende verklaringen. Mayer noemt als voorbeeld het geïntegreerde model van tekst- en beeldbegrip van Wolfgang Schnotz.

Casus: operatieverpleegkundigen in Singapore
Perioperatieve verpleegkundigen in het Day Surgery Centre van het Khoo Teck Puat Hospital in Singapore moeten een protocol leren voor het reageren op complicaties tijdens een staaroperatie. De bestaande instructiedia's waren tekstzwaar, en een steeds groter deel van de scholing was online komen te staan.
- Wat ze deden: Onderzoekers maakten dia's voor een online college op basis van de principes redundantie, ruimtelijke nabijheid, modaliteit, segmentering, multimedia, personalisatie en belichaming, met een geanimeerde agent in beeld, en vergeleken die met dia's met opsommingstekens en weinig beeldmateriaal. Beide colleges duurden ongeveer 30 minuten.
- Onderzoek en resultaat: In een preprint uit 2025 werden 44 verpleegkundigen gerandomiseerd in twee groepen van 22. Direct na het college scoorde de groep met het nieuwe ontwerp een mediaan van 6,00 tegenover 4,75 op een toets van zes vragen (p = 0,02). Vier weken later verschilden de groepen niet meer significant (4,50 tegenover 3,75, p = 0,21).
- Beperking: Het is een preprint die nog niet door vakgenoten is beoordeeld. Het is een klein onderzoek op één locatie, de toets had maar zes vragen, alle principes veranderden tegelijk en de gerapporteerde uitgangswaarden zijn niet consistent. Niemand heeft de verpleegkundigen in de operatiekamer geobserveerd.
- Wat je ervan leert: De groep met het nieuwe ontwerp scoorde direct hoger, maar de latere vergelijking was niet doorslaggevend. Een niet-significant verschil betekent niet dat beide groepen evenveel onthielden of evenveel vergaten. Plan gespreide oefening en een opfrissessie voor elk protocol dat mensen moeten onthouden.
De principes van Mayer toepassen met een AI-cursusmaker
Op 7 oktober 2026 gaf ik Coursebox een briefing voor de centrifugecursus: nieuwe laboranten, de zes onderdelen van de procedure en een ontwerp gebaseerd op pretraining, segmentering, woorden en beelden samen, coherentie en signalering. Het is ons eigen product, dus weeg mijn oordeel met dat in je achterhoofd.
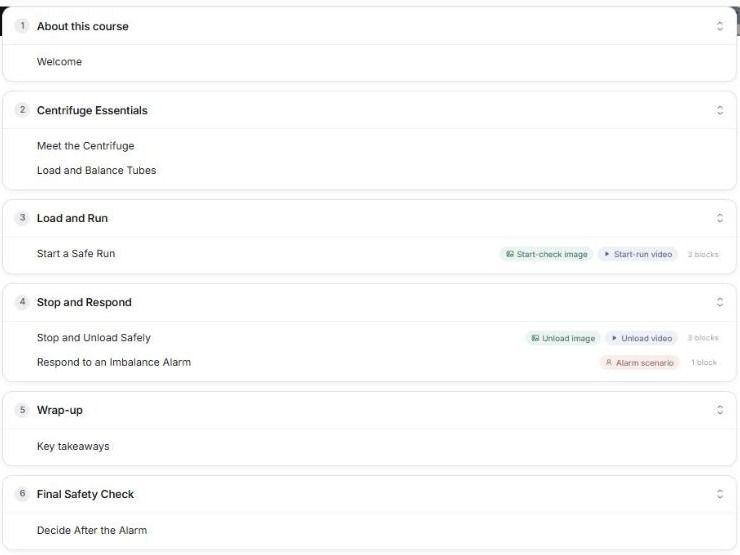
Het grootste deel van de opbouw kwam terug zoals ik had gevraagd. De procedure was opgedeeld in korte pagina's: Load and Balance Tubes, Start a Safe Run en Stop and Unload Safely. Beide stappagina's hadden drie blokken in de cursusopzet, waaronder een afbeelding en een video. Start a Safe Run had een Start-check-afbeelding en een Start-run-video, en Stop and Unload Safely een Unload-afbeelding en een Unload-video. De reactie op het alarm werd een scenario, Respond to an Imbalance Alarm, en de cursusopzet eindigt met een onderdeel Final Safety Check met daarin Decide After the Alarm.
Eén ding raakte zoek. Na een van mijn verzoeken om aanpassing bevatte de cursusopzet de pretrainingspagina niet meer, de pagina die de onderdelen benoemt vóór de procedure.
Ik vroeg om die pagina terug als Meet the Centrifuge, aan het begin van het onderdeel Centrifuge Essentials en vóór Load and Balance Tubes. Toen ik de cursusopzet opnieuw laadde, stond Meet the Centrifuge als eerste in Centrifuge Essentials. De uiteindelijke cursusopzet besloeg ongeveer 20 minuten, verdeeld over 6 onderdelen en 8 pagina's, met een welkomstonderdeel About this course en een afsluitend onderdeel Wrap-up. Dat bevestigt alleen de opbouw. In de cursusopzet staat nog geen afbeeldingsblok bij Meet the Centrifuge, dus controleer of er een gelabeld schema van de onderdelen bij komt voordat cursisten ermee aan de slag gaan. Of de gesproken tekst de tekst op het scherm niet herhaalt en of laboranten de centrifuge veilig kunnen bedienen, moet je controleren in de gegenereerde cursus en aan de werkbank.
Plan voor elk scherm van een ingesproken les het beeld en de gesproken uitleg samen. Leg vast wat het beeld laat zien, wat de stem zegt, welke labels en aanwijzingen op het scherm staan en wat de cursist doet. Met de centrifugecursus als ingevuld voorbeeld en lege pagina's om zelf te gebruiken. Bewerkbaar Word-bestand, geen e-mailadres nodig.
De principes van Mayer in de praktijk
Zet je voorgelezen tekst, decoratie en verspreide labels allemaal op één scherm, dan vechten woorden en beelden om plek in een klein werkgeheugen en blijft er minder hangen. Dat is in de kern wat de cognitieve theorie van multimediaal leren van Mayer verklaart. De principes wijzen aan welke aanpassingen je kunt proberen, en drie ervan waarschuwen juist voor toevoegingen die niet consequent betere leerresultaten opleveren. Ze leveren het meeste op als cursisten nog niet vertrouwd zijn met het onderwerp, de stof complex is en de les in één keer doorloopt, en dat geldt voor veel onboarding- en compliancetrainingen. Gaat het om ervaren medewerkers die een opfriscursus in eigen tempo volgen, reken dan op minder winst en bouw de ondersteuning af.
Begin klein: neem een ingesproken les die je al gebruikt en bekijk één scherm. Staat de gesproken tekst ook nog over de afbeelding heen? Zit elk label op het onderdeel dat het benoemt? Wat kan er weg? Pak die drie punten aan, zet vóór de procedure een pagina die de onderdelen benoemt en toets je cursisten een paar weken later opnieuw. Een betere eerste les vervangt oefenen namelijk niet.
Veelgestelde vragen
De cognitieve theorie van multimediaal leren is de verklaring van Richard Mayer voor hoe mensen leren van woorden en beelden. Ze rust op drie aannames: we verwerken verbale en visuele informatie via aparte kanalen, elk kanaal kan maar weinig tegelijk aan en leren vraagt actieve verwerking. Daaruit volgen 15 onderbouwde ontwerpprincipes in de editie van 2021 van zijn boek Multimedia Learning.
De 12 principes komen uit de tweede editie van Multimedia Learning uit 2009: multimedia, coherentie, signalering, redundantie, ruimtelijke nabijheid, temporele nabijheid, segmentering, pretraining, modaliteit, personalisatie, stem en beeld. De derde editie uit 2021 voegt belichaming, immersie en generatieve activiteit toe, wat het totaal op 15 brengt.
Richard Mayer ontwikkelde de theorie samen met collega's op basis van experimenten die in 1989 begonnen, en de naam duikt op in zijn artikelen uit 1996 tot 2000. Hij bouwde voort op de duale-coderingstheorie van Allan Paivio, het werk van Alan Baddeley over het werkgeheugen, de cognitieve belastingstheorie van John Sweller en het generatieve leren van Merlin Wittrock.
Het modaliteitsprincipe zegt dat je een afbeelding beter kunt toelichten met gesproken uitleg dan met tekst op het scherm. Het redundantieprincipe zegt dat het niet helpt om bij een afbeelding met gesproken uitleg dezelfde tekst ook nog op het scherm te zetten, in elk geval niet bij lessen met een hoog tempo. Korte labels naast de afbeelding zijn volgens beide principes prima.
Richard Mayer staat bekend om de cognitieve theorie van multimediaal leren en de ontwerpprincipes die daaruit volgen, om de boeken Multimedia Learning en The Cambridge Handbook of Multimedia Learning, en om e-Learning and the Science of Instruction, dat hij samen met Ruth Colvin Clark schreef. Hij is bovendien een van de coauteurs van de herziene taxonomie van Bloom uit 2001.
Carolina Martin
Carolina Martin is een operationeel specialist en bedrijfsstrateeg gericht op Latijns-Amerikaanse en Europese markten. Ze heeft supply chain- en procesoptimalisatieprojecten geleid voor multinationale bedrijven.

